IA en Kubernetes: del corpus a una API que genera tokens
Construye datos, entrenamiento, checkpoints, publicación e inferencia: laboratorio CPU probado, GPT-2 opcional y manifiestos Kubernetes.
Fuentes y versiones
En este artículo
Arquitectura y responsabilidades
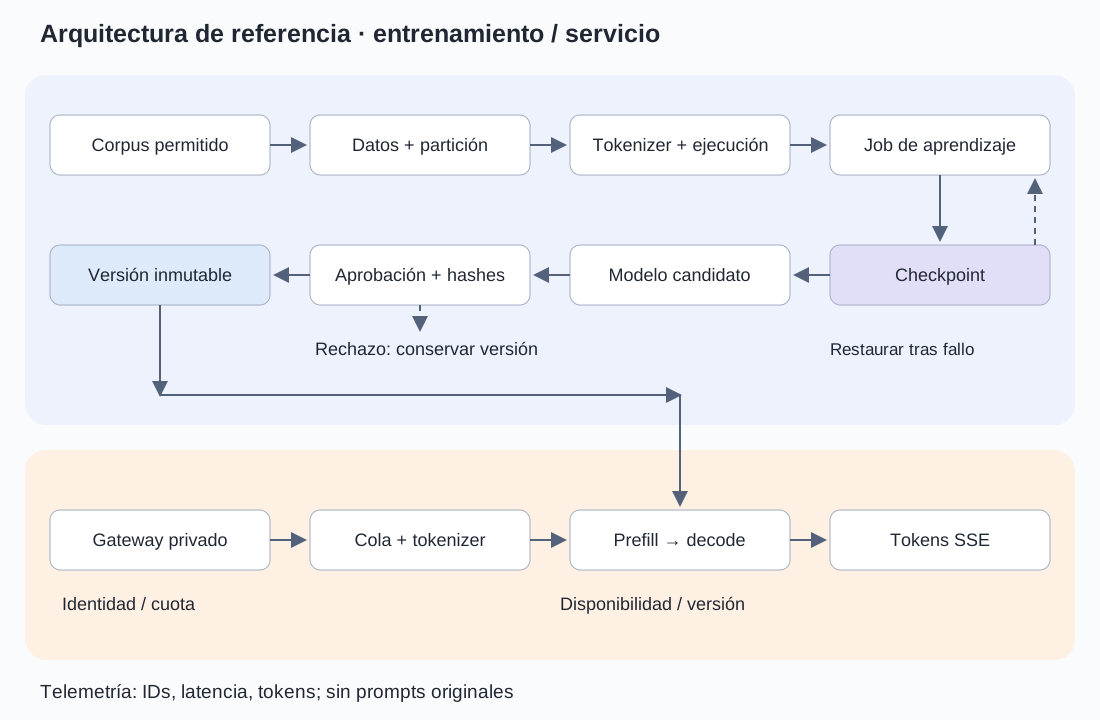
| Etapa | Entrada → salida | Responsable y límite |
|---|---|---|
| Ingesta | Registros → snapshot inmutable | Datos: rechazar entradas sin permiso o malformadas; cuarentena explícita. |
| Preparación | Snapshot → partición + tokenizer | Ingeniería de datos: esquema, duplicados y fugas; reintentar sin cambiar partición. |
| Entrenamiento | Datos + configuración → checkpoint | Entrenamiento: restaurar todos los ranks; nunca elegir un checkpoint incompleto. |
| Publicación | Candidato + evidencia → versión aprobada | Modelo: rechazo no reemplaza servicio actual; guardar versión de criterio. |
| Servicio | Pesos/tokenizer → réplica lista | Plataforma: hashes antes de cargar y calentar; excluir réplica fallida. |
| Solicitud | Prompt autorizado + presupuesto → flujo | Gateway/motor: límites y cancelación; no repetir salida observada. |
Empieza por el contrato del servicio
Construiremos un servicio privado de completado entrenado con un corpus versionado. Fuera de línea: registros autorizados, dataset, tokenizer, entrenamiento, checkpoint y versión aprobada. En línea: identidad, presupuesto, tokens, ejecución y respuesta. Kubernetes programa procesos; calidad de datos, calidad del modelo y permisos necesitan contratos propios.
El kit cierra el ciclo con un modelo bigrama aprendido y ejecutado localmente: entrenamiento, reanudación exacta, integridad, HTTP y streaming. Incluye además entrenamiento GPT-2 de dos capas y una referencia vLLM no ejecutados aquí. No hay Docker, clúster ni GPU disponibles. El laboratorio CPU no equivale a una plataforma GPU productiva ni a un asistente útil.
Sigue el documento d17: snapshot R1, limpieza C2, dataset D3, tokenizer T1, ejecución J4, checkpoint K400 y export M1. La versión R7 vincula M1, T1, digest de imagen y límites. La solicitud q9 resuelve el alias a R7 una sola vez. El plano de control cambia versiones y políticas; el de datos mueve bytes y calcula. Un registro guarda referencias y evidencia, no procesos GPU. Service enruta a réplicas, no checkpoints. Cambiar un alias no significa completar el despliegue.
Prerrequisitos que explican fallos
Una imagen contiene código y bibliotecas, no un driver GPU anfitrión compatible. Pod es unidad de ejecución; Job sigue terminación; Deployment mantiene réplicas; Service selecciona endpoints. PVC solicita almacenamiento con restricciones de acceso y topología. Reiniciar sin cursor de datos ni estado del optimizador no recupera necesariamente el entrenamiento.
Un token es un entero de un tokenizer concreto; logits son scores, softmax probabilidades y entropía cruzada una pérdida. Entrenar actualiza pesos; inferir los conserva. Un checkpoint reanudable contiene más estado que una exportación. Consistencia, HTTP, TLS, identidad y métricas determinan qué modelo responde a quién.
kubectl envía el Job al API server: autenticación, autorización, admisión y persistencia del estado deseado. Controladores crean Pods; scheduler elige nodo según solicitudes, restricciones y topología de volúmenes. Kubelet inicia contenedores mediante el runtime. Device plugins anuncian GPU y CSI prepara volúmenes. El optimizador corre dentro del contenedor. Running no equivale a modelo listo: readiness controla elegibilidad del Service. Startup probe evita reinicios prematuros durante inicialización; fallar readiness no reinicia por sí mismo el contenedor.
Ingesta: registros antes de ventanas
Cada fuente necesita ID, permiso, fecha, hash y retención. Conserva una instantánea bruta y versiona limpieza y código. Respeta tablas, código y límites documentales. Separa duplicados exactos de aproximados y divide por fuente, usuario o tiempo antes de crear ventanas solapadas. Un reparto por hash es repetible, pero no agrupa documentos relacionados.
El kit usa JSONL sintético CC0, normalización de espacios, deduplicación exacta y manifiestos de hashes. Producción añade privacidad, consentimiento, cuarentena, equilibrio de fuentes y borrados propagados. Un catálogo registra linaje, no autoriza entrenamiento. Borrar objetos no borra lo aprendido en los pesos; puede exigir retirar datos y reentrenar.
Confirma el offset de origen solo después de persistir objeto y entrada de manifiesto con un protocolo definido. Un reintento puede reescribir el mismo objeto direccionado por contenido; otra transformación crea otra identidad. Hash no prueba similitud, consentimiento ni calidad. Agrupa casi duplicados antes de dividir. Hash módulo 5 da 20% esperado, no exacto. 100 GB originales y 60 GB derivados requieren al menos 160 GB sin réplicas ni checkpoints. Shards en streaming limitan memoria; compresión, tamaño y orden determinan CPU y amplificación de lectura.
Tokenizer, empaquetado y contrato
La versión debe incluir vocabulario, normalización, IDs especiales y plantilla de chat cuando corresponda. Cambiar tokenizer altera IDs silenciosamente. La ruta Transformer aprende BPE de bytes solo en entrenamiento, añade EOS y excluye padding. Empaquetar documentos ahorra trabajo pero exige decidir si la atención cruza sus límites.
IDs y etiquetas tienen forma B×T; logits B×T×V. El objetivo causal predice el siguiente token. El modelo Hugging Face suministrado desplaza etiquetas internamente: copia IDs y usa−100 para padding, sin segundo desplazamiento. Valida con el mismo contrato y pondera la pérdida por tokens válidos.
Ejemplo inventado: “AI helps”→[17,42],
Qué calcula el entrenamiento
El forward aplica embeddings y capas causales para producir logits; la pérdida penaliza baja probabilidad del siguiente token. Backpropagation calcula derivadas; AdamW conserva momentos y actualiza pesos. La acumulación exige escalar la pérdida: microbatch 2×8 acumulaciones×4 réplicas produce 64 secuencias por actualización, no necesariamente igual número de tokens.
La base medida aprende una tabla V×V dependiente solo del carácter anterior: modelo autorregresivo real, sin atención. GPT-2 opcional usa 2 capas,4 cabezas y anchura 128. Enseña empaquetado, no calidad lingüística. Preentrenamiento, SFT, preferencias y RL necesitan datos, referencias y recursos distintos; servir rollouts no equivale a ejecutar el optimizador.
En la pérdida, b indexa secuencias, t predicciones, m vale 1 para objetivos válidos y 0 para padding; N_valid suma m. B_micro cuenta secuencias por réplica, A acumulaciones y D réplicas. Promediar microbatches por igual equivale al promedio por token solo si sus cantidades válidas coinciden.
Una cabeza causal calcula
M es máscara causal (0 permitido, −∞ prohibido), d_h ancho, z_j logit e y objetivo. AdamW usa g_t gradiente, β₁/β₂ coeficientes, η tasa, λ_w decaimiento y ε estabilizador; cuadrados por elemento. Ecuación común con corrección de sesgo, sin AMSGrad; precisión e implementación pueden cambiar resultados.
Escalar: paralelismo no es planificación
Paralelismo de datos replica y sincroniza gradientes; tensorial divide operaciones; pipeline divide capas; sharding reparte estados. Una implementación común de Adam mixto ronda 16 bytes/parámetro antes de activaciones y buffers:7
Los ranks deben coincidir en world size, rendezvous y orden colectivo. La interconexión determina el coste de sincronizar. Admisión tipo Kueue controla cuotas; gang scheduling evita ocupar solo parte de los workers. Ninguno cambia el algoritmo. Un rank fallido requiere timeout, terminación coordinada y checkpoint completo; aumentar réplicas de Deployment no crea entrenamiento distribuido.
Con lotes iguales, cada réplica calcula g_r; all-reduce suma y divide por D. Con tokens válidos desiguales, pondera por el total global. Ring ideal mueve 2(D−1)G/D bytes por rank para gradiente G. D4, G8 GB:12 GB/rank;25 GB/s implica mínimo0.48 s sin latencia ni solapamiento. Tensor parallel comunica intermediarios frecuentemente y favorece enlaces rápidos. ZeRO fragmenta progresivamente optimizador, gradientes y parámetros; pipeline introduce burbujas. Más etapas no garantizan velocidad.
G son bytes de gradiente por réplica, D ranks y B_net bytes/s efectivos, en unidades decimales. Es límite inferior, no predicción total.
Recursos Kubernetes para dos ciclos
Jobs para preparación y entrenamiento acotados; Deployments para inferencia persistente; Services para nombres internos. Separa pools y prioridades CPU/GPU. Reserva también CPU y RAM: alimentar mal una GPU desperdicia capacidad. Driver, runtime y plugin exponen recursos; un límite GPU no crea memoria extra por sobreasignación.
El kit usa namespace, PVC RWO, Job y Deployment. Montaje de lectura y hash impiden servir artefactos incompletos. Recreate acepta interrupción por simplicidad. Producción usa objetos aprobados inmutables y cachés independientes, con readiness tras cargar y verificar. La topología del almacenamiento debe coincidir con la de los aceleradores.
La solicitud de1 CPU reserva capacidad al colocar; límite2 acota consumo por runtime/cgroup. Memoria solicitada guía colocación y exceder límite puede causar OOM. GPU extendida cuenta dispositivos, no VRAM libre. Pending puede ser dispositivo, afinidad o volumen; CUDA fallando después de iniciar apunta a driver/runtime/permisos. RWO permite escritura en un nodo, no significa un solo Pod ni filesystem compartido entre nodos. El volumen del laboratorio no es servicio distribuido de datos.
Checkpoint, candidato y versión no son lo mismo
Un checkpoint reanudable guarda pesos, optimizador, scheduler, paso, RNG, versión y posición de datos. Escribe shards en staging y publica marcador solo tras completarlos. Un object store no hace atómica una escritura multiobjeto; lectores usan manifiestos completos y los fallos dejan basura limpiable.
La exportación retiene arquitectura, tokenizer, adapters, precisión, hashes y licencias, pero elimina estados de entrenamiento. El registro cataloga artefactos y aprobación. Una versión combina candidato, imagen y configuración por entorno. Rollback restaura la combinación compatible, no solo un nombre de modelo.
Escribe shards con nombres únicos, calcula hashes y publica un manifiesto completo de tamaños/hashes. Solo entonces cambia el puntero “último completo” con escritura condicional. El lector verifica un manifiesto, no lista archivos para adivinar versiones. Fallo anterior deja basura, no checkpoint aprobado. El kit usa temporal+rename para evitar archivos parciales; durabilidad ante apagón depende del filesystem y sincronización del directorio. Archivo válido no implica modelo bueno. Rollback enruta al paquete anterior, no retira tokens entregados.
De archivos al primer token y los siguientes
Antes de readiness verifica artefactos, carga pesos, reserva buffers, inicializa kernels y calienta formas representativas. Prefill procesa el prompt y crea KV; decode reutiliza esa caché al generar. Continuous batching mejora utilización pero exige justicia y cancelación. Tokenización, cola y buffering también afectan el primer token.
L cuenta capas, H_KV cabezas KV, d_h dimensión, b bytes por escalar y T_i tokens residentes de la secuencia i. El 2 incluye claves y valores. Excluye asignador y no se traslada directamente a atención latente o caché comprimida.
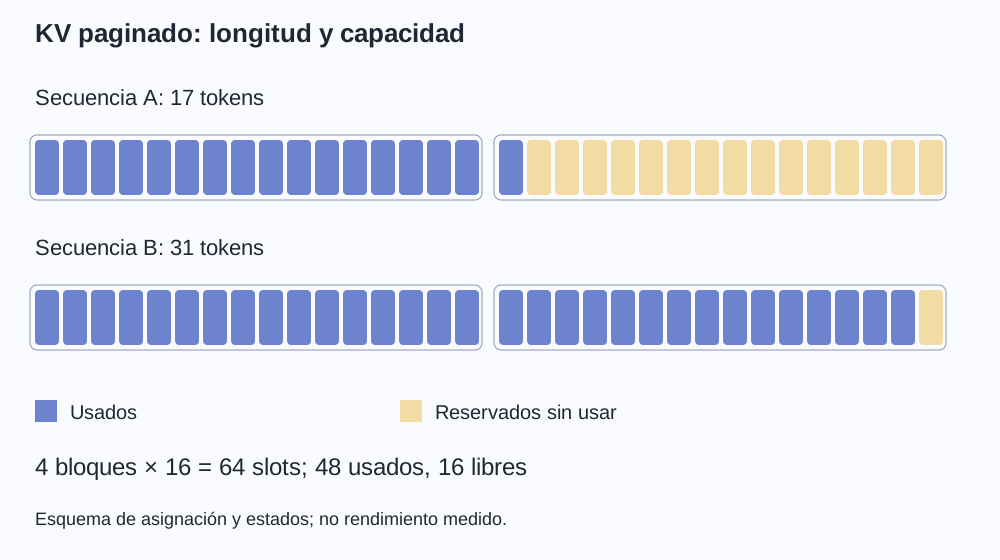
Prefill calcula T posiciones y guarda K/V por capa. Decode añade una consulta y lee la caché creciente sin recalcular K/V anteriores. Interacción densa del prompt crece cuadráticamente; cada decode, linealmente con contexto, aparte de proyecciones/FFN. KV paginado mapea bloques lógicos a físicos. Bloque16, longitudes17 y31:64 slots,16 vacíos, frente a256 reservando128 por secuencia. Es aritmética, no benchmark. Compartir prefijos exige modelo/tokenizer/posiciones/configuración compatibles y referencias que eviten liberar bloques aún usados.
P es tokens por bloque y T_i longitud; techo redondea cada secuencia a bloques completos. Sin compartir prefijos ni metadatos.
La API como máquina de estados
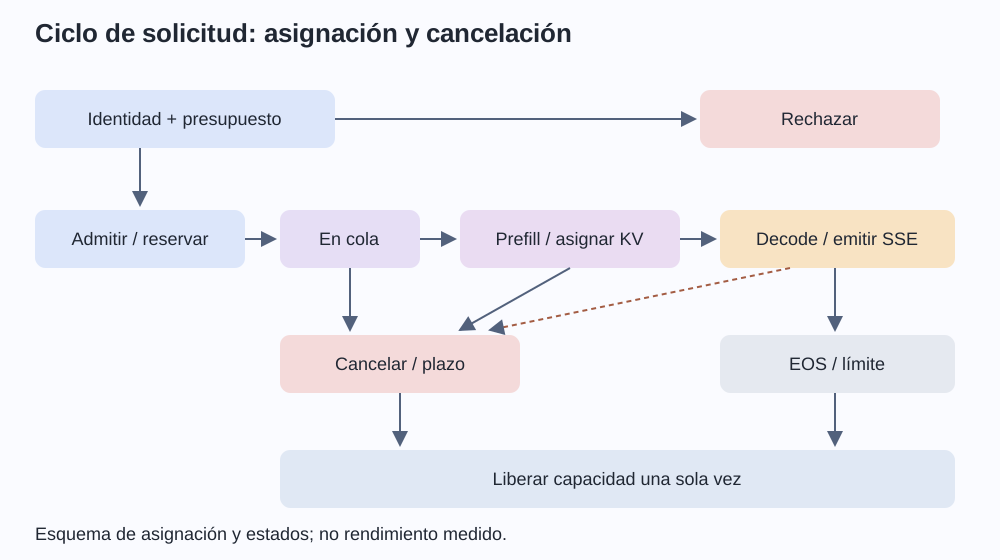
Cliente→TLS→identidad/política→cuota/admisión→router→inferencia privada→stream. Antes de usar GPU comprueba tamaño, acceso al modelo, longitud tokenizada y reserva de salida. Un request ID une eventos; el alias queda fijado a una versión durante toda la petición.
Streaming entrega eventos incrementales. Ajusta buffering y deadlines. Tras enviar bytes, reintentar puede duplicar texto o cobro; limita reintentos previos a divulgación o define reanudación explícita. Propaga desconexión para liberar KV y cupos. Una herramienta propuesta por el modelo no autoriza una transacción.
Valida credencial, no confíes en tenant enviado por cliente. Sujeto→modelo permitido/presupuesto; cuenta tokens con el tokenizer elegido y exige entrada+salida reservada≤contexto. Reserva capacidad y reconcilia uso real. SSE termina eventos con línea vacía; TCP puede fragmentarlos y el cliente debe acumular bytes. Un HTTP exitoso puede preceder fallo de generación: registra ambos estados. EOS, límite, plazo y cancelación terminan trabajo. Temperatura escala logits, no garantiza veracidad.
Capacidad, escalado y despliegue
Escala según cola, edad, secuencias, tokens, KV, primer token e intervalo entre tokens; utilización GPU sola es ambigua. Little relaciona concurrencia media con llegadas×residencia en estabilidad, no predice colas extremas.10 solicitudes/s×2
Arrancar exige programar, descargar, cargar y calentar. HPA no elimina esa espera: reserva margen y limita colas. Canary compara distribuciones equivalentes antes de crecer. PDB limita interrupciones voluntarias, no todos los fallos; drenar detiene admisión y termina streams acotados. Una sola GPU con Recreate tiene interrupción. Incluye capacidad ociosa y de despliegue en costes.
Descompón TTFT: entrada, autenticación/tokenización, cola, prefill y transporte. Ejemplo20+10+80+150+10=270 ms. Ahorrar30 ms en prefill no arregla segundos de cola. Batching puede mejorar throughput y empeorar espera individual. En M/M/1 didáctico,
Seguridad y observabilidad en todas las etapas
Separa identidades de ingesta, entrenamiento, aprobación y servicio. El servidor lee artefactos aprobados, no modifica datos ni se autopromueve. Usa identidad de workload, credenciales breves, egress limitado y auditoría. NetworkPolicy depende del CNI y no autentica usuarios; evita tokens Kubernetes innecesarios.
Une hashes, run, checkpoint, release, imagen y request ID. Mide rechazos, throughput, pérdida, checkpoints, errores GPU, colas, tokens y cancelaciones. No uses prompts o IDs arbitrarios como etiquetas de métricas: crean cardinalidad y riesgo. Traces detallados requieren control y retención. Ausencia de telemetría no prueba ausencia de fallos; disponibilidad no es corrección.
Separa autoridad: trainer lee D3 y escribe su prefijo; controlador aprueba; identidad de servicio solo lee aprobados. Labels no autentican tenants. NetworkPolicy controla conexiones; IAM, operaciones sobre objetos. Telemetría: spans cola/prefill/decode, counters aceptación/rechazo, histogramas latencia y gauges capacidad. IDs van a trazas muestreadas o exemplars, no labels ilimitados. Guarda revisión en respuestas. Span ausente puede ser muestreo, pérdida o tarea abierta, no prueba de ausencia de ejecución.
Elige por punto de control y restricción
La nube gestiona nodos, almacenamiento e identidad; el equipo conserva contratos y aceptación. NVIDIA opera cerca del dispositivo, PyTorch del entrenamiento, Kubernetes de reconciliación y vLLM del servicio/KV. Registros tipo MLflow catalogan; object stores guardan bytes; gateways controlan identidad y admisión. No sustituyas autoridad de release por dashboards.
Separar prefill/decode, transferir KV, enrutar por prefijos y offload puede ayudar, pero añade red y estados de cancelación. Adapters multitenant, cuantización y especulación añaden aislamiento, calibración y cómputo. Primero mide el cuello de botella. Siguen abiertos portabilidad, reparto justo, borrado auditable, contexto largo y recuperación a escala.
Elige por recurso desplazado: cuantización reduce pesos/precisión, exige calibración/kernels y no reduce KV automáticamente. Prefix cache requiere prefijos compatibles, no similitud semántica. Desagregar prefill/decode añade transferencia KV:1 GiB a10 GiB/s necesita al menos0.1 s sin protocolo/contención. Decodificación especulativa propone y verifica; importa aceptación y coste del verificador. Cada técnica añade estado o compatibilidad. Explica cuello original, trabajo desplazado, nuevo fallo y cuándo gana el diseño simple.
Práctica y verificación
1. Ejecutar el ciclo CPU completo
Usa Python 3.11 y un entorno aislado dentro del kit. Incluye 100 registros sintéticos CC0 originales, no un corpus útil. Normaliza, elimina duplicados y divide por hash estable antes de formar pares. Semilla 42; SGD minimiza entropía cruzada del siguiente carácter, sin atención. El umbral NLL<4 solo valida este ejemplo, no seguridad ni utilidad.
python3.11 -m venv .venv
. .venv/bin/activate
pip install -r requirements.txt
python pipeline.py prepare --source corpus.jsonl --root ./run
python pipeline.py train --root ./run --steps 400
python pipeline.py promote --root ./run
python serve.py --root ./run --port 8000
# In another terminal
curl -s http://127.0.0.1:8000/health
curl -s http://127.0.0.1:8000/v1/completions -H 'Content-Type: application/json' \
-d '{"prompt":"A model","max_tokens":16}'
curl -N http://127.0.0.1:8000/v1/completions -H 'Content-Type: application/json' \
-d '{"prompt":"A model","max_tokens":16,"stream":true}'2. Construir y programar CPU
Necesitas Docker, kubectl, StorageClass con fsGroup y CNI con NetworkPolicy. kind carga la imagen local; otros clústeres requieren registro y actualizar ambas imágenes. Namespace restricted, UID 10001, sin token API y Service privado. Un PVC RWO y Recreate simplifican a costa de disponibilidad. Antes de la primera aprobación el servidor puede reiniciar; en producción secuencia la publicación. No expongas el laboratorio sin autenticación.
docker build -t tokenlab-ai:local .
# For kind only; otherwise push image to your registry and edit YAML
kind load docker-image tokenlab-ai:local
kubectl apply -f kubernetes.yaml
kubectl -n tokenlab-ai wait --for=condition=complete job/train-v1 --timeout=600s
kubectl -n tokenlab-ai rollout status deployment/model-v1 --timeout=300s
kubectl -n tokenlab-ai port-forward service/model-api 8000:8000
# Then run the curl commands above; Ctrl-C stops the local tunnel.
3. Sustituir bigramas por un Transformer
La ruta opcional aprende BPE solo con entrenamiento y un GPT-2 aleatorio de dos capas, cuatro cabezas, dimensión/contexto 128, AdamW 3e-4. Padding=-100; GPT-2 desplaza las etiquetas internamente. Guarda optimizador/RNG, exporta safetensors y tokenizer/config, y calcula NLL de validación ponderada por tokens antes de crear approved/. No sobrescribe versiones. Esta ruta y sus dependencias no se ejecutaron aquí.
# Separate environment recommended; optional path not executed here
pip install -r requirements-transformer.txt
python transformer.py --root ./run --steps 200
python transformer.py --root ./run --steps 400 --resume
python approve_transformer.py --root ./run --max-nll 4.0
# Optional training Job (existing namespace/PVC required)
docker build -f Dockerfile.transformer -t tokenlab-transformer:lab .
kind load docker-image tokenlab-transformer:lab
kubectl -n tokenlab-ai scale deployment model-v1 --replicas=0
kubectl apply -f transformer-job.yaml
kubectl -n tokenlab-ai wait --for=condition=complete job/transformer-train --timeout=7200s
4. Inferencia GPU: integración por validar
El Job opcional usa artifacts PVC; detén CPU para evitar conflictos RWO entre nodos. vLLM monta approved y crea un Service privado. Su documentación 0.14.0 lista GPT2LMHeadModel, pero este export no está probado. Adapta UID, cachés y contexto de seguridad a restricted sin debilitar la política. Proporciona driver/plugin NVIDIA, GPU y almacenamiento compatibles. El README enumera las comprobaciones pendientes; no es una distribución GPU productiva lista.
Resultados, fallos y comparaciones justas
En CPU: NLL inicial 3.73767 nats/token, entrenamiento final 1.70074 tras 400 pasos, validación 1.70306. Son pérdidas bigrama, no benchmarks Transformer. El verificador compara 400 pasos con 200+200 reanudados byte a byte, HTTP/SSE, presupuestos inválidos e integridad. Repite localmente; no compares proveedores con estos números.
python verify.py
python mechanism_math.py
# PASS: loss descent, exact resume, artifact integrity, HTTP generation, SSE, invalid input
Para aceptar el clúster: interrumpe entrenamiento, altera un candidato, envía caracteres desconocidos, agota concurrencia, desconecta SSE y falla readiness. Mantén iguales datos, tokenizer, precisión, longitudes, tráfico y hardware; informa cola, TTFT, latencia entre tokens, fallos, coste y calidad. Un fallo rápido no mejora el servicio. Una réplica no demuestra continuidad sin interrupción.
Ejercicios originales · no preguntas reales de empresas
1. ¿Por qué diverge una reanudación con los mismos pesos?
Pista 1
Piensa en Adam y el siguiente lote.
Pista 2
RNG, momentos, scheduler, cursor y topología cambian la actualización.
Respuesta y análisis
Un export no es checkpoint. Restaura huella de datos, optimizador y RNG; define igualdad exacta o estadística. GPU entre equipos no garantiza igualdad. Compara ejecución continua e interrumpida, no solo carga correcta.
Puntuación: 1 nombrar; 2 explicar estado; 3 seguir el fallo; 4 recuperación correcta y límites; 5 contraejemplo justo y compromiso razonado.
2. ¿Por qué falla un modelo de 14 GB en una GPU de 24 GB?
Pista 1
Los pesos son solo una categoría.
Pista 2
Añade KV, activaciones, reservas y fragmentación.
Respuesta y análisis
Con 32 capas, 8 cabezas KV, dimensión 128 y BF16: 128 KiB/token. Ocho secuencias de 8192 necesitan 8 GiB KV, además de 14 GB decimales de pesos. Limita tokens admitidos y mide picos. Cuantizar pesos no cuantiza necesariamente KV.
Puntuación: 1 nombrar; 2 explicar estado; 3 seguir el fallo; 4 recuperación correcta y límites; 5 contraejemplo justo y compromiso razonado.
3. ¿Reintentar después del primer token?
Pista 1
¿El cliente ya vio salida?
Pista 2
Reiniciar puede duplicar o cambiar texto y coste.
Respuesta y análisis
No repitas de forma transparente un flujo observado. Señala interrupción; el cliente inicia otra petición salvo protocolo reanudable con eventos idénticos. Antes de salida, reintenta fallos elegibles con límite global. Cancela trabajo y libera KV al desconectar. Un ID no crea idempotencia.
Puntuación: 1 nombrar; 2 explicar estado; 3 seguir el fallo; 4 recuperación correcta y límites; 5 contraejemplo justo y compromiso razonado.
Archivos completos (comentarios en inglés)
mechanism_math.py
"""Deterministic checks for the article's synthetic arithmetic. Standard library only.
No cluster, model benchmark, GPU, network or stochastic experiment.
"""
import math
p0=0.5
loss0=-math.log(p0)
loss1=math.log(math.exp(-0.05)+math.exp(0.05))-0.05
assert abs(loss0-0.69314718056)<1e-10
assert abs(loss1-0.64439666007)<1e-10 and loss1<loss0
# First AdamW moment correction with a scalar gradient.
g=0.5;beta1=0.9;beta2=0.999
m=(1-beta1)*g;v=(1-beta2)*g*g
assert math.isclose(m/(1-beta1),g)
assert math.isclose(v/(1-beta2),g*g)
assert 4*128*512*4==1024**2
assert 2*(4-1)*8/4/25==0.48
slots=16*sum(math.ceil(t/16) for t in [17,31])
assert slots==64 and slots-17-31==16
assert 2*32*8*128*2*8192==1024**3
assert sum([20,10,80,150,10])==270
assert 1/(10-8)==0.5 and 1/(10-9.5)==2
print('PASS: gradient step, AdamW bias correction, logits bytes, ring budget, KV blocks, TTFT and queue arithmetic')
pipeline.py
"""Transparent language-model lifecycle. Python 3.11 + numpy 2.3.5.
The model is a learned bigram softmax, not a Transformer or general assistant.
"""
import argparse, hashlib, json, os, tempfile
from pathlib import Path
import numpy as np

def digest(b): return hashlib.sha256(b).hexdigest()
def atomic(path, data):
    path=Path(path); path.parent.mkdir(parents=True,exist_ok=True)
    fd,tmp=tempfile.mkstemp(dir=path.parent)
    with os.fdopen(fd,'wb') as f: f.write(data); f.flush(); os.fsync(f.fileno())
    os.replace(tmp,path)
def prepare(source,out):
    records=[json.loads(x) for x in Path(source).read_text().splitlines() if x.strip()]
    seen=set(); groups={'train':[],'validation':[]}
    for r in records:
        if r.get('license')!='CC0' or not isinstance(r.get('text'),str): raise ValueError('unsupported rights/schema')
        text=' '.join(r['text'].split())
        if not text: raise ValueError('empty text')
        h=digest(text.encode())
        if h in seen: continue
        seen.add(h)
        # Split before windows; one source record never crosses splits.
        groups['validation' if int(h[:8],16)%5==0 else 'train'].append({'id':r['id'],'text':text,'sha256':h})
    if not all(groups.values()): raise ValueError('both splits required')
    payload=json.dumps(groups,sort_keys=True).encode()
    atomic(Path(out)/'dataset.json',payload)
    atomic(Path(out)/'data-manifest.json',json.dumps({'sha256':digest(payload),'source_sha256':digest(Path(source).read_bytes()),'split':'content-hash modulo 5','counts':{k:len(v) for k,v in groups.items()}},indent=2).encode())
    return groups

def pairs(records,vocab):
    lookup={c:i+2 for i,c in enumerate(vocab)}; xs=[];ys=[]
    for r in records:
        ids=[0]+[lookup[c] for c in r['text']]+[1]
        xs.extend(ids[:-1]);ys.extend(ids[1:])
    return np.array(xs),np.array(ys)
def loss(w,x,y):
    z=w[x]; z=z-z.max(axis=1,keepdims=True)
    return float(np.mean(np.log(np.exp(z).sum(axis=1))-z[np.arange(len(x)),y]))
def train(root,steps=400,resume=False):
    root=Path(root); raw=(root/'dataset.json').read_bytes();ds=json.loads(raw)
    # Vocabulary belongs to training data. Fixture is ASCII; production needs UNK policy.
    vocab=sorted(set(''.join(r['text'] for r in ds['train'])))
    if any(c not in vocab for r in ds['validation'] for c in r['text']): raise ValueError('validation has unknown characters')
    x,y=pairs(ds['train'],vocab); vx,vy=pairs(ds['validation'],vocab)
    rng=np.random.default_rng(42);w=np.zeros((len(vocab)+2,)*2);start=0
    cp=root/'checkpoint.npz'
    if resume and cp.exists():
        with np.load(cp,allow_pickle=False) as c:
            if str(c['data_hash'])!=digest(raw): raise ValueError('dataset changed during resume')
            w=c['weights'];start=int(c['step']);rng.bit_generator.state=json.loads(str(c['rng']))
    initial=loss(w,x,y)
    for step in range(start,steps):
        ix=rng.integers(0,len(x),size=128); xx=x[ix];yy=y[ix]
        z=w[xx];z-=z.max(axis=1,keepdims=True);p=np.exp(z);p/=p.sum(axis=1,keepdims=True)
        p[np.arange(len(xx)),yy]-=1;g=np.zeros_like(w);np.add.at(g,xx,p/len(xx));w-=3*g
        if (step+1)%50==0 or step+1==steps:
            import io
            buf=io.BytesIO();np.savez(buf,weights=w,step=step+1,rng=json.dumps(rng.bit_generator.state),data_hash=digest(raw));atomic(cp,buf.getvalue())
    model={'architecture':'bigram-softmax-v1','vocab':vocab,'weights':w.tolist(),'data_sha256':digest(raw),'steps':steps,'seed':42}
    modelraw=json.dumps(model,separators=(',',':')).encode();atomic(root/'model.json',modelraw)
    metrics={'initial_train_nll':initial,'train_nll':loss(w,x,y),'validation_nll':loss(w,vx,vy),'model_sha256':digest(modelraw),'steps':steps}
    atomic(root/'metrics.json',json.dumps(metrics,indent=2).encode());print(json.dumps(metrics));return metrics

def promote(root):
    root=Path(root);m=json.loads((root/'metrics.json').read_text()); raw=(root/'model.json').read_bytes()
    if digest(raw)!=m['model_sha256'] or not np.isfinite(m['validation_nll']) or m['validation_nll']>=4: raise ValueError('release gate failed')
    # This threshold only validates the declared teaching fixture, not language quality.
    atomic(root/'release.json',json.dumps({'model_sha256':digest(raw),'data_sha256':digest((root/'dataset.json').read_bytes()),'artifact':'model.json','gate':'fixture validation NLL < 4; not a safety evaluation'},indent=2).encode())

if __name__=='__main__':
    p=argparse.ArgumentParser();p.add_argument('action',choices=['prepare','train','promote']);p.add_argument('--root',default='/work');p.add_argument('--source',default='corpus.jsonl');p.add_argument('--steps',type=int,default=400);p.add_argument('--resume',action='store_true');a=p.parse_args()
    if a.action=='prepare': prepare(a.source,a.root)
    elif a.action=='train': train(a.root,a.steps,a.resume)
    else: promote(a.root)
serve.py
"""Local/private teaching API; no public ingress, TLS or identity provider."""
import argparse, hashlib, json, threading
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer
from pathlib import Path
import numpy as np

def load(root):
    root=Path(root);release=json.loads((root/'release.json').read_text());raw=(root/'model.json').read_bytes()
    if hashlib.sha256(raw).hexdigest()!=release['model_sha256']: raise ValueError('artifact integrity mismatch')
    return json.loads(raw),release['model_sha256']
def application(model,revision):
    w=np.array(model['weights']);vocab=model['vocab'];lookup={c:i+2 for i,c in enumerate(vocab)};slots=threading.BoundedSemaphore(2)
    class Handler(BaseHTTPRequestHandler):
        def log_message(self,*args): pass # No prompts in request logs.
        def respond(self,status,obj):
            raw=json.dumps(obj).encode();self.send_response(status);self.send_header('Content-Type','application/json');self.send_header('Content-Length',str(len(raw)));self.end_headers();self.wfile.write(raw)
        def do_GET(self):
            self.respond(200 if self.path=='/health' else 404,{'model_revision':revision})
        def do_POST(self):
            if self.path!='/v1/completions': return self.respond(404,{'error':'not found'})
            self.connection.settimeout(10)
            try:
                size=int(self.headers.get('Content-Length','0'))
                if not 0<size<=8192: return self.respond(413,{'error':'body limit'})
                body=json.loads(self.rfile.read(size))
                if not isinstance(body,dict): raise ValueError('object required')
                prompt=body.get('prompt','');limit=body.get('max_tokens',32)
                if not isinstance(prompt,str) or len(prompt)>512 or type(limit)!=int or not 1<=limit<=128: raise ValueError('invalid prompt or token limit')
                if any(c not in lookup for c in prompt): raise ValueError('unknown character')
                if type(body.get('stream',False))!=bool: raise ValueError('stream must be boolean')
            except (ValueError,TypeError,TimeoutError): return self.respond(400,{'error':'invalid request'})
            if not slots.acquire(blocking=False): return self.respond(429,{'error':'capacity'})
            try:
                token=lookup[prompt[-1]] if prompt else 0;rng=np.random.default_rng(42);out=[]
                if body.get('stream'):
                    self.send_response(200);self.send_header('Content-Type','text/event-stream');self.send_header('Cache-Control','no-cache');self.send_header('Connection','close');self.end_headers();self.close_connection=True
                for _ in range(limit):
                    z=w[token].copy();z[0]=-np.inf;p=np.exp(z-np.max(z));p/=p.sum();token=int(rng.choice(len(p),p=p))
                    if token==1: break
                    out.append(vocab[token-2])
                    if body.get('stream'):
                        self.wfile.write(('data: '+json.dumps({'token':out[-1],'model_revision':revision})+'\n\n').encode());self.wfile.flush()
                if body.get('stream'): self.wfile.write(b'data: [DONE]\n\n');self.wfile.flush()
                else: self.respond(200,{'text':''.join(out),'completion_tokens':len(out),'model_revision':revision})
            except (BrokenPipeError,ConnectionResetError,TimeoutError): pass
            finally: slots.release()
    return Handler
if __name__=='__main__':
    p=argparse.ArgumentParser();p.add_argument('--root',default='/work');p.add_argument('--host',default='127.0.0.1');p.add_argument('--port',type=int,default=8000);a=p.parse_args()
    model,rev=load(a.root);ThreadingHTTPServer((a.host,a.port),application(model,rev)).serve_forever()
transformer.py
"""Optional real GPT-2 architecture training path; not run by Token Lab.
Python 3.11, torch 2.6.0, transformers 4.51.3, tokenizers 0.21.1.
Reads the SAME prepared dataset.json; trains its own byte BPE tokenizer.
A tiny random model demonstrates mechanics, not useful assistant capability.
"""
import argparse,json,os,random
from pathlib import Path
import torch
from tokenizers import ByteLevelBPETokenizer
from transformers import GPT2Config,GPT2LMHeadModel,PreTrainedTokenizerFast
p=argparse.ArgumentParser();p.add_argument('--root',default='/work');p.add_argument('--steps',type=int,default=200);p.add_argument('--resume',action='store_true');a=p.parse_args()
root=Path(a.root);ds=json.loads((root/'dataset.json').read_text());torch.manual_seed(42);random.seed(42)
# CPU default for broad compatibility; set DEVICE=cuda for a provisioned GPU.
device=os.environ.get('DEVICE','cpu');tokenizer=ByteLevelBPETokenizer()
tokenizer.train_from_iterator((r['text'] for r in ds['train']),vocab_size=512,min_frequency=2,special_tokens=['<bos>','<eos>','<pad>'])
tok=PreTrainedTokenizerFast(tokenizer_object=tokenizer._tokenizer,bos_token='<bos>',eos_token='<eos>',pad_token='<pad>')
config=GPT2Config(vocab_size=len(tok),n_positions=128,n_ctx=128,n_embd=128,n_layer=2,n_head=4,bos_token_id=tok.bos_token_id,eos_token_id=tok.eos_token_id,pad_token_id=tok.pad_token_id)
model=GPT2LMHeadModel(config).to(device);optimizer=torch.optim.AdamW(model.parameters(),lr=3e-4)
rows=[tok(r['text'],max_length=126,truncation=True)['input_ids']+[tok.eos_token_id] for r in ds['train']]
import hashlib
fingerprint=hashlib.sha256((root/'dataset.json').read_bytes()).hexdigest();cp=root/'transformer-checkpoint.pt';start=0
if a.resume and cp.exists():
    state=torch.load(cp,map_location='cpu',weights_only=True)
    if state['data_hash']!=fingerprint: raise ValueError('dataset mismatch')
    model.load_state_dict(state['model']);optimizer.load_state_dict(state['optimizer']);start=state['step'];torch.set_rng_state(state['cpu_rng']);random.setstate(state['python_rng'])
    if device.startswith('cuda'): torch.cuda.set_rng_state_all(state['cuda_rng'])
model.train()
for step in range(start,a.steps):
    chosen=random.choices(rows,k=4);width=max(map(len,chosen));ids=torch.full((4,width),tok.pad_token_id,dtype=torch.long,device=device);mask=torch.zeros_like(ids)
    for i,row in enumerate(chosen): ids[i,:len(row)]=torch.tensor(row,device=device);mask[i,:len(row)]=1
    labels=ids.clone();labels[mask==0]=-100
    optimizer.zero_grad(set_to_none=True);loss=model(input_ids=ids,attention_mask=mask,labels=labels).loss
    loss.backward();torch.nn.utils.clip_grad_norm_(model.parameters(),1);optimizer.step()
    if (step+1)%50==0 or step+1==a.steps:
        state={'model':model.state_dict(),'optimizer':optimizer.state_dict(),'step':step+1,'cpu_rng':torch.get_rng_state(),'python_rng':random.getstate(),'cuda_rng':torch.cuda.get_rng_state_all() if device.startswith('cuda') else [],'data_hash':fingerprint}
        tmp=root/'checkpoint.tmp';torch.save(state,tmp);os.replace(tmp,cp)
        print(json.dumps({'step':step+1,'training_loss':float(loss.detach())}))
export=root/'transformer-candidate';export.mkdir(exist_ok=True)
model.save_pretrained(export,safe_serialization=True);tok.save_pretrained(export)
# Candidate only: no release pointer is changed. Evaluate before promotion.
(export/'lineage.json').write_text(json.dumps({'data_sha256':fingerprint,'seed':42,'steps':a.steps,'status':'candidate-not-approved'}))
approve_transformer.py
"""Held-out next-token NLL gate for this synthetic fixture only. Not a safety gate.
Unexecuted optional Transformer path. Uses CPU; no paid APIs or uploaded data.
"""
import argparse,hashlib,json,math,os,shutil
from pathlib import Path
import torch
from transformers import AutoTokenizer, GPT2LMHeadModel
p=argparse.ArgumentParser();p.add_argument('--root',default='/work');p.add_argument('--max-nll',type=float,required=True);a=p.parse_args()
r=Path(a.root);src=r/'transformer-candidate';dst=r/'approved'
if dst.exists(): raise ValueError('use a fresh release directory; never overwrite a served artifact')
data=json.loads((r/'dataset.json').read_text());lineage=json.loads((src/'lineage.json').read_text())
assert lineage['data_sha256']==hashlib.sha256((r/'dataset.json').read_bytes()).hexdigest()
tok=AutoTokenizer.from_pretrained(src,local_files_only=True);model=GPT2LMHeadModel.from_pretrained(src,local_files_only=True).eval()
total=0.;n=0
with torch.no_grad():
    for row in data['validation']:
        ids=tok(row['text'],max_length=126,truncation=True)['input_ids']+[tok.eos_token_id]
        x=torch.tensor([ids]);loss=model(input_ids=x,labels=x).loss.item()
        total+=loss*(len(ids)-1);n+=len(ids)-1
nll=total/n
print(json.dumps({'validation_nll':nll,'tokens':n,'threshold':a.max_nll}))
if not math.isfinite(nll) or nll>=a.max_nll: raise ValueError('candidate rejected; approved version unchanged')
files={f.name:hashlib.sha256(f.read_bytes()).hexdigest() for f in src.iterdir() if f.is_file()}
staging=r/'approval-staging'
if staging.exists(): shutil.rmtree(staging)
shutil.copytree(src,staging)
(staging/'release-manifest.json').write_text(json.dumps({'files':files,'validation_nll':nll,'gate':'synthetic fixture only','data_sha256':lineage['data_sha256']},indent=2))
os.replace(staging,dst) # Atomic directory rename on this one filesystem, not object-store transaction.
verify.py
"""Actual local training/resume/integrity/API checks; no cluster required."""
import importlib.util,json,tempfile,threading,urllib.request,urllib.error
from pathlib import Path
from http.server import ThreadingHTTPServer
import numpy as np
from pipeline import prepare,train,promote
from serve import load,application
here=Path(__file__).parent
with tempfile.TemporaryDirectory() as t:
    a=Path(t)/'a';b=Path(t)/'b'
    for root in (a,b):prepare(here/'corpus.jsonl',root)
    metrics=train(a);train(b,200);train(b,400,True)
    assert (a/'model.json').read_bytes()==(b/'model.json').read_bytes(),'resume differs'
    assert metrics['train_nll']<metrics['initial_train_nll'];promote(a)
    model,revision=load(a);server=ThreadingHTTPServer(('127.0.0.1',0),application(model,revision))
    thread=threading.Thread(target=server.serve_forever,daemon=True);thread.start()
    url=f'http://127.0.0.1:{server.server_port}'
    def post(body):
        request=urllib.request.Request(url+'/v1/completions',data=json.dumps(body).encode(),headers={'Content-Type':'application/json'})
        return urllib.request.urlopen(request,timeout=5).read()
    assert json.loads(urllib.request.urlopen(url+'/health').read())['model_revision']==revision
    result=json.loads(post({'prompt':'Data ','max_tokens':16}));assert result['completion_tokens']<=16 and result['model_revision']==revision
    stream=post({'prompt':'Data ','max_tokens':16,'stream':True});assert stream.endswith(b'data: [DONE]\n\n')
    try:post({'prompt':'Data ','max_tokens':0});raise AssertionError('invalid request accepted')
    except urllib.error.HTTPError as e:assert e.code==400
    server.shutdown();server.server_close()
    (a/'model.json').write_text('{}')
    try:load(a);raise AssertionError('tamper accepted')
    except ValueError:pass
print('PASS: loss descent, exact resume, artifact integrity, HTTP generation, SSE, invalid input')
kubernetes.yaml
apiVersion: v1
kind: Namespace
metadata:
  name: tokenlab-ai
  labels:
    pod-security.kubernetes.io/enforce: restricted
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata: {name: artifacts, namespace: tokenlab-ai}
spec:
  accessModes: [ReadWriteOnce]
  resources:
    requests: {storage: 1Gi}
---
apiVersion: batch/v1
kind: Job
metadata: {name: train-v1, namespace: tokenlab-ai}
spec:
  backoffLimit: 1
  activeDeadlineSeconds: 600
  template:
    metadata:
      labels: {app: trainer}
    spec:
      restartPolicy: Never
      automountServiceAccountToken: false
      securityContext: {runAsNonRoot: true, runAsUser: 10001, runAsGroup: 10001, fsGroup: 10001, seccompProfile: {type: RuntimeDefault}}
      containers:
      - name: train
        image: tokenlab-ai:local
        imagePullPolicy: IfNotPresent
        command: [sh, -ec]
        args:
        - python pipeline.py prepare --source corpus.jsonl --root /work && python pipeline.py train --root /work --resume && python pipeline.py promote --root /work
        resources:
          requests: {cpu: '1', memory: 256Mi}
          limits: {cpu: '2', memory: 512Mi}
        securityContext: {allowPrivilegeEscalation: false, readOnlyRootFilesystem: true, capabilities: {drop: [ALL]}}
        volumeMounts:
        - {name: artifacts, mountPath: /work}
      volumes:
      - name: artifacts
        persistentVolumeClaim: {claimName: artifacts}
---
apiVersion: apps/v1
kind: Deployment
metadata: {name: model-v1, namespace: tokenlab-ai}
spec:
  replicas: 1
  strategy: {type: Recreate}
  selector:
    matchLabels: {app: model-v1}
  template:
    metadata:
      labels: {app: model-v1}
    spec:
      automountServiceAccountToken: false
      securityContext: {runAsNonRoot: true, runAsUser: 10001, runAsGroup: 10001, fsGroup: 10001, seccompProfile: {type: RuntimeDefault}}
      containers:
      - name: server
        image: tokenlab-ai:local
        imagePullPolicy: IfNotPresent
        resources:
          requests: {cpu: '250m', memory: 128Mi}
          limits: {cpu: '1', memory: 256Mi}
        ports: [{containerPort: 8000}]
        startupProbe:
          httpGet: {path: /health, port: 8000}
          failureThreshold: 30
          periodSeconds: 2
        readinessProbe:
          httpGet: {path: /health, port: 8000}
          periodSeconds: 5
        livenessProbe:
          httpGet: {path: /health, port: 8000}
          periodSeconds: 15
        securityContext: {allowPrivilegeEscalation: false, readOnlyRootFilesystem: true, capabilities: {drop: [ALL]}}
        volumeMounts:
        - {name: artifacts, mountPath: /work, readOnly: true}
      volumes:
      - name: artifacts
        persistentVolumeClaim: {claimName: artifacts}
---
apiVersion: v1
kind: Service
metadata: {name: model-api, namespace: tokenlab-ai}
spec:
  selector: {app: model-v1}
  ports: [{port: 8000, targetPort: 8000}]
  type: ClusterIP
---
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata: {name: private-model, namespace: tokenlab-ai}
spec:
  podSelector: {}
  policyTypes: [Ingress, Egress]
  ingress:
  - from:
    - podSelector:
        matchLabels: {role: authorized-client}
    ports: [{protocol: TCP, port: 8000}]
  egress: []
transformer-job.yaml
# Optional, not executed here. First create namespace/PVC from kubernetes.yaml.
apiVersion: batch/v1
kind: Job
metadata:
  name: transformer-train
  namespace: tokenlab-ai
spec:
  backoffLimit: 1
  activeDeadlineSeconds: 7200
  template:
    metadata:
      labels:
        app: trainer
    spec:
      restartPolicy: Never
      automountServiceAccountToken: false
      securityContext:
        runAsNonRoot: true
        runAsUser: 10001
        runAsGroup: 10001
        fsGroup: 10001
        seccompProfile:
          type: RuntimeDefault
      containers:
      - name: train
        image: tokenlab-transformer:lab
        imagePullPolicy: IfNotPresent
        command:
        - sh
        - -c
        args:
        - python pipeline.py prepare --source corpus.jsonl --root /work && python transformer.py
          --root /work --steps 200 --resume && python approve_transformer.py --root
          /work --max-nll 4.0
        resources:
          requests:
            cpu: '2'
            memory: 2Gi
          limits:
            cpu: '4'
            memory: 4Gi
        securityContext:
          allowPrivilegeEscalation: false
          readOnlyRootFilesystem: true
          capabilities:
            drop:
            - ALL
        volumeMounts:
        - name: artifacts
          mountPath: /work
      volumes:
      - name: artifacts
        persistentVolumeClaim:
          claimName: artifacts
gpu-serving.yaml
# Optional unexecuted serving reference. Populate /models/approved first.
# Replace the image tag with a verified digest in your registry before production.
apiVersion: apps/v1
kind: Deployment
metadata: {name: transformer-v1, namespace: tokenlab-ai}
spec:
  replicas: 1
  strategy: {type: Recreate}
  selector:
    matchLabels: {app: transformer-v1}
  template:
    metadata:
      labels: {app: transformer-v1}
    spec:
      automountServiceAccountToken: false
      containers:
      - name: vllm
        image: vllm/vllm-openai:v0.14.0
        args: [--model, /models/approved, --served-model-name, tokenlab-transformer, --max-model-len, '128', --dtype, float32, --gpu-memory-utilization, '0.5', --max-num-seqs, '8']
        resources:
          requests: {cpu: '2', memory: 4Gi}
          limits: {cpu: '4', memory: 8Gi, nvidia.com/gpu: '1'}
        ports: [{containerPort: 8000}]
        startupProbe:
          httpGet: {path: /health, port: 8000}
          failureThreshold: 180
          periodSeconds: 10
        readinessProbe:
          httpGet: {path: /health, port: 8000}
        volumeMounts:
        - {name: models, mountPath: /models, readOnly: true}
        - {name: shm, mountPath: /dev/shm}
      volumes:
      - name: models
        persistentVolumeClaim: {claimName: artifacts}
      - name: shm
        emptyDir: {medium: Memory, sizeLimit: 1Gi}
# Integrate into a separately hardened GPU namespace: the public image's UID,
# writable cache locations, device access and driver/CUDA matrix must be checked.
# Do not apply blindly to the restricted CPU namespace above. See README.

---
apiVersion: v1
kind: Service
metadata: {name: transformer-api, namespace: tokenlab-ai}
spec:
  selector: {app: transformer-v1}
  ports: [{port: 8000, targetPort: 8000}]
Dockerfile
FROM python:3.11.14-slim
WORKDIR /app
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt
COPY pipeline.py serve.py corpus.jsonl ./
USER 10001:10001
ENV PYTHONDONTWRITEBYTECODE=1 PYTHONUNBUFFERED=1
CMD ["python", "serve.py", "--host", "0.0.0.0"]
Dockerfile.transformer
FROM python:3.11.14-slim
WORKDIR /app
COPY requirements-transformer.txt .
RUN pip install --no-cache-dir -r requirements-transformer.txt
COPY pipeline.py transformer.py approve_transformer.py corpus.jsonl ./
ENV PYTHONDONTWRITEBYTECODE=1 PYTHONUNBUFFERED=1 TOKENIZERS_PARALLELISM=false
USER 10001:10001
CMD ["python", "transformer.py", "--root", "/work"]