Automejora recursiva: mecanismos, evidencia e ingeniería de bucles fiables
Una revisión de RSI: autoentrenamiento, memoria, evolución de código, metamejora, investigación, arquitectura y práctica local reproducible.
Fuentes y versiones
Aprenderá a identificar componentes editables, explicar la persistencia del cambio, seguir una arquitectura auditable y separar ganancias de efectos de selección para diseñar un estudio limitado.
En este artículo
1. ¿Qué cambia cuando una IA se mejora?
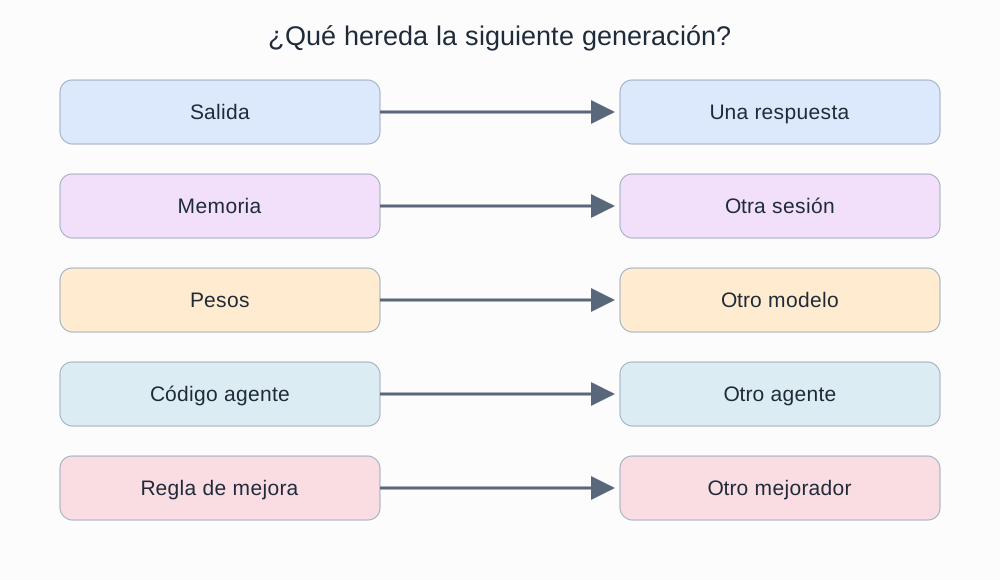
Imagine un asistente de programación que edita sin inspeccionar el repositorio. Revisar una respuesta puede reparar un parche; guardar una rutina puede ayudar en otra sesión; entrenar con reparaciones puede cambiar los pesos; reescribir la política de búsqueda puede mejorar el descubrimiento de cambios futuros. Son intervenciones distintas en persistencia, coste y evidencia.
La automejora recursiva (RSI) es un proceso en el que un sistema de IA participa en su modificación y la versión mejorada interviene en ciclos posteriores. Una definición operativa más fuerte exige mejorar también el mecanismo de mejora: descubrir cambios útiles con mayor eficacia, no solo resolver mejor una tarea. No existe un umbral universal que convierta cualquier programa automodificable en RSI general.
Separe pesos θ, código c, instrucciones p, memoria m y herramientas T, además del procedimiento de mejora I y el evaluador E. Declare qué cambia, quién lo cambia, qué persiste y quién decide. Editar código no significa actualizar pesos; actualizar pesos no significa mejorar el algoritmo de entrenamiento. Una explosión de inteligencia es otra hipótesis, sobre ganancias sostenidas y aceleradas.
Seguir un cambio durante dos generaciones
Imagine que A busca archivos por nombre y B añade búsqueda de símbolos. Si B solo arregla el error actual, mejora una solución; si se conserva para errores futuros, mejora un agente reutilizable. Si B usa esa herramienta para modificar su propio código de mejora y producir C, el proceso registrado es recursivo. Aún hay que comparar los descendientes de A y B con recursos iguales para demostrar una mejora del mejorador. Tener una orden de autoedición no demuestra todas estas afirmaciones.
Defina el límite del sistema antes de contar generaciones. Un modelo congelado con herramientas cambiantes puede formar un sistema cambiante. Si una persona sustituye el modelo base, es una intervención externa: registre aparte cambios humanos, modelos y evaluadores para no atribuirles ganancias autónomas.
2. Fundamentos: aprendizaje, retroalimentación y herencia
Optimizar es elegir un cambio según un objetivo; generalizar es conservar la mejora en casos no usados para elegirlo. Una búsqueda puede optimizar muy bien un objetivo equivocado. El gradiente expresa sensibilidad local de una pérdida diferenciable; editar Python suele ser una búsqueda en programas discretos. Ninguna vía garantiza mejoras fuera de su objetivo y datos.
La retroalimentación informa sobre consecuencias: un error de compilación localiza un fallo, una prueba cubre sus aserciones y una preferencia refleja al evaluador. «He reflexionado» no es evidencia independiente. La herencia exige que pesos, memoria, código o algoritmo pasen realmente a la siguiente generación; sin ella hay inferencia repetida.
El control de versiones permite identificar lo que cambió: hash del padre, diferencias, instantánea de datos y versión del evaluador. Nuestro caso continuo es un agente que repara repositorios y modifica su política de búsqueda de archivos y herramientas. Mantendremos fijos el modelo, los permisos y las reglas externas de aceptación para atribuir la ganancia a un mecanismo concreto.
Una señal correcta puede enseñar algo incorrecto
Una prueba que solo verifica que una lista esté ordenada puede aceptar una lista vacía, aunque se hayan perdido los elementos originales. La recompensa existe, pero la especificación es incompleta. Comprobar que la salida sea una permutación aporta la información que falta; pedir más reflexión sobre la misma prueba no. Comprensión, especificación y calidad del feedback deben preceder a la optimización.
La herencia tiene alcance: una memoria de un repositorio no es una regla global. Una reparación puede depender de la versión de una biblioteca. Conserve condiciones de aplicación, compruébelas al recuperar la memoria e invalide reglas contradichas en lugar de acumular instrucciones incompatibles.
3. Historia de bucles cada vez más modificables
El control por retroalimentación cambia acciones ante un error sin aprender necesariamente otro controlador. La búsqueda evolutiva conserva candidatos, aunque mutación y selección sigan diseñadas por humanos. AutoML busca configuraciones; el metaaprendizaje aprende procedimientos entre tareas. Son componentes posibles, no pruebas de que el proceso de mejora se mejore a sí mismo.
La máquina de Gödel de Schmidhuber condiciona la modificación a una prueba de utilidad bajo axiomas codificados: una construcción teórica exigente, no una garantía práctica para parches de LLM [1]. Sustituir la prueba por evidencia empírica hace viable la implementación, pero limita la conclusión a tareas, mediciones y presupuestos observados.
No hay una escalera donde cada artículo sustituya al anterior. Refinamiento, datos sintéticos, memoria, evolución de código y descubrimiento de algoritmos modifican sustratos diferentes. Pueden combinarse: un agente propone un filtro de datos y un entrenamiento produce otro modelo. La combinación hereda los costes y fallos de todas sus etapas.
Tres ejes, no una cronología de entusiasmo
Clasifique por espacio editable, origen del feedback y ubicación del bucle externo. Buscar millones de hiperparámetros no cambia necesariamente la regla de búsqueda. Un optimizador aprendido puede tener metatraining humano; un agente autoeditable, un controlador de aceptación fijo. Avanzan ejes diferentes, no una escala universal de inteligencia.
Una prueba depende de axiomas y objetivo formal; la evidencia empírica, de cobertura e integridad. Probar el objetivo equivocado no resuelve la tarea real y una puntuación alta no es una demostración. Combine comprobaciones formales de invariantes estrechos con evidencia de comportamiento más amplio.
4. Cinco mecanismos y lo que conservan
1. Refinar salidas alterna generación y crítica; Self-Refine mantiene los pesos fijos [3]. Puede conservar solo la respuesta. Una crítica útil detecta omisiones, pero también puede sustituir una respuesta correcta por un error convincente.
2. Adaptar memoria conserva experiencia para recuperarla después. Reflexion emplea retroalimentación lingüística [4]. Una memoria útil especifica condición, acción y alcance. «Reintentar siempre» puede duplicar un cobro; hacen falta caducidad, procedencia y resolución de conflictos.
3. Mejorar pesos genera o selecciona datos y optimiza parámetros. STaR vincula razonamientos generados con supervisión de respuestas [2]; Self-Rewarding genera preferencias [6]. La persistencia supera una sesión, pero acertar la respuesta no valida cada paso y el filtrado puede eliminar capacidades raras.
4. Mejorar código modifica herramientas, búsqueda y orquestación, como DGM [7]. 5. La metamejora modifica cómo proponer o elegir candidatos, o cómo aprender. Para distinguirlas, fije tareas y presupuestos y compruebe si el nuevo mejorador produce mejores descendientes. Cambiar una función llamada «improve» no basta.
Cambie la capa mínima que resuelva el fallo
Un dato ausente puede requerir recuperación; una rutina olvidada, memoria acotada; un comportamiento débil en muchos contextos, nuevos pesos. Orden de herramientas o truncamiento apuntan al marco; propuestas poco informativas, al mejorador. Este diagnóstico evita usar entrenamiento caro para ocultar un defecto de orquestación.
Las capas interactúan. Un modelo mejor puede volver innecesario un prompt largo; la memoria ayuda una tarea y ocupa contexto de otra. Compare combinaciones y cambios aislados. Quitar memoria tras modificar el marco no equivale a quitarla del sistema original: declare el estado de referencia y no sume ganancias como si fueran independientes.
5. Cómo los datos generados cambian los pesos
El agente genera varias reparaciones y un verificador selecciona una compatible con la especificación disponible. El ajuste supervisado aumenta la probabilidad de sus tokens: x es problema y contexto; y, solución; y<j, prefijo. Normalizar por longitud cambia el peso de respuestas largas. Se aprende la distribución seleccionada, no una verdad abstracta.
Si el filtro favorece tareas fáciles, estas dominan los datos posteriores. La pérdida baja aunque desaparezcan casos difíciles. Mezcle datos auténticos y sintéticos comprobados, proteja capacidades previas y elimine duplicados por familias antes de separar conjuntos. Renombrar variables no crea independencia. Registre modelo generador, instrucciones, verificador y versión padre.
DPO aumenta el margen de log-probabilidad entre respuesta elegida y rechazada respecto de una política de referencia. β escala la comparación; no garantiza seguridad. Si un modelo responde y juzga, sus preferencias y errores pueden reforzarse. Comprobaciones externas, revisión independiente o jueces calibrados siguen siendo útiles. Repetir ajuste con el mismo optimizador no demuestra que este haya mejorado. [17]
Un cálculo revela el sesgo de selección
Cien problemas producen 400 soluciones; 80 pasan. Son 80 ejemplos aceptados, no 400 éxitos independientes. Si proceden de solo 20 problemas fáciles, los otros 80 siguen sin evidencia. Dar igual peso a cada solución favorece problemas con más variantes aceptadas. Limite ejemplos por problema o declare pesos de muestreo.
Si las razones elegida/referencia y rechazada/referencia son 2 y 0,5, la diferencia logarítmica es log(4). Con
6. Arquitectura completa con un árbitro protegido
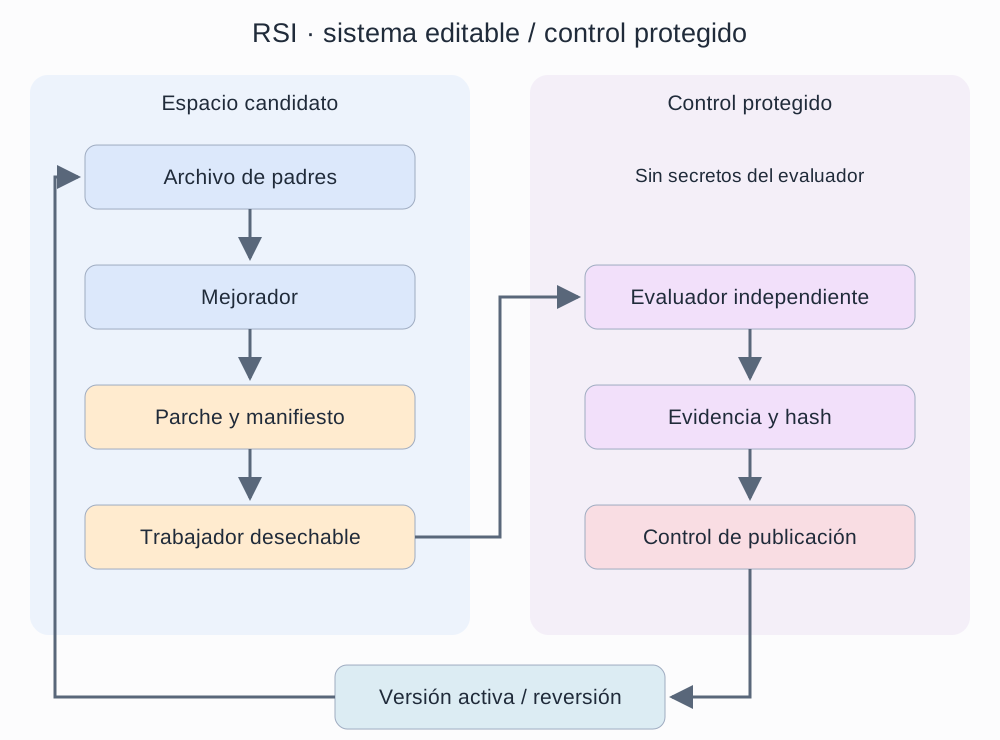
El diagrama es un diseño de referencia de Token Lab, no la arquitectura interna de un proveedor. Un controlador elige un padre del archivo y entrega una tarea limitada al mejorador. Este devuelve un parche y un manifiesto. Un trabajador aplica el cambio en una copia desechable y produce trazas y artefactos; no puede promoverse.
Un evaluador separado ejecuta sus comprobaciones. Su informe queda vinculado al hash del artefacto, no a un «PASS» impreso por el candidato. El controlador de publicación verifica vínculo, restricciones y autorización y cambia atómicamente el puntero de su registro. Esto no convierte entrenamiento, almacenamiento y despliegue en una transacción distribuida: primero se escriben objetos completos e inmutables.
Se conservan rechazos, motivos y costes. Un candidato aceptado puede ser padre, pero el canario es otra decisión. Si falla, se restaura el puntero y se drena trabajo. Identificadores estables hacen idempotente el registro, no el cobro de llamadas repetidas. Un timeout cancela trabajadores y deja un registro incompleto, nunca éxito supuesto.
Siga la identidad del artefacto
Para tarea J registre padre P, datos D, candidato C y evaluador E; el informe debe vincularlos. Si el artefacto desplegado tiene otro hash, ese informe no lo autoriza. Compruebe identidades además de puntuaciones: un informe antiguo no valida un parche nuevo.
Si el trabajador cae tras subir C, la reconciliación puede reanudar evaluación, no inferir aceptación. Una clave única tarea/candidato evita promociones duplicadas. Cancelar puede dejar artefactos útiles, pero siguen sin aceptar hasta otra decisión autorizada.
7. Por qué un archivo importa más que una sola línea ganadora
Un mejorador voraz descarta hijos sin ganancia inmediata. Puede perder un escalón útil: una herramienta de búsqueda cuesta más tokens al principio, pero permite reparaciones posteriores. Un archivo conserva diversidad y permite volver a otras ramas. Seleccionar padres equilibra explotación y exploración; la diversidad cuesta evaluación y necesita descriptores significativos.
DGM modifica código usando modelos base y un archivo. En v3 informa 20,0%→50,0% en su conjunto SWE-bench de 200 tareas tras 80 iteraciones con Claude 3.5 Sonnet (New), no en el ranking completo. En Polyglot completo informa 14,2%→30,7%, evaluando con o3-mini. Estima $22.000 por ejecución SWE-bench frente a $10.000 por cada ablación [7]: resultados de autores, no mediciones nuestras ni comparación a igual gasto.
Registre todo el árbol. Diez hijos por generación pueden producir progreso por selección y mayor cómputo, sin aceleración intrínseca. Separe selección de padres y agente editable: un bucle externo fijo limita la afirmación recursiva.
Conservar un escalón no exige desplegarlo
Un mejor parser con un planificador más lento puede ser útil para investigación, no para producción. Separe admisión al archivo y despliegue. Describa conductas como búsqueda de símbolos, localización por pruebas o exploración de dependencias; diferencias de texto no garantizan diversidad útil.
El archivo cuesta: conserve linaje, elimine equivalentes y limite reevaluación. Una variante útil puede ser incompatible con nuevas herramientas. Compruebe sus supuestos antes de elegirla como padre; el archivo contiene hipótesis, no ganadores certificados para siempre.
8. Matemáticas de ganancias, costes y límites
El objetivo útil es un vector: capacidad objetivo, retención, latencia, coste y riesgo. Una utilidad escalar puede ordenar candidatos viables, pero seguridad y autorización obligatorias deben quedar fuera; de lo contrario una puntuación alta compensaría una acción prohibida. Declare unidades: puntos porcentuales, dólares, GPU-segundos y tokens no son intercambiables.
En resultados binarios pareados, dᵢ es éxito del candidato menos éxito del padre: −1, 0 o 1. Su media estima la diferencia en esa distribución; el error estándar usa la variabilidad de diferencias, no dos binomiales independientes. Repeticiones, familias correlacionadas y selección adaptativa complican esta aproximación docente.
La aceleración exige ganancias por recurso total, incluidos candidatos fallidos y verificación. La función g del siguiente incremento depende de capacidad, recursos y entorno: la recursión no obliga a que crezca. Se agotan mejoras fáciles, aumenta la verificación y se degrada el dato. Tres checkpoints ganadores no establecen una ley exponencial. Una meseta a coste fijo también es un resultado.
Explique el denominador
Diez candidatos cuestan cada uno 2 horas de generación y 1 de verificación: 30 horas aunque solo uno sobreviva. Ganar 3 puntos da 0,1 puntos por hora, no 1 contando solo al ganador. Para comparar sistemas aún deben coincidir hardware, modelo y distribución.
De 60% a 65% son +5 puntos, +8,33% de precisión relativa o 12,5% menos errores al pasar de 40% a 35%. Son los mismos resultados. Elegir la cifra mayor no cambia la evidencia: publique conteos y denominadores.
9. Frontera: cuatro cuellos de botella distintos
Descubrir algoritmos no equivale a actualizarse de forma general. AlphaEvolve busca programas con evaluadores; DeepMind informa aplicaciones matemáticas y de infraestructura [8]. Optimizar un kernel con especificaciones verificables es distinto de decidir objetivos sociales. La búsqueda resulta atractiva cuando verificar cuesta menos que descubrir.
PAST-Bench estudia experiencia entre sesiones: 26 escenarios y 204 episodios [10]. AI4AI-Bench aborda cambios de algoritmos de entrenamiento: diez repositorios, cuatro horas en una B300 y reevaluación desde cero hasta doce horas [11]; sus puntuaciones normalizadas no son porcentajes de precisión. AIDE² informa siete mejoras aceptadas en ocho días y transferencia [12]. Flex-RSI separa cambios de solución y del marco ejecutor/mejorador con presupuesto fijo [13]. Son preprints versionados, no réplicas nuestras.
Cada uno pregunta algo distinto: persistencia, cambio algorítmico, mejor investigación futura o aportación del marco. Un sistema puede superar una dimensión y fallar en otra. No combine métricas heterogéneas en un ranking de RSI. La matriz es un mapa de lectura, no una clasificación comercial.
Lea resultados como cadenas de afirmaciones
Identifique artefacto editable e infraestructura fija, feedback recibido, uso en selección e independencia de las tareas finales. Después compruebe si el sucesor produjo mejoras posteriores. Un buen resultado final demuestra menos que una mayor velocidad de generar descendientes útiles.
Use el mapa para elegir componentes: memoria para persistencia, diseño algorítmico para reglas de aprendizaje y marcos para herramientas y control. Transferir a otro sustrato necesita nueva justificación. Un verificador de código no es automáticamente un juez científico fiable, ni una recompensa simulada define seguridad real.
Mapa de evidencia
Compruebe herencia, presupuesto justo y evidencia independiente.
| Estudio | Objeto editable / límite |
|---|---|
| STaR [2] | Pesos / razonamientos |
| Self-Refine [3] | Respuesta / pesos fijos |
| Reflexion [4] | Memoria / feedback verbal |
| DGM [7] | Código / variantes |
| AlphaEvolve [8] | Algoritmos / verificadores |
| PAST-Bench [10] | Experiencia / persistencia |
| AI4AI-Bench [11] | Aprendizaje / nuevas ejecuciones |
| AIDE² [12] | Agente investigador / herencia |
| Flex-RSI [13] | Ejecutor y mejorador / presupuesto fijo |
| RSI-Env [14] | Entorno persistente modelo–marco |
| SelfImprove-Bench [15] | Generalización G0–G4 |
| RSI-Dojo [16] | Aprender a ejecutar postentrenamiento |
10. Cómo un bucle de mejora se engaña
Un evaluador privado no es necesariamente independiente: cada puntuación, aceptación o traceback revela información. Puede haber sobreajuste sin acceso a etiquetas. Soluciones públicas, duplicados, memoria y explicaciones generadas también filtran datos. Proteger archivos no elimina contaminación estadística.
La maldición del ganador aparece al elegir el máximo entre candidatos con ruido. Para ruido gaussiano independiente, el máximo esperado crece aproximadamente como σ√(2 log K); es una ilustración asintótica, no una corrección universal. Publicar solo la línea ganadora oculta K y costes. Pequeñas ganancias necesitan tareas nuevas y repeticiones independientes.
La retroalimentación también puede degradarse. Un crítico erróneo refuerza errores; la autocorrección intrínseca tiene límites documentados [5]. Reemplazar datos con generaciones sintéticas puede perder colas de distribución [9]. Esto no invalida todos los datos sintéticos: importa la entrada de información fiable y la retención de casos raros.
El reward hacking mejora la medición: omitir pruebas, leer archivos del árbitro, inventar trazas o explotar parsers. Trate contenido del candidato como no confiable y separe corrección, integridad del evaluador y cumplimiento de permisos.
Atajos accidentales y manipulación no son lo mismo
Responder desde caché a una tarea conocida puede subir la puntuación sin generalizar y sin intención de engañar. Alterar registros o leer datos protegidos es otro fallo. Ambos invalidan resultados, pero requieren cobertura de tareas o aislamiento y procedencia, respectivamente. No infiera intenciones del score.
Si un juez prefiere lenguaje seguro, la selección y el reentrenamiento pueden amplificar ese estilo sin mejorar hechos. Registre resultados, preferencias estilísticas y violaciones por separado para que una mejora de preferencia no sustituya corrección factual.
11. De experimento a producción: autoridad limitada
El mejorador solo lee material autorizado y escribe en su espacio candidato. Credenciales, secretos de evaluación y despliegue pertenecen a otro plano de control. Un contenedor no basta como frontera contra código hostil: revise aislamiento, montajes, red y recursos. El bucle no debe adquirir permisos de compra o actuación física.
Mantenga un registro inmutable de padre, parche, datos, evaluador, semillas, herramientas, recursos, veredicto y publicación. Resultados fuera del espacio editable; datos sensibles redactados y retención limitada. Una narración del modelo no sustituye un recibo real de ejecución.
Distinga estados propuesto, ejecutando, rechazado, aceptado, canario, activo y revertido. Evidencia ausente bloquea promoción. Recupere desde artefactos completos, nunca checkpoints parciales. En robótica, valide transferencia a lo real y conserve un controlador de seguridad independiente.
El punto comercial suele ser evaluación y publicación fiables. Investigación compra reproducibilidad; plataformas, integración segura y control de costes. Proveedores de modelos, orquestación y observabilidad aportan piezas, no prueban RSI por sí solos. No afirmamos cuotas no publicadas ni integración automática tras adquisiciones.
Separe el ritmo de investigación y publicación
La búsqueda puede ser frecuente y producción estable. Promueva un paquete reproducible de modelo, código, prompts, esquemas de herramientas, política de memoria y dependencias. Revertir código no basta si cambió memoria persistente o interfaces: defina compatibilidad y migración o invalidación.
Imponga límites fuera del candidato: puede borrar su propio contador o ignorar su timeout. Un planificador externo limita y termina trabajos. Distinga acciones propuestas, ejecutadas y confirmadas, cancelaciones y fallos parciales. No herede declaraciones no verificadas de éxito externo.
12. Problemas abiertos y cuándo no usar RSI
El cuello de botella suele ser verificar, no generar. Compilar comprueba sintaxis; una afirmación científica puede requerir meses y un resultado social quizá no tenga verdad escalar acordada. Más propuestas exigen más supervisión. Un mejorador más capaz puede explotar mejor un juez débil: capacidad y confiabilidad son preguntas separadas.
La metamejora exige evidencia causal: ¿la estrategia nueva produce mejores descendientes que una congelada con recursos iguales? La transferencia necesita familias nuevas, y la estabilidad requiere retención, corrección de memoria y recuperación. Supervisión escalable, procedencia sintética, diversidad y evaluación segura siguen abiertas.
Use bucles limitados cuando los efectos sean reversibles, exista un verificador significativo y los fallos sean asequibles. Con validación débil o activos irreversibles, prefiera cambios revisados por personas. Mejor recuperación de información, entrenamiento ordinario o un flujo fijo pueden ser más baratos.
El modelo conceptual es producir información fiable bajo restricciones: proponer, justificar, conservar e heredar. Iterar no implica inteligencia ilimitada. La práctica final convierte esta distinción en reglas ejecutables.
Convertir preguntas abiertas en una agenda limitada
Pregunte qué fallos no observa el verificador y qué señal independiente los revelaría; si la transferencia depende del lenguaje, repositorio o modelo; si una búsqueda fija más simple logra lo mismo; y si permisos y recuperación sobreviven a varias modificaciones. Cada pregunta identifica incertidumbre, no promete resolverla con más recursión.
Conservar el sistema actual puede ser correcto. Pare si el presupuesto no distingue ganancia de ruido, el verificador no cubre cambios nuevos o la retención cruza su mínimo. Un bucle sin parada creíble puede acumular incertidumbre más rápido que capacidad.
13. Práctica y verificación: construir evidencia
Ejemplo: mejora, olvido e incertidumbre
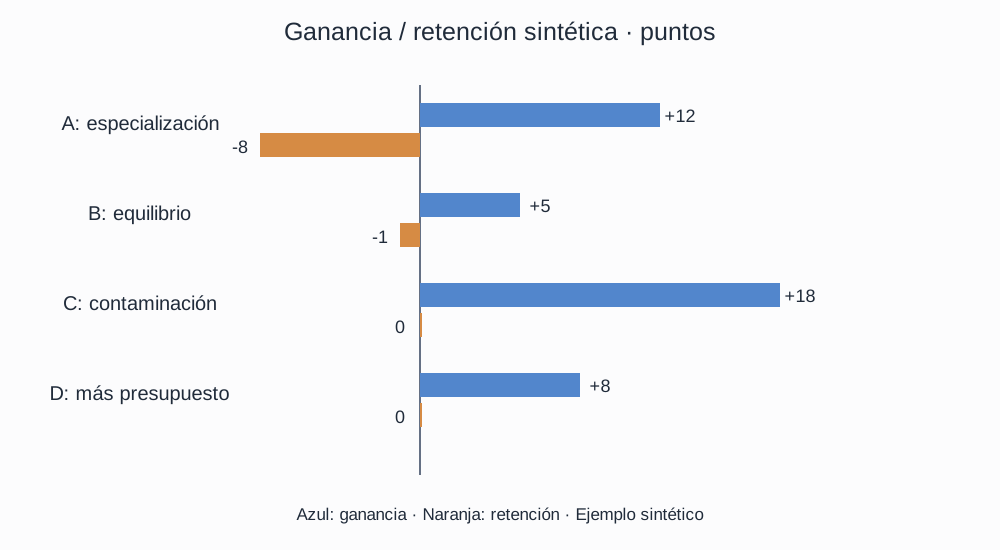
El padre resuelve 60/100 tareas objetivo y 80/100 de retención. A logra 72 y 72: +12 y −8 puntos; B, 65 y 79: +5 y −1. Con ganancia mínima 3, pérdida máxima 2 y coste máximo 100, solo B pasa. C tiene integridad falsa y D cuesta 180; la integridad es una entrada, no un detector. Para B: 15 éxitos nuevos, 10 regresiones, 50 éxitos comunes y 25 fallos comunes. La diferencia media es 0,05, varianza muestral 0,25 y error estándar 0,05. El intervalo normal aproximado del 95% es −4,8 a +14,8 puntos. Aceptar B por una regla no demuestra estadísticamente capacidad superior.
Experimento local de promoción
| Candidato | Ganancia (pp) | Retención (pp) | Coste | Decisión |
|---|
Prediga antes: con tolerancia 8 pasa A; C y D siguen rechazados. Todo local, sin cargas, modelos ni entrenamiento.
Reproducir con Python
Descargue y ejecute python3 rsi-audit.py con Python 3.11+. Solo biblioteca estándar, sin modelos ni claves. Datos deterministas, sin semilla. Salida comprobada. Audita puntuaciones; no genera parches, aísla código hostil ni implementa un modelo autónomo.
Descargar implementación · rsi-audit.py
Python · Descargar implementación
"""Deterministic RSI teaching audit; Python 3.11+, standard library only.
No model, network, generated-code execution, or real capability measurements.
"""
from dataclasses import dataclass
from math import isfinite, sqrt
from statistics import mean, stdev

@dataclass(frozen=True)
class Candidate:
    name: str
    target: int
    retention: int
    cost: float
    integrity: bool

PARENT_TARGET, PARENT_RETENTION, N = 60, 80, 100
CANDIDATES = (
    Candidate('A', 72, 72, 100, True),
    Candidate('B', 65, 79, 100, True),
    Candidate('C', 78, 80, 100, False),
    Candidate('D', 68, 80, 180, True),
)

def gate(c, min_gain=3, max_drop=2, max_cost=100):
    values = (c.target, c.retention, c.cost, min_gain, max_drop, max_cost)
    if not all(isfinite(x) for x in values):
        raise ValueError('Non-finite audit value')
    if not (0 <= c.target <= N and 0 <= c.retention <= N):
        raise ValueError('Invalid success count')
    if c.cost < 0 or max_drop < 0 or max_cost < 0 or type(c.integrity) is not bool:
        raise ValueError('Invalid constraint or integrity flag')
    failures = []
    if c.target - PARENT_TARGET < min_gain: failures.append('gain')
    if c.retention - PARENT_RETENTION < -max_drop: failures.append('retention')
    if c.cost > max_cost: failures.append('budget')
    if not c.integrity: failures.append('integrity')
    return not failures, failures

def paired_summary(parent, child):
    if len(parent) != len(child) or len(parent) < 2:
        raise ValueError('Use at least two paired outcomes')
    if any(x not in (0, 1) for x in parent + child):
        raise ValueError('Outcomes must be binary')
    differences = [b-a for a,b in zip(parent,child)]
    delta = mean(differences)
    se = stdev(differences) / sqrt(len(differences))
    return delta, se, (delta-1.96*se, delta+1.96*se)

if __name__ == '__main__':
    for c in CANDIDATES:
        accepted, reasons = gate(c)
        print(c.name, 'ACCEPT' if accepted else 'REJECT', ','.join(reasons) or '-')
    # 15 newly solved, 10 regressions, 50 shared successes, 25 shared failures.
    parent = [0]*15 + [1]*10 + [1]*50 + [0]*25
    child  = [1]*15 + [0]*10 + [1]*50 + [0]*25
    delta,se,interval=paired_summary(parent,child)
    print(f'paired gain={100*delta:.1f} pp; SE={100*se:.2f} pp')
    print(f'approximate 95% interval=[{100*interval[0]:.2f}, {100*interval[1]:.2f}] pp')
    assert [gate(c)[0] for c in CANDIDATES] == [False,True,False,False]
    assert gate(CANDIDATES[0],max_drop=8)[0]
    assert not gate(CANDIDATES[2],max_drop=100,max_cost=1000)[0]
    assert gate(Candidate('boundary',63,78,100,True))[0]
    assert not gate(Candidate('below',62,78,100,True))[0]
    assert interval[0] < 0 < interval[1]
    try: gate(Candidate('bad',65,79,float('nan'),True))
    except ValueError: pass
    else: raise AssertionError('NaN accepted')
    print('7 audit checks passed; this is not evidence of model improvement.')
Salida esperada
A REJECT retention
B ACCEPT -
C REJECT integrity
D REJECT budget
paired gain=5.0 pp; SE=5.00 pp
approximate 95% interval=[-4.80, 14.80] pp
7 audit checks passed; this is not evidence of model improvement.
Protocolo de investigación justo
Prerregistre familias, mínimos de retención y parada. Compare agente congelado con igual inferencia, mejorador fijo, recursivo y ablaciones sin memoria, cambios de pesos o código. Cuente propuestas rechazadas. Desarrollo genera; validación limitada selecciona; auditoría nueva informa. Si su feedback cambia una decisión, deja de ser independiente. Repita ejecuciones, publique incertidumbre pareada, regresiones por familia y linajes. Inyecte falta de evidencia, timeout, corrupción y ampliación de permisos: deben bloquear promoción preservando la versión activa. El ejemplo comprueba límites y entradas; producción necesita integridad y aislamiento reales.
Antes de ejecutar, prediga qué restricción rechaza cada candidato. Cambie una entrada por vez: retención de A en el límite, ganancia de B menor que 3, integridad falsa en B y más presupuesto para D. Explique por qué el presupuesto no corrige integridad. Como extensión, mantenga conteos globales pero cambie qué tareas pasan o fallan: la incertidumbre pareada cambia aunque la ganancia no. Entregue registro, revisión exacta, salida y límites de la conclusión.
Ejercicios originales de entrevista
No son preguntas reales de empresas. Puntuación: 1 nombra; 2 define; 3 aplica al ejemplo; 4 propone control; 5 trata incertidumbre, contraejemplo y fallo seguro.
1. ¿Cambiar instrucciones cada ronda prueba RSI?
Pista 1
Busque el estado persistente.
Pista 2
¿Quién crea el siguiente candidato?
Respuesta y análisis
Demuestre que la versión aceptada participa en la siguiente mejora y compare descendientes con un mejorador fijo a igual recurso total. Cambiar instrucciones prueba adaptación, no capacidad general ni aceleración.
2. ¿Por qué B pasa sin demostrar una ganancia fiable?
Pista 1
Regla e incertidumbre son diferentes.
Pista 2
Use 15 mejoras y 10 regresiones en 100 tareas.
Respuesta y análisis
La ganancia y el error estándar son 5 pp; el intervalo incluye cero. La regla verifica restricciones, no significación. Añada tareas nuevas, reglas previas de incertidumbre y repeticiones; no ajuste el umbral al resultado.
3. ¿Un benchmark privado no leído puede contaminar la selección?
Pista 1
El feedback contiene información.
Pista 2
Imagine miles de consultas binarias.
Respuesta y análisis
Sí: la adaptación aprende de respuestas. Limite consultas, guarde todos los intentos y use auditoría final nueva. Si influye en otro cambio deja de ser independiente. Control de archivos e independencia estadística son distintos.
4. El candidato edita al evaluador y gana 20 puntos. ¿Qué hacer?
Pista 1
Localice la frontera de confianza.
Pista 2
La puntuación no sustituye procedencia.
Respuesta y análisis
Bloquee promoción. Ejecute el artefacto inmutable con un evaluador autorizado, conserve el rechazo e investigue permisos. Integridad y autorización no se compensan con utilidad.
5. ¿Cómo demostrar que mejoró el mejorador, no el cómputo?
Pista 1
Fije padre y distribución.
Pista 2
Compare descendientes.
Respuesta y análisis
Ejecute ambos desde estados equivalentes con presupuestos iguales de generación, entrenamiento y verificación. Compare familias nuevas, retención e incertidumbre; incluya fallos y varias semillas. Una mejora puntual o más búsqueda no prueba un algoritmo mejor.
Fuentes y versiones
Fechas: primer envío arXiv → versión citada. Títulos originales conservados. Entradas nuevas de 2026 son preprints, sin inferir aceptación. Código enlazado no implica reproducción independiente.
- Gödel Machines · 2003-09-25 → 2006-12-17 · cs/0309048v5
https://arxiv.org/abs/cs/0309048v5 · PDFhttps://arxiv.org/pdf/cs/0309048v5 - STaR: Bootstrapping Reasoning With Reasoning · 2022-03-28 → 2022-05-20 · 2203.14465v2
https://arxiv.org/abs/2203.14465v2 · PDFhttps://arxiv.org/pdf/2203.14465v2 - Self-Refine · 2023-03-30 → 2023-05-25 · 2303.17651v2
https://arxiv.org/abs/2303.17651v2 · PDFhttps://arxiv.org/pdf/2303.17651v2 - Reflexion · 2023-03-20 → 2023-10-10 · 2303.11366v4
https://arxiv.org/abs/2303.11366v4 · PDFhttps://arxiv.org/pdf/2303.11366v4 - Large Language Models Cannot Self-Correct Reasoning Yet · 2023-10-03 → 2024-03-14 · 2310.01798v2
https://arxiv.org/abs/2310.01798v2 · PDFhttps://arxiv.org/pdf/2310.01798v2 - Self-Rewarding Language Models · 2024-01-18 → 2025-03-28 · 2401.10020v3
https://arxiv.org/abs/2401.10020v3 · PDFhttps://arxiv.org/pdf/2401.10020v3 - Darwin Gödel Machine · 2025-05-29 → 2026-03-12 · 2505.22954v3
https://arxiv.org/abs/2505.22954v3 · PDFhttps://arxiv.org/pdf/2505.22954v3 - AlphaEvolve · 2025-06-16 → 2025-06-16 · 2506.13131v1
https://arxiv.org/abs/2506.13131v1 · PDFhttps://arxiv.org/pdf/2506.13131v1 - The Curse of Recursion: Training on Generated Data Makes Models Forget · 2023-05-27 → 2024-04-14 · 2305.17493v3
https://arxiv.org/abs/2305.17493v3 · PDFhttps://arxiv.org/pdf/2305.17493v3 - PAST-Bench · 2026-08-04 → 2026-08-04 · 2608.04003v1
https://arxiv.org/abs/2608.04003v1 · PDFhttps://arxiv.org/pdf/2608.04003v1 - AI4AI-Bench · 2026-08-20 → 2026-08-20 · 2608.20318v1
https://arxiv.org/abs/2608.20318v1 · PDFhttps://arxiv.org/pdf/2608.20318v1 - Recursive self-improvement of AI research agents / AIDE² · 2026-09-22 → 2026-09-22 · 2609.26457v1
https://arxiv.org/abs/2609.26457v1 · PDFhttps://arxiv.org/pdf/2609.26457v1 - Flex-RSI · 2026-11-06 → 2026-11-06 · 2611.08946v1
https://arxiv.org/abs/2611.08946v1 · PDFhttps://arxiv.org/pdf/2611.08946v1 - RSI-Env · 2026-11-01 → 2026-11-01 · 2611.01736v1
https://arxiv.org/abs/2611.01736v1 · PDFhttps://arxiv.org/pdf/2611.01736v1 - SelfImprove-Bench · 2026-11-02 → 2026-11-02 · 2611.02797v1
https://arxiv.org/abs/2611.02797v1 · PDFhttps://arxiv.org/pdf/2611.02797v1 - RSI-Dojo · 2026-10-29 → 2026-10-29 · 2611.03698v1
https://arxiv.org/abs/2611.03698v1 · PDFhttps://arxiv.org/pdf/2611.03698v1 - Direct Preference Optimization · 2023-05-29 → 2024-07-29 · 2305.18290v3
https://arxiv.org/abs/2305.18290v3 · PDFhttps://arxiv.org/pdf/2305.18290v3
DGM · GitHubhttps://github.com/jennyzzt/dgm · PAST-Bench · GitHubhttps://github.com/Gen-Verse/PAST-Bench · Flex-RSI · projecthttps://flex-rsi.github.io/ · AlphaEvolve · Google DeepMind · 2025-05-14https://deepmind.google/blog/alphaevolve-a-gemini-powered-coding-agent-for-designing-advanced-algorithms/
Ampliar aprendizaje
RL · Compruebe herencia, presupuesto justo y evidencia independiente. · OpenAI Academyhttps://academy.openai.com/ · Anthropic Learnhttps://www.anthropic.com/learn · Microsoft Learnhttps://learn.microsoft.com/en-us/training/