Por qué los idiomas, emojis y JSON cambian el recuento
Compara texto multilingüe y distingue caracteres, bytes y tokens.
Tres medidas diferentes
Los puntos de código Unicode representan texto; los bytes UTF-8, su almacenamiento; los tokens, su representación con un vocabulario concreto. Un emoji visible puede contener varios puntos de código, y un punto puede ocupar varios bytes o tokens.
La aproximación inglesa de cuatro caracteres por token no sirve como presupuesto multilingüe. Mide tu prompt real con su codificación.
Study guide & lesson outlineLEARNING CONTRACT
Understand → implement → investigate
Goal: explain the mechanism in this lesson, reproduce one example and test a failure case. Reading alone does not mark mastery.
Understand: state assumptions, shapes/units and a counterexample.
Implement: reproduce a numerical example and inspect boundaries.
Investigate: compare one alternative under a matched budget.
Compara la misma entrada
Carga Idiomas y emojis y pulsa Comparar codificaciones. Ambos recuentos usan exactamente el mismo texto. Repite con tus prompts en español, japonés, coreano o chino: la proporción puede cambiar entre ejemplos.
JSON añade claves, comillas, signos y espacios. Compara una versión formateada con otra compacta. Eliminar espacios reduce bytes, pero el efecto sobre tokens depende de la codificación y del texto cercano.
import { encode } from 'gpt-tokenizer/encoding/cl100k_base';
// npm install gpt-tokenizer@4.1.0
const samples = [
'Hello, world!', '你好,世界!',
'¡Hola, mundo!', 'こんにちは、世界!',
'안녕하세요, 세계!', '👨👩👧👦'
];
for (const text of samples) {
const ids = encode(text);
console.log(text, ids.length);
}
Elimina primero campos innecesarios, documentos repetidos e historial irrelevante. Conserva las restricciones y la evidencia. Un prompt visualmente más corto no siempre tiene menos tokens, y reducirlos no garantiza mantener la calidad.
Crea un pequeño conjunto de pruebas multilingües. Tras cada cambio, evalúa tanto el recuento como la corrección de las respuestas. No uses estas codificaciones como contadores exactos de tokenizadores ajenos.
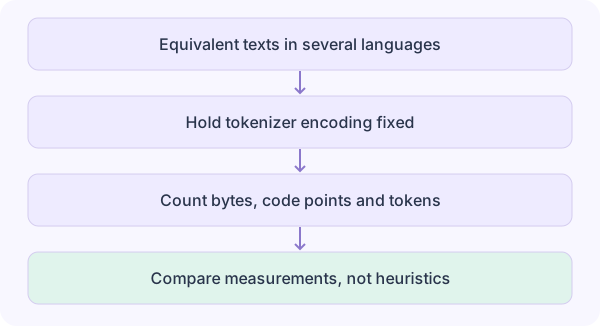
Hold encoding and text fixed. Record UTF-8 bytes, code points and tokens separately; the English 4-characters-per-token rule is not a multilingual formula.
Shared code, English mathematical explanation and key multilingual numeric passages reviewed. This is not a full translation proofread.
Mechanism map: follow the transformations from top to bottom.
Before running: predict a boundary case
Hold encoding and text fixed. Record UTF-8 bytes, code points and tokens separately; the English 4-characters-per-token rule is not a multilingual formula.
Hint: isolate the assumption
Keep the baseline input fixed, change one parameter or boundary, and compare both the numerical result and the claimed units. A passing example verifies this fixture only.
Minimal executable example
Save the example and linked modules in one folder. Use Node.js 22 or newer, then run node multilingual-tokenization.mjs. npm install gpt-tokenizer@4.1.0
import { encode } from 'gpt-tokenizer/encoding/cl100k_base';
// npm install gpt-tokenizer@4.1.0
const samples = [
'Hello, world!', '你好,世界!',
'¡Hola, mundo!', 'こんにちは、世界!',
'안녕하세요, 세계!', '👨👩👧👦'
];
for (const text of samples) {
const ids = encode(text);
console.log(text, ids.length);
}
Hold encoding and text fixed. Record UTF-8 bytes, code points and tokens separately; the English 4-characters-per-token rule is not a multilingual formula.
Record input, code version, expected result and observed result in the notebook below. Then construct a counterexample that violates the assumption above and explain why the original conclusion no longer follows.
Before revealing an answer, predict one result. After the exercise, record the discrepancy and a transfer test. Saved locally across language editions.
The mathematical review scope is recorded per lesson. It does not establish empirical paper reproduction; report suspected errors in your notes. Review scope