Stanford CS329Z: guía completa de ingeniería de agentes
Comprenda el programa, construya un harness, diseñe una tarea de evaluación y encuentre las clases, lecturas y trabajos publicados.
Fuentes y versiones
En este artículo
Qué enseña el curso y qué es público
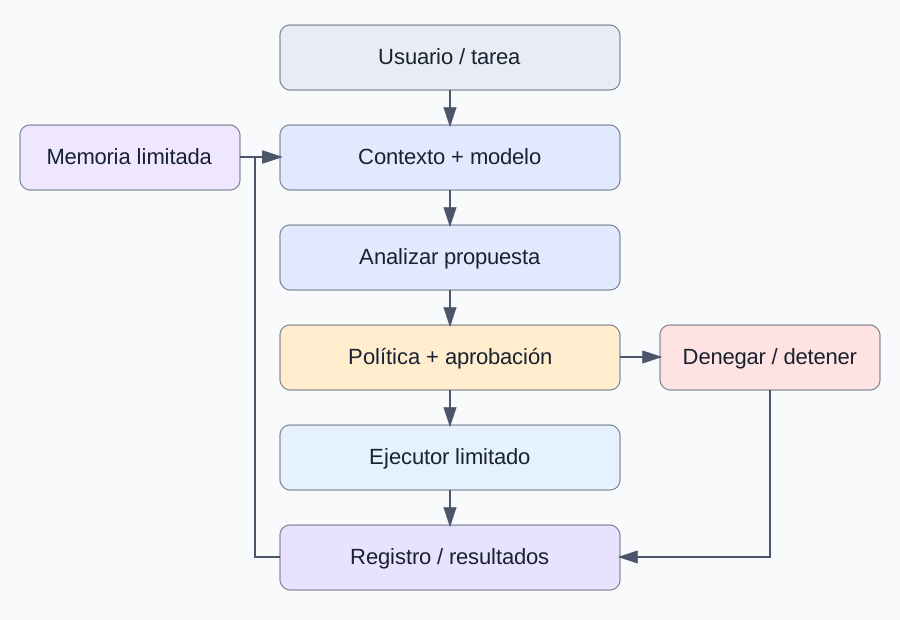
Un harness convierte la salida del modelo en interacción controlada: analiza acciones, registra herramientas, aplica límites, administra contexto y estado, y decide cuándo detenerse. El modelo propone; el programa decide si la acción es válida, autorizada y ejecutable. El recorrido empieza por flujos fijos, continúa con bucles dirigidos por el modelo y termina con evidencia de funcionamiento.
CS329Z es Engineering AI Agents, Stanford, otoño de 2026, con Diyi Yang, Michael Ryan y John Yang. El 11 de noviembre, el calendario enlazaba 13 PDF, dos vídeos públicos y el código de la quinta clase. Los dos repositorios de tareas y sus enunciados 26.1.0 eran públicos. Una clase programada no implica que exista grabación pública. La página logística todavía menciona Canvas: utiliza los enlaces públicos verificados, sin asumir acceso a Canvas.
Esta guía independiente de Token Lab no es un curso, certificado, solucionario oficial ni transcripción de Stanford. Revisamos calendario, normas, enunciados y configuración de repositorios; no vimos todas las clases ni ejecutamos las evaluaciones de pago. Las explicaciones, figuras y ejercicios adicionales son nuestros. Los materiales oficiales permanecen en sus sitios originales.
Requisitos para construir de verdad
El requisito oficial es formación NLP equivalente a CS224N, CS224U, CS224V o CS336. Para estudiar por tu cuenta necesitas diccionarios, tipos, excepciones, archivos y pruebas de Python: una llamada a herramienta es un objeto; un subproceso fallido debe producir un resultado explícito. HTTP, variables de entorno y Git permiten separar secretos, código y resultados.
Comprende predicción del siguiente token, muestreo y mensajes frente a tokens. El contexto limita la información visible ahora; el almacenamiento conserva hechos fuera del prompt. Recuperar por similitud no verifica la verdad. La probabilidad distingue éxito ocasional y fiabilidad; álgebra básica basta para BM25 y costes. Docker reproduce archivos y procesos, pero no garantiza permisos seguros ni respuestas deterministas.
Empieza con datos pequeños e identidades sintéticas. No subas el correo de tu empresa por imitar el ejercicio: el archivo educativo tiene procedencia propia. Si no puedes explicar una función escrita con IA, reduce su alcance y reconstruye su flujo de datos antes de avanzar.
Cómo se conectan las clases
El bloque inicial conecta agentes, LLM, recuperación y herramientas. Un flujo fijo elige el siguiente paso en código; un agente delega parte de esa elección al modelo. Mensajes, selección de evidencia y esquemas se convierten en semántica del programa. RAG selecciona evidencia bajo presupuesto; las herramientas cambian estado. No convierta instrucciones recuperadas en autorización.
Tras implementar el bucle, evalúe frameworks y patrones. Un grafo expone estados y fallos; un bucle libre admite tareas menos previsibles pero amplía el espacio de acciones. La memoria decide qué persiste. Varios agentes requieren propiedad clara de subtareas y estado compartido; añaden coordinación y conflictos, no fiabilidad automática.
El bloque de optimización y datos pregunta qué mejorar y con qué evidencia. Datos repetidos fáciles no cubren fallos nuevos. Separe entrenamiento, desarrollo y evaluación reservada antes de ajustar. Terminal-Bench conecta implementación con tarea, entorno y verificador. La calidad y el benchmark determinan qué significa un resultado en esa distribución.
El resto del programa incluye jueces LLM, infraestructura, SWE-bench, seguridad, agentes de programación y proactivos, conversación con Andrew Ng y demos. Son temas del calendario, no resúmenes de grabaciones inéditas. Un agente proactivo necesita de antemano disparador, alcance, presupuesto y parada. La seguridad pertenece al diseño, no a una frase final del prompt. Consulte nuevas publicaciones en el programa.
Tarea 1: de flujos fijos a un runtime
La primera tarea elimina los frameworks: LM recibe mensajes role/content y devuelve texto. Debes describir herramientas, interpretar llamadas y ejecutarlas. Los adapters son el contrato de las pruebas; implementa dentro de cs329z_hw1, conserva los tipos y no modifiques el evaluador ni añadas dependencias. NumPy ya está disponible. El objetivo es un harness educativo, no reproducir todas las funciones de Claude Code o Codex.
Los cuatro primeros problemas construyen prioridad de correos, resumen diario, BM25 y preguntas multisalto. BM25 combina rareza del término, saturación de frecuencia y normalización por longitud: repetir veinte veces una palabra no multiplica por veinte la evidencia. Una pregunta puede necesitar un correo que identifique al responsable y otro con una decisión posterior; hay que unir pruebas, no resumir el primer resultado.
Después se añaden registro, protocolo textual, bucle acotado, herramientas corporativas, búsqueda y terminal. La salida del modelo es entrada no confiable. Valida nombre y argumentos antes de pedir aprobación; registra rechazos y errores como observaciones. Separa ejecución real y texto mostrado. El modo de confirmación del curso controla acciones no solo de lectura; producción también necesita permisos por recurso y reglas de divulgación.
Compresión, memoria persistente, intervención del usuario y guardrails completan el sistema. La compresión pierde información: conserva restricciones, acciones pendientes y referencias. Aísla memoria por directorio y usuario. Mantén un registro de acciones independiente de resúmenes del modelo. El sandbox educativo no es una frontera de producción: revisa sandbox.jail(), especialmente en Windows, donde la documentación indica none.
Tarea 2: medir la capacidad correcta
Harbor organiza la evaluación, Docker proporciona el entorno y mini-SWE-agent es el sistema evaluado. El paquete define petición, archivos iniciales, dependencias, límites, verificador y solución oracle. Esta última demuestra que la tarea es resoluble y debe quedar fuera del alcance del agente. La recompensa se obtiene del estado final, no de la afirmación del modelo.
El recorrido pasa de HumanEval local a SWE-bench Verified y Terminal-Bench 2.1 antes de crear una tarea propia. La versión 26.1.0 pide cinco intentos independientes de mini-SWE-agent con Gemini 3.8 Flash mediante pinned_agent.py. Conserva las versiones: Python >=3.12,<3.14 y Harbor 0.18.0. Son requisitos de esta edición, no recomendaciones universales.
Define una capacidad concreta, por ejemplo reparar una configuración sin modificar servicios ajenos. Comprobar solo que existe un archivo es débil; exigir el mismo parche que el oracle rechaza alternativas válidas. Verifica postcondiciones, invariantes y efectos prohibidos. Evita respuestas en la imagen, filtración de pruebas, servicios remotos sin versión y dificultad causada por instalaciones rotas.
Los pesos son fundamentos 5%, ejemplos 10%, tarea propia 70% y revisión 15%. Los 70 puntos se reparten en reproducibilidad 10, capacidad 15, fidelidad 15, dificultad 20 e informe 10. El enunciado pide tres revisiones de tareas; la logística general habla de dos compañeros. Conservamos la discrepancia: quien esté matriculado debe consultar la instrucción específica y al profesorado.
Mecanismos que conectan las tareas
Supón que un empleado consulta una política de reembolso y pide actuar. La recuperación aporta evidencia, no autorización. El harness vincula respuesta, documento y versión, valida la llamada y comprueba permisos. No debe eludir un rechazo cambiando de herramienta. Un timeout deja incierto el efecto: consulta el estado antes de reintentar. Es una extensión productiva original, no una garantía del starter.
El modelo no accede directamente a credenciales ni shell. Cada propuesta cruza una política controlada por el host; incluso las lecturas respetan el tenant. Las escrituras llevan aprobación e identificador de operación. Las observaciones se guardan en un registro; el contexto es una selección y la memoria persistente es otro almacén acotado. Solo evidencia de ejecución permite afirmar que una acción terminó.
El presupuesto suma instrucciones, diálogo, observaciones y reserva de salida. En un ejemplo sintético de 16.000 tokens, 2.000 de sistema, 4.000 de diálogo y 2.000 reservados dejan 8.000 de evidencia. Cuatro caracteres por token es una aproximación del curso, no una garantía multilingüe. Usa el tokenizer real en producción.
Con la simplificación de pasos independientes y fiabilidad de 95%, diez pasos necesarios solo tienen 59,9% de éxito conjunto. Las correlaciones reales invalidan usarlo como predicción. El ejemplo motiva recorridos cortos, recuperación y terminación explícita; más herramientas no garantizan fiabilidad.
Entorno, versiones y presupuesto realista
HW1 requiere Python 3.11+ y uv; Windows necesita Git for Windows para Bash o WSL. HW2 fija Python 3.12–3.13, uv y un daemon Docker accesible. El ejemplo SWE-bench en Apple Silicon pide linux/amd64 y puede usar emulación. Separa los entornos y respeta los archivos de bloqueo.
El README de HW1 indica openai/gpt-6-luna para evaluar y openai/gpt-6-sol como juez; HW2 utiliza Gemini 3.8 Flash vía Gemini u OpenRouter. Son identificadores del material revisado, no garantía de acceso o precio. Los externos aportan credenciales y saldo. No creamos claves ni hicimos llamadas de pago; Token Lab no recoge claves ni transmite entradas de estos ejercicios.
El enunciado informa $0,05 por una pasada de pruebas live del ejemplo de referencia y $0,18 por la evaluación final: $0,23 en esa ejecución, no un presupuesto garantizado. Cambios y reintentos generan llamadas nuevas. La caché depende de modelo, muestreo y mensajes exactos; una respuesta cacheada no es un intento independiente.
Configura límite del proveedor y CS329Z_BUDGET_USD. El registro local frena llamadas al alcanzar el umbral, pero no es un límite transaccional entre procesos concurrentes. Borrar .lm_cache elimina respuestas y contabilidad. Guarda versiones, tokens y costes. Ejecutar terminal y Docker localmente no impide que las pruebas live envíen prompts a APIs externas.
Entregables, proyecto y reutilización
La nota general se divide en proyecto 40%, tareas 15%, pruebas orales 15%, vídeo de artículo 10% y revisión 20%. El proyecto incluye propuesta 5%, informe intermedio 5%, demo intermedia 5%, entrega final 15% y demo final 10%. Son normas de matrícula, no créditos para quien siga esta guía. No encontramos una rúbrica final completa pública; el proyecto sugerido es nuestro.
Propón un asistente SRE: lee un incidente sintético, recupera un runbook, diagnostica con evidencia y propone una acción acotada con aprobación. Empieza en solo lectura; añade persistencia y recuperación; compara con el baseline en incidentes congelados, incluidas pruebas sin evidencia y acciones rechazadas. Entrega código, lock, configuración, arquitectura, trazas, costes y operaciones no soportadas.
El vídeo oficial dura 10–15 minutos y combina explicación, crítica y aportación práctica. Su rúbrica es 20+20+20+10; requiere enlace no listado y materiales. Las diapositivas, guion, análisis y narración deben ser propios: IA puede ayudar a comprender y comentar, pero no crear las diapositivas. Tampoco puede escribir informes del proyecto. La ayuda con código exige comprensión y validación, comprobadas oralmente.
Ambas tareas tienen licencia MIT: conserva avisos de copyright y licencia al reutilizar. No extiende automáticamente derechos a vídeos, diapositivas o lecturas ajenas; aquí los enlazamos. Los starters públicos no autorizan publicar soluciones de compañeros. Respeta entrega privada e integridad académica.
Programa y secuencia de aprendizaje
Los recursos aparecen en orden. Sin enlace de vídeo significa que el programa consultado no enlazaba uno público, no que no exista. Los títulos bibliográficos conservan su idioma original.
- Sistemas de agentes Materiales (5)
- LLM para desarrolladores Materiales (5)
- RAG Materiales (4)
- Uso de herramientas Materiales (4)
- Marcos y orquestación Materiales (5)
- Patrones de diseño Materiales (6)
- Memoria Materiales (4)
- Sistemas multiagente Materiales (4)
- Optimización Materiales (4)
- Terminal-Bench Materiales (3)
- Datos para agentes Materiales (3)
- Selección y calidad Materiales (4)
- Evaluación y benchmarks Materiales (4)
- Conversación con Andrew Ng Materiales (0)
- Jueces LLM e infraestructura Materiales (4)
- SWE-bench Materiales (1)
- Seguridad y controles Materiales (6)
- Sin clase Materiales (0)
- Sin clase Materiales (0)
- Agentes de programación Materiales (4)
- Agentes proactivos Materiales (3)
- Demo final Materiales (0)
Fechas y entregas
| Fecha (2026, PT) | Tema |
|---|---|
| 10-09 23:59 | Propuesta |
| 10-30 | Trabajo 1 |
| 11-06 | Informe y demo intermedia |
| 11-13 23:59 | Vídeo del artículo |
| 11-23 23:59 | Tarea del trabajo 2 |
| 11-30 | Reseñas de artículos (2) |
| 12-02 | Reseñas de tareas (3) |
| 12-09 15:30–18:30 | Demo final |
| 12-11 23:59 | Informe final |
Práctica, validación y plan de estudio
Cuatro hitos: semana 1, contrato de mensajes y pruebas deterministas/BM25; semana 2, harness limitado y decisiones de permisos, resumen y memoria; semana 3, tarea con oracle y comprobaciones adversarias; semana 4, cinco intentos controlados, análisis y reporte. Es un plan propio, no un calendario oficial.
Trabajo 1: puntuación
| Módulo | Determinista | API live | Total |
|---|---|---|---|
| priority | 1 | 2 | 3 |
| daily_digest | 1 | 3 | 4 |
| bm25 | 8 | 0 | 8 |
| email_qa | 2 | 6 | 8 |
| tool_registry | 3 | 0 | 3 |
| tool_protocol | 2 | 2 | 4 |
| agent_loop | 8 | 0 | 8 |
| cardinal | 2 | 0 | 2 |
| search_docs | 2 | 3 | 5 |
| terminal | 2 | 4 | 6 |
| compaction | 5 | 3 | 8 |
| memory | 3 | 5 | 8 |
| interactive | 7 | 0 | 7 |
| guardrails | 2 | 2 | 4 |
| sim_eval | 0 | 10 | 10 |
Autoevaluación: 48 + 40 = 88; notas: 10; memoria: 20. Total 118, no 88.
Ejecute primero pruebas deterministas. live y simulation envían datos a proveedores externos y pueden cobrar: son comandos opcionales del curso, no experimentos locales del navegador. Guarde claves en .env fuera de Git. No ejecutamos esas pruebas de pago ni resolvimos los trabajos.
git clone https://github.com/cs329z/assignment1-harness.git
cd assignment1-harness
uv sync
uv run python data/download.py
uv run pytest
CS329Z_EVAL_SLICE=5 uv run pytest -m live -s
uv run python -m cs329z_hw1.simulation --slice 3
uv run python -m cs329z_hw1.chat --mode confirmgit clone https://github.com/cs329z/assignment2-evals.git
cd assignment2-evals
uv sync
uv run python check_submission.pyTrabajo 2: inicio 5%, ejemplos 10%, tarea 70%, revisión 15%. El 70% se reparte en reproducibilidad 10, capacidad 15, fidelidad 15, dificultad 20 e informe 10. Siga el comando del agente fijado en la guía oficial.
uv run harbor run --path tasks/YOUR_TASK_ID --agent-import-path pinned_agent:MiniSweAgent --model openrouter/google/gemini-3.8-flash --env-file .env --n-attempts 5 --n-concurrent 1 --job-name YOUR_TASK_ID-gemini --jobs-dir tasks/YOUR_TASK_ID/artifacts --yesEjercicio local original: cinco intentos no dan certeza
El programa calcula el intervalo Wilson del 95% para 3 éxitos de 5 ensayos Bernoulli independientes: 0.2307–0.8824. Comprueba cero ensayos y extremos. Mide incertidumbre muestral, no validez de la tarea; repetir caché no añade evidencia independiente.
Descargar ejercicio local"""Token Lab original supplement. Python 3.11+, stdlib, no network or randomness."""
from math import sqrt
def wilson(successes, trials, z=1.959963984540054):
if not isinstance(trials, int) or not isinstance(successes, int) or trials <= 0 or not 0 <= successes <= trials:
raise ValueError("Require 0 <= successes <= positive integer trials")
p = successes / trials
denominator = 1 + z*z/trials
center = (p + z*z/(2*trials)) / denominator
half = z * sqrt(p*(1-p)/trials + z*z/(4*trials*trials)) / denominator
return max(0.0, center-half), min(1.0, center+half)
if __name__ == "__main__":
lo, hi = wilson(3, 5)
assert abs(lo - 0.2307242813) < 1e-9
assert abs(hi - 0.8823792258) < 1e-9
assert wilson(0, 5)[0] < 1e-12
assert abs(wilson(5, 5)[1] - 1) < 1e-12
for args in [(0, 0), (6, 5), (-1, 5)]:
try:
wilson(*args)
except ValueError:
pass
else:
raise AssertionError("invalid input accepted")
print(f"3/5: 95% Wilson interval [{lo:.4f}, {hi:.4f}]")
print("PASS: boundaries and invalid inputs")
python3 uncertainty.py
# 3/5: 95% Wilson interval [0.2307, 0.8824]
# PASS: boundaries and invalid inputs
Entrevista original, no preguntas reales de empresas
1. ¿Por qué sintaxis válida no implica autorización?
Pista: separar análisis y política. Valide esquema, identidad, alcance y aprobación en el host;
2. ¿Cinco éxitos en caché prueban fiabilidad?
Pista: cuente muestras independientes. La caché comprueba el circuito, no variación del modelo. Use ejecuciones independientes controladas y reporte configuración, conteos e incertidumbre.
3. ¿Cómo aprobar sin cumplir el objetivo?
Pista: cobertura. Un verificador débil acepta texto fijo o archivos alterados. Pruebe atajos, aísle verificaciones, compruebe estado final y oracle. Dificultad sin validez no ayuda.
Puntuación: 1 nombra; 2 define; 3 explica el mecanismo; 4 trata fallos y alternativas; 5 diseña una prueba justa y limita conclusiones.
Materiales oficiales, vídeos y lecturas
- Curso oficialhttps://cs329z.stanford.edu/
- Reglas del cursohttps://cs329z.stanford.edu/logistics.html
- Trabajo 1 · GitHubhttps://github.com/cs329z/assignment1-harness · PDF v26.1.0https://github.com/cs329z/assignment1-harness/blob/main/cs329z_assignment1_harness.pdf
- Trabajo 2 · GitHubhttps://github.com/cs329z/assignment2-evals · PDF v26.1.0https://github.com/cs329z/assignment2-evals/blob/main/cs329z_assignment2_evaluation.pdf
- Vídeo de artículo · PDFhttps://web.stanford.edu/class/cs329z/assignments/paper_video.pdf
Los recursos aparecen en orden. Sin enlace de vídeo significa que el programa consultado no enlazaba uno público, no que no exista. Los títulos bibliográficos conservan su idioma original.
1. Sistemas de agentes
Wed Sep 23 · 2026
- Diapositivashttps://web.stanford.edu/class/cs329z/slides/lecture01.pdf
- Vídeohttps://youtu.be/DGI4vucR71w
- Zaharia et al. "The Shift from Models to Compound AI Systems." BAIR Blog (2024).https://bair.berkeley.edu/blog/2024/02/18/compound-ai-systems/
- Weng. "LLM Powered Autonomous Agents." Lil'Log (2023).https://lilianweng.github.io/posts/2023-06-23-agent/
- Kapoor et al. "AI Agents That Matter." TMLR (2025).https://arxiv.org/abs/2407.01502
2. LLM para desarrolladores
Mon Sep 28 · 2026
- Diapositivashttps://web.stanford.edu/class/cs329z/slides/lecture02.pdf
- Vídeohttps://youtu.be/Vr1NzH8bT44
- Vaswani et al. "Attention Is All You Need." NeurIPS (2017).https://arxiv.org/abs/1706.03762
- Katharopoulos et al. "Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention." ICML (2020).https://arxiv.org/abs/2006.16236
- Rajasekaran et al. "Effective Context Engineering for AI Agents." Anthropic (2025).https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
3. RAG
Wed Sep 30 · 2026
- Diapositivashttps://web.stanford.edu/class/cs329z/slides/lecture03.pdf
- Lewis et al. "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks." NeurIPS (2020).https://arxiv.org/abs/2005.11401
- Karpukhin et al. "Dense Passage Retrieval for Open-Domain Question Answering." EMNLP (2020).https://arxiv.org/abs/2004.04906
- Khattab & Zaharia. "ColBERT: Efficient and Effective Passage Search via Contextualized Late Interaction over BERT." SIGIR (2020).https://arxiv.org/abs/2004.12832
4. Uso de herramientas
Mon Oct 5 · 2026
- Diapositivashttps://web.stanford.edu/class/cs329z/slides/lecture04.pdf
- Schick et al. "Toolformer: Language Models Can Teach Themselves to Use Tools." NeurIPS (2023).https://arxiv.org/abs/2302.04761
- Patil et al. "Gorilla: Large Language Model Connected with Massive APIs." NeurIPS (2024).https://arxiv.org/abs/2305.15334
- Model Context Protocol Specification, revision 2025-06-18. modelcontextprotocol.io (2025).https://modelcontextprotocol.io/specification/2025-06-18
5. Marcos y orquestación
Wed Oct 7 · 2026
- Diapositivashttps://web.stanford.edu/class/cs329z/slides/lecture05.pdf
- Códigohttps://github.com/cs329z/lecture5-frameworks
- Khattab et al. "DSPy: Compiling Declarative Language Model Calls into Self-Improving Pipelines." ICLR (2024).https://arxiv.org/abs/2310.03714
- LangChain. "LangGraph Overview." LangChain Docs.https://docs.langchain.com/oss/python/langgraph/overview
- Arena.ai. "HarnessTax: How Much Does the Harness Matter for Coding Agents?" Arena Blog (2026).https://arena.ai/blog/coding-agents-harness-tax
6. Patrones de diseño
Mon Oct 12 · 2026
- Diapositivashttps://web.stanford.edu/class/cs329z/slides/lecture06.pdf
- Yao et al. "ReAct: Synergizing Reasoning and Acting in Language Models." ICLR (2023).https://arxiv.org/abs/2210.03629
- Schluntz & Zhang. "Building Effective AI Agents." Anthropic (2024).https://www.anthropic.com/engineering/building-effective-agents
- LangChain. "Context Engineering." LangChain Blog (2025).https://www.langchain.com/blog/context-engineering-for-agents
- Shinn et al. "Reflexion: Language Agents with Verbal Reinforcement Learning." NeurIPS (2023).https://arxiv.org/abs/2303.11366
- Wang et al. "Executable Code Actions Elicit Better LLM Agents." ICML (2024).https://arxiv.org/abs/2402.01030
7. Memoria
Wed Oct 14 · 2026
- Diapositivashttps://web.stanford.edu/class/cs329z/slides/lecture07.pdf
- Sumers et al. "Cognitive Architectures for Language Agents." TMLR (2024).https://arxiv.org/abs/2309.02427
- Packer et al. "MemGPT: Towards LLMs as Operating Systems." arXiv (2023).https://arxiv.org/abs/2310.08560
- Park et al. "Generative Agents: Interactive Simulacra of Human Behavior." UIST (2023).https://arxiv.org/abs/2304.03442
8. Sistemas multiagente
Mon Oct 19 · 2026
- Diapositivashttps://web.stanford.edu/class/cs329z/slides/lecture08.pdf
- Wu et al. "AutoGen: Enabling Next-Gen LLM Applications via Multi-Agent Conversation." COLM (2024).https://arxiv.org/abs/2308.08155
- Cemri et al. "Why Do Multi-Agent LLM Systems Fail?" NeurIPS Datasets & Benchmarks (2025).https://arxiv.org/abs/2503.13657
- Kim et al. "Towards a Science of Scaling Agent Systems." arXiv (2025).https://arxiv.org/abs/2512.08296
9. Optimización
Wed Oct 21 · 2026
- Diapositivashttps://web.stanford.edu/class/cs329z/slides/lecture09.pdf
- Agrawal et al. "GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning." ICLR (2026).https://arxiv.org/abs/2507.19457
- Opsahl-Ong et al. "Optimizing Instructions and Demonstrations for Multi-Stage Language Model Programs." EMNLP (2024).https://arxiv.org/abs/2406.11695
- Shao et al. "DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models." arXiv (2024).https://arxiv.org/abs/2402.03300
10. Terminal-Bench
Mon Oct 26 · 2026
- Diapositivashttps://web.stanford.edu/class/cs329z/slides/lecture10.pdf
- Terminal-Bench project site (leaderboard, tasks, and harness).https://www.tbench.ai/
- Merrill et al. "Terminal-Bench: Benchmarking Agents on Hard, Realistic Tasks in Command Line Interfaces." ICLR (2026).https://arxiv.org/abs/2601.11868
11. Datos para agentes
Wed Oct 28 · 2026
- Diapositivashttps://web.stanford.edu/class/cs329z/slides/lecture11.pdf
- Shankar. "Data Flywheels for LLM Applications." (2024).https://www.sh-reya.com/blog/ai-engineering-flywheel/
- Tan et al. "Large Language Models for Data Annotation and Synthesis: A Survey." EMNLP (2024).https://aclanthology.org/2024.emnlp-main.54/
12. Selección y calidad
Mon Nov 2 · 2026
- Diapositivashttps://web.stanford.edu/class/cs329z/slides/lecture12.pdf
- Yang et al. "SWE-smith: Scaling Data for Software Engineering Agents." NeurIPS D&B (2025).https://arxiv.org/abs/2504.21798
- Shankar et al. "Who Validates the Validators? Aligning LLM-Assisted Evaluation with Human Preferences." UIST (2024).https://arxiv.org/abs/2404.12272
- Zhou et al. "LIMA: Less Is More for Alignment." NeurIPS (2023).https://arxiv.org/abs/2305.11206
13. Evaluación y benchmarks
Wed Nov 4 · 2026
- Diapositivashttps://web.stanford.edu/class/cs329z/slides/lecture13.pdf
- Zhu et al. "Establishing Best Practices for Building Rigorous Agentic Benchmarks." (2025).https://arxiv.org/abs/2507.02825
- Press. "How to Build Good Language Modeling Benchmarks." (2024).https://ofir.io/How-to-Build-Good-Language-Modeling-Benchmarks/
- Polo et al. "tinyBenchmarks: Evaluating LLMs with Fewer Examples." ICML (2024).https://arxiv.org/abs/2402.14992
14. Conversación con Andrew Ng
Mon Nov 9 · 2026
15. Jueces LLM e infraestructura
Wed Nov 11 · 2026
- Grace et al. "Demystifying Evals for AI Agents." Anthropic (2026).https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents
- Zheng et al. "Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena." NeurIPS (2023).https://arxiv.org/abs/2306.05685
- Ryan et al. "AutoMetrics: Approximate Human Judgements with Automatically Generated Evaluators." ICLR (2026).https://arxiv.org/abs/2512.17267
- Zhu et al. "AutoLibra: Agent Metric Induction from Open-Ended Human Feedback." ICLR (2026).https://openreview.net/forum?id=4BjGVZ7Bxn
16. SWE-bench
Mon Nov 16 · 2026
17. Seguridad y controles
Wed Nov 18 · 2026
- Shao et al. "PrivacyLens: Evaluating Privacy Norm Awareness of LMs in Action." NeurIPS D&B (2024).https://arxiv.org/abs/2409.00138
- Zhang & Yang. "Searching for Privacy Risks in LLM Agents via Simulation." arXiv (2025).https://arxiv.org/abs/2508.10880
- Li. "Agentic LLMs as Powerful Deanonymizers." arXiv (2026).https://arxiv.org/abs/2601.05918
- Wen et al. "Contextualized Privacy Defense for LLM Agents." arXiv (2026).https://arxiv.org/abs/2603.02983
- OpenAI. "Understanding Prompt Injections: A Frontier Security Challenge." (2025).https://openai.com/index/prompt-injections/
- Anthropic. "Anthropic's Responsible Scaling Policy." (2023).https://www.anthropic.com/news/anthropics-responsible-scaling-policy
18. Sin clase
Mon Nov 23 · 2026
19. Sin clase
Wed Nov 25 · 2026
20. Agentes de programación
Mon Nov 30 · 2026
- Yang et al. "SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering." NeurIPS (2024).https://arxiv.org/abs/2405.15793
- Wang et al. "OpenHands: An Open Platform for AI Software Developers." ICLR (2025).https://arxiv.org/abs/2407.16741
- Anthropic. "Claude Code: Best Practices for Agentic Coding." (2025).https://www.anthropic.com/engineering/claude-code-best-practices
- Young. "Effective Harnesses for Long-Running Agents." Anthropic (2025).https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents
21. Agentes proactivos
Wed Dec 2 · 2026
- Shaikh et al. "Creating General User Models from Computer Use." UIST (2025).https://arxiv.org/abs/2505.10831
- Shaikh et al. "Learning Next Action Predictors from Human-Computer Interaction." arXiv (2026).https://arxiv.org/abs/2603.05923
- Steinberger. "OpenClaw: Open-source proactive AI agent." (2025).https://github.com/openclaw/openclaw
22. Demo final
Wed Dec 9 · 2026