IA que acelera la inferencia de IA: del kernel al servicio fiable
Un estudio de mecanismos, evidencia reciente, límites físicos, arquitectura productiva y práctica local reproducible.
Fuentes y versiones
En este artículo
¿Qué mejora realmente?
La optimización asistida por IA utiliza un modelo para proponer cambios al código o la configuración que ejecuta otro modelo, y evidencia externa para seleccionarlos. Los pesos pueden permanecer fijos; el optimizador puede ser otro modelo en otro equipo.
Distingue implementación de operaciones, configuración del servicio y cambios de precisión o decodificación. Usar «el mismo modelo» no garantiza equivalencia si cambian muestreo, precisión o longitud de salida.
Seguiremos un asistente SRE que convierte evidencia de incidentes en informes: del pedido a la GPU y de la propuesta a un despliegue controlado. Es un diseño de referencia propio, no la arquitectura interna de un proveedor.
Bases: tensores, memoria y latencia
Un tensor incluye forma, tipo y strides: estos últimos indican dónde están sus elementos. Un kernel para datos contiguos puede fallar con una vista transpuesta. La suma flotante no es asociativa; cambiar reducciones modifica errores numéricos.
HBM ofrece capacidad; registros y memoria compartida ofrecen proximidad. Fusionar operaciones reduce escrituras intermedias y lanzamientos, pero aumenta valores vivos y puede reducir ocupación. Los bloques reutilizan datos, sin garantizar mejoras universales.
Latencia mide una solicitud; throughput mide trabajo total por segundo. Cerca de saturación, las colas pueden dominar. Primero fija contratos de tensores y plazos del producto.
Una solicitud: prefill y decode
La API autentica, tokeniza y encola. El planificador admite según capacidad; prefill procesa el prompt y crea KV; decode calcula y muestrea sucesivos tokens y amplía el estado. Cancelar debe liberar recursos.
Prefill suele aprovechar matrices grandes. Decode con lotes pequeños suele mover muchos pesos y KV por operación. Lotes mayores reutilizan pesos, pero contexto largo, modelos dispersos e interconexión cambian el cuello de botella.
TTFT incluye red y cola hasta el primer token. El intervalo entre tokens se mide en el flujo, no en un kernel. Publica percentiles y throughput bajo llegadas definidas: más tokens/s totales pueden significar peor experiencia individual.
| Nivel | Pregunta | Riesgo |
|---|---|---|
| Kernel | ¿Mejora el operador en esta GPU? | Forma, tiempo asíncrono, base débil |
| Motor | ¿Mejora con batch/contexto real? | Caché incompatible, MoE desigual |
| Servicio | ¿Cumple TTFT y cola de latencia? | Saturación y caché no comparable |
| Tarea | ¿Resultado correcto más barato? | Menos calidad disfrazada de eficiencia |
Localiza el recurso limitante
El límite roofline compara F/P y D/B: operaciones divididas por capacidad y bytes divididos por ancho de banda alcanzable. Su máximo supone solapamiento perfecto; lanzamientos, sincronización y comunicación añaden límites. El pico anunciado no es rendimiento medido.
Ejemplo didáctico: leer y escribir una matriz FP32 de 4096×4096 mueve 134.217.728 bytes. A 1 TB/s supuesto requiere unos 0,134 ms. Una cifra de 0,01 ms exige revisar caché y cronometraje, no celebrar automáticamente.
Entrega al optimizador perfil, formas, strides y tolerancia. Elimina copias o fusiona operaciones donde importa; conserva la referencia.
Un kernel concreto: normalización RMS
Para X de forma [M,N] y escala w de [N], calcula la media de cuadrados por fila, suma epsilon positivo y multiplica X y w por su raíz inversa. RMSNorm no resta la media. Acumular en FP32 ayuda con entradas de menor precisión, dentro de un rango definido.
Fusionar evita materializar cuadrados e intermedios. Si se rellena una fila para el bloque, los elementos añadidos aportan cero, pero el divisor sigue siendo N. Dividir por el tamaño rellenado es incorrecto.
Filas anchas pueden agotar registros: varias fases cuestan lanzamientos pero pueden ganar. El ejercicio final muestra el contrato y ese error; no mide fusión GPU con Python.
El optimizador es un sistema acotado
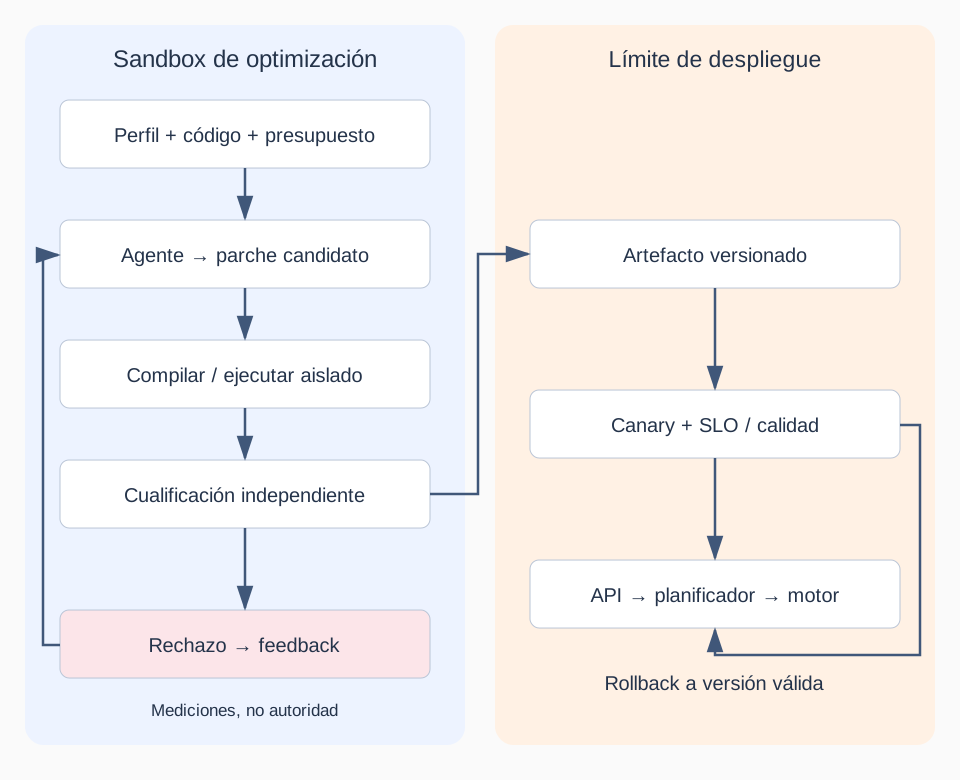
El plano de control fija commit, hardware, distribución y presupuesto. El agente propone un parche inmutable; un worker aislado compila y ejecuta. El evaluador controla casos y tiempos: el candidato no edita su juez. Un registro conserva fallos y éxitos como feedback.
Minimiza coste o latencia bajo límites numéricos, de calidad, memoria y cola. Conserva resultados por carga: una media puede esconder regresiones. Usa una frontera Pareto cuando los objetivos chocan. Agotar presupuesto significa detenerse.
Separa ejecución de promoción. Workers sin credenciales productivas, tiempo GPU limitado y suite oculta protegida. Solo un controlador promociona artefactos cualificados con rollback conocido.
Arquitectura: optimización sin saltarse promoción
Evidencia reciente: denominadores distintos
Together (4-11-2026) informa hasta 2,6× TPS en comparaciones InferenceX específicas; OpenAI (29-7-2026), 20% menos coste de servicio por mejoras combinadas; AlphaEvolve (14-5-2025), 23% en un kernel y 1% en tiempo de entrenamiento. Son cifras de autores, no reproducciones nuestras. [1] [2] [3]
Throughput, coste y entrenamiento no constituyen un ranking comparable. Exige modelo, cantidad de hardware, precisión, contexto, concurrencia y límites de latencia.
Mantener motores cargados reduce el coste de experimentar, pero también exige aislar cachés, asignador y configuración entre candidatos. Iterar rápido no debe contaminar mediciones.
Más allá del kernel
La caché de prefijos reutiliza cómputo compatible de prefijos exactos, no de texto simplemente parecido. Sus claves deben incluir revisión y política de aislamiento. No confundas caché caliente con mejoras del kernel.
La decodificación especulativa propone tokens con un borrador y los verifica con el modelo objetivo. El algoritmo correcto de aceptación/corrección puede preservar la distribución. Mejor acuerdo con un borrador mayor puede perder frente a su coste adicional.
Paralelismo tensorial, de expertos y de datos distribuyen trabajo de formas distintas. Más dispositivos añaden comunicación y desequilibrio. Busca con rutas y topología reales: óptimos locales no garantizan el global.
De microsegundos a valor
Si una fracción f del tiempo acelera s veces, Amdahl limita la mejora total. Acelerar 2× el 40% produce solo 1,25× global y 20% menos tiempo. Las colas pueden añadir efectos no lineales.
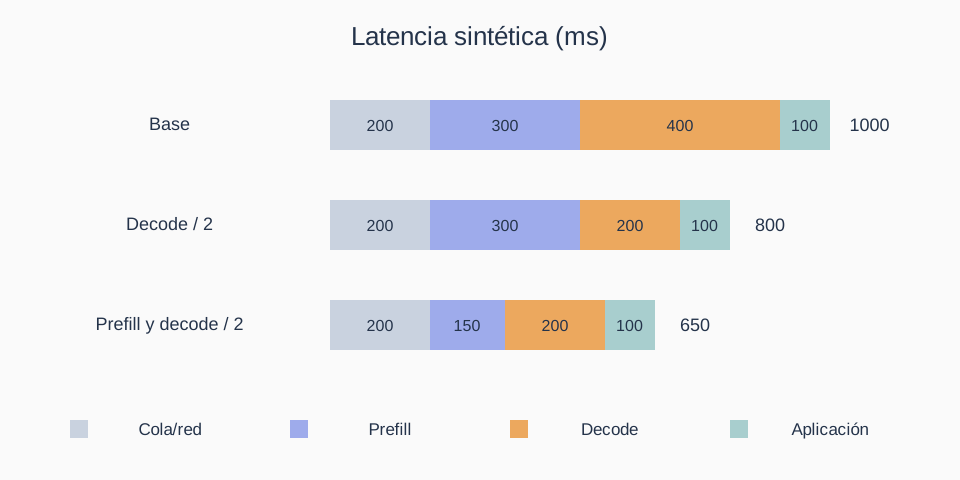
Ejemplo sintético de 1000 ms: red/cola 200, prefill 300, decode 400, aplicación 100. Reducir decode a la mitad da 800 ms; también prefill, 650 ms. Veinte llamadas estrictamente secuenciales ahorran 4 s si cada una ahorra 200 ms.
Con coste de búsqueda supuesto de $120 y ahorro de $0,0002 por solicitud equivalente, el equilibrio llega a 600.000 solicitudes, antes de mantenimiento. Incluye experimentos fallidos, GPU, tokens y revisión humana.
¿Quién controla cada capa?
Wafer comercializa endpoints optimizados por carga y su perfil YC describe agentes como ingenieros de rendimiento. Compras un servicio operativo, no solo un archivo kernel; valida las afirmaciones con tu tráfico. [4]
Together optimiza su servicio; OpenAI su propia pila; AlphaEvolve explora algoritmos. KernelBench es evaluación. Apple lista 37 tareas de soporte, optimización y reparación en motores vLLM/SGLang. [1–3] [5] [6]
Nuestra interpretación: cargas representativas, cualificación y entrega son ventajas duraderas. Pregunta por control de telemetría, aprobación, exportación y fallback. Hosting amortiza búsqueda; despliegue privado exige ingeniería. No es un ranking financiero ni de adquisiciones.
Límites productivos y problemas abiertos
El manifiesto debe fijar código, modelo, compilador, GPU, formas, tipos, tolerancias, resultados y rollback. Solo los casos soportados usan el candidato; el resto conserva fallback válido. Una guarda de forma es código ejecutable.
Observa latencia, errores, OOM, calidad y saturación. Detén promoción si empeoran; drena solicitudes antes de cambios incompatibles de caché. Kubernetes programa recursos y despliegues, no demuestra corrección. Separa cuentas de optimización y producción.
Siguen abiertos transferencia entre hardware, contaminación, deriva numérica, ruido y coste de cualificar. Consultar repetidamente validación la convierte en feedback de entrenamiento. Mantén una carga final independiente y registra sus consultas.
¿Es auto-mejora recursiva?
Existe un bucle si el sistema mejora la pila que ejecutará su siguiente optimización. Caben más experimentos en el mismo presupuesto. Pero un parche demuestra un evento, no amplificación recursiva.
Exige varias generaciones, reglas estables, costes y mejora en tareas reservadas. Compara optimizador fijo, fijo con más presupuesto y supuesto optimizador mejorado. Informa intervención humana y mesetas. Inferencia más rápida no significa mayor capacidad de razonamiento ni aprendizaje de pesos.
Práctica y verificación independiente
Experimento local: rechaza candidatos incorrectos
Ejecuta python3 lab.py con Python 3.11+ y biblioteca estándar, semilla 42. La referencia calcula RMSNorm; el candidato reutiliza la escala; un error divide por anchura rellenada y otro devuelve ceros. El primero pasa anchuras 4/8, pero falla 3/7/33. Son casos públicos didácticos, no una suite secreta. El contrato rechaza escala vacía, anchuras incompatibles y valores no finitos.
Salida esperada: candidate pasa ambos conjuntos; padded_bug solo desarrollo; zero_bug ninguno. Amdahl devuelve 1,25 y equilibrio 600000. gpu_benchmark_performed es false. No se usa tiempo Python para afirmar mejoras GPU; se registra versión sin dependencias externas.
Para extender a GPU, implementa el contrato en CUDA/Triton y registra GPU, driver, compilador, framework y hash. Incluye tamaños impares, ceros, valores grandes, layouts soportados y dtypes. Compara con framework optimizado, separa compilación, sincroniza, usa eventos y repeticiones independientes, aleatoriza orden y controla cargas rivales. Verifica forma, tipo, errores y calidad posterior.
Después reproduce tráfico reservado con modelo, precisión, longitudes, llegadas y caché fijos. Compara configuración manual, búsqueda de parámetros, kernels IA y pila completa con igual presupuesto, incluyendo fracasos. Termina con canary y rollback. Esta extensión GPU no fue ejecutada por Token Lab.
Descargar implementación Python"""Token Lab: CPU correctness gate, not a GPU performance benchmark.
Python 3.11+ standard library; no network, model API, or third-party dependency.
"""
import json
import math
import random
import sys
def reference(rows, weights, eps=1e-5):
if eps <= 0 or not weights or any(len(r) != len(weights) for r in rows):
raise ValueError('positive epsilon and rectangular nonempty rows required')
if any(not math.isfinite(x) for r in rows for x in r + weights):
raise ValueError('finite input contract')
return [[x * w / math.sqrt(eps + math.fsum(v*v for v in r)/len(r))
for x, w in zip(r, weights)] for r in rows]
def candidate(rows, weights, eps=1e-5):
output = []
for row in rows:
inv = 1 / math.sqrt(eps + math.fsum(x*x for x in row)/len(row))
output.append([x*w*inv for x, w in zip(row, weights)])
return output
def padded_bug(rows, weights, eps=1e-5):
padded = 1 << (len(weights)-1).bit_length()
return [[x*w/math.sqrt(eps + math.fsum(v*v for v in row)/padded)
for x,w in zip(row,weights)] for row in rows]
def zero_bug(rows, weights, eps=1e-5):
return [[0.0]*len(weights) for _ in rows]
def passes(fn, cases):
for rows, weights in cases:
expected, actual = reference(rows, weights), fn(rows, weights)
if len(actual) != len(expected):
return False
for a,b in zip(actual,expected):
if len(a) != len(b) or any(not math.isfinite(x) or
not math.isclose(x,y,rel_tol=1e-12,abs_tol=1e-12)
for x,y in zip(a,b)):
return False
return True
def main():
rng = random.Random(42)
dev = [([[rng.uniform(-3,3) for _ in range(n)] for _ in range(3)],
[rng.uniform(.5,1.5) for _ in range(n)]) for n in (4,8)]
# Independent shape coverage, public for teaching: NOT a secret benchmark.
audit = [([[rng.uniform(-3,3) for _ in range(n)] for _ in range(3)],
[1.0]*n) for n in (1,3,7,33)]
audit += [([[0.0,0.0,0.0]], [1.0]*3), ([[1000.,-1000.,1.]], [1.0]*3)]
results = {fn.__name__: {'development':passes(fn,dev), 'audit':passes(fn,audit)}
for fn in (candidate,padded_bug,zero_bug)}
assert results['candidate'] == {'development':True,'audit':True}
assert results['padded_bug'] == {'development':True,'audit':False}
assert results['zero_bug'] == {'development':False,'audit':False}
for bad in [([], []), ([[1.,2.]], [1.]), ([[float('nan')]], [1.])]:
try:
reference(*bad)
except ValueError:
pass
else:
raise AssertionError('invalid input accepted')
speedup = 1 / (.6 + .4/2)
assert speedup == 1.25
print(json.dumps({'python':sys.version.split()[0], 'seed':42,
'correctness':results, 'synthetic_end_to_end_speedup':speedup,
'synthetic_break_even_requests':120/.0002,
'gpu_benchmark_performed':False},indent=2))
if __name__ == '__main__':
main()
{
  "python": "3.12.14",
  "seed": 42,
  "correctness": {
    "candidate": {
      "development": true,
      "audit": true
    },
    "padded_bug": {
      "development": true,
      "audit": false
    },
    "zero_bug": {
      "development": false,
      "audit": false
    }
  },
  "synthetic_end_to_end_speedup": 1.25,
  "synthetic_break_even_requests": 600000.0,
  "gpu_benchmark_performed": false
}
Preguntas originales y respuestas graduadas
1. ¿Por qué 2× local produce 1,25× global?
Pista: fracción acelerada. Con
2. ¿Por qué pasa el error de padding?
Pista: anchuras. 4/8 no cambian; usar 4 para
3. ¿Puede editar su cronómetro?
Pista: separa propuesta y autoridad. Puede instrumentar diagnóstico, no controlar el evaluador final. Comprueba trabajo GPU completo e inputs frescos.
4. ¿Qué demostraría mejora recursiva?
Pista: un parche no basta. Exige generaciones y ganancias reservadas con presupuesto total controlado, incluyendo humanos y cualificación, frente a optimizador fijo con igual cómputo.
Ejercicios propios, no entrevistas reales. 1 términos; 2 ruta normal; 3 cálculo y detección del error; 4 comparación justa y límites productivos; 5 reproducción independiente, diagnóstico nuevo e incertidumbre.
Rutas relacionadas
Fundamentos explicados
Repasa el razonamiento que sostiene el método y utiliza las comprobaciones para detectar lagunas.
La decodificación autorregresiva genera un token condicionado al prefijo. En un Transformer causal, con prefijo y modelo fijos se reutilizan claves y valores anteriores. La caché KV guarda tensores internos, no una respuesta. Cuenta capas, lote, posiciones, cabezas KV, dimensión y bytes por número.
Razona antes de abrir la solución
Con 2 capas, lote 1, 4 tokens, 2 cabezas KV, dimensión 3 y 2 bytes por número, ¿cuántos bytes ocupan K y V?
Solución paso a paso
2×2×1×4×2×3×2=192 bytes. El primer 2 cuenta K y V. Excluye pesos, temporales, asignación y relleno. Duplicar contexto duplica esta carga, no necesariamente toda la memoria GPU.
Conexión con la práctica
GQA reduce cabezas KV respecto a las consultas. Es una elección arquitectónica, no una licencia para borrar tensores arbitrarios. Reutilizar un prefijo requiere iguales tokens, posiciones, modelo y ajustes relevantes.
Cómo demostrar comprensión
Compara resultados con y sin caché dentro de tolerancia e invalida al cambiar el prefijo. Separa bytes útiles de memoria asignada y prefill de decode. Una calculadora de bytes no mide rendimiento de hardware.
Ejemplo Python completo
Python 3.10+ · solo biblioteca estándar · determinista, sin semilla aleatoria · sin red. Guarda el archivo y ejecuta el comando. Son comprobaciones didácticas, no benchmarks.
Descargar Python · kv.pypython3 kv.py# Python 3.10+; standard library; deterministic; no network.
def kv_bytes(layers, batch, tokens, kv_heads, head_dim, bytes_per_value):
dimensions = [layers, batch, tokens, kv_heads, head_dim, bytes_per_value]
if any(not isinstance(x, int) or x < 0 for x in dimensions):
raise ValueError("nonnegative integer dimensions required")
size = 2 # K and V
for dimension in dimensions:
size *= dimension
return size
assert kv_bytes(2, 1, 4, 2, 3, 2) == 192
assert kv_bytes(2, 1, 8, 2, 3, 2) == 384
assert kv_bytes(2, 1, 0, 2, 3, 2) == 0
print("KV payload=192 bytes; doubled context=384 bytes")
Salida esperada
KV payload=192 bytes; doubled context=384 bytes
Fundamento revisado:
Referencias, artículos y recursos
- Together Compiler — technical report, 2026-11-04 (not claimed as conference acceptance)https://www.together.ai/together-compiler-paper
- OpenAI — engineering report, 2026-07-29https://openai.com/index/gpt-5-6-frontier-intelligence-efficiency/
- Google DeepMind — AlphaEvolve announcement, 2025-05-14https://deepmind.google/blog/alphaevolve-a-gemini-powered-coding-agent-for-designing-advanced-algorithms/
- Wafer — company profile / product positioninghttps://www.ycombinator.com/companies/wafer
- KernelBench — ICML 2025 proceedingshttps://proceedings.mlr.press/v267/ouyang25a.html
- Apple — RSI-Inference Bench official repository (checked 2026-11-11; no conference status asserted)https://github.com/apple-aiml-research/ml-rsi-inference-bench
- KernelBench — arXiv v1, 2025-02-14https://arxiv.org/abs/2502.10517v1
- KernelBench — arXiv PDF v1https://arxiv.org/pdf/2502.10517v1
- KernelBench — author codehttps://github.com/ScalingIntelligence/KernelBench
- AlphaEvolve — original technical PDFhttps://storage.googleapis.com/deepmind-media/DeepMind.com/Blog/alphaevolve-a-gemini-powered-coding-agent-for-designing-advanced-algorithms/AlphaEvolve.pdf
- Triton — official kernel tutorialshttps://triton-lang.org/main/getting-started/tutorials/
- Wafer — current product descriptionhttps://www.wafer.ai/