AI infrastructure in 2026: from fast chips to useful, reliable capacity
Follow a request through admission, prefill, KV memory, decoding, tools and recovery; connect capacity and cost to frontier hardware and market evidence.
Fuentes y versiones
Contents · lifecycle and reference chapters
En este artículo
Infraestructura: seguir una solicitud
Este caso original sigue a un asistente de facturas. Lee documentos del inquilino y propone un pago; ejecutarlo requiere autorización separada y exacta. El escenario y los experimentos son didácticos y sintéticos, no un despliegue real.
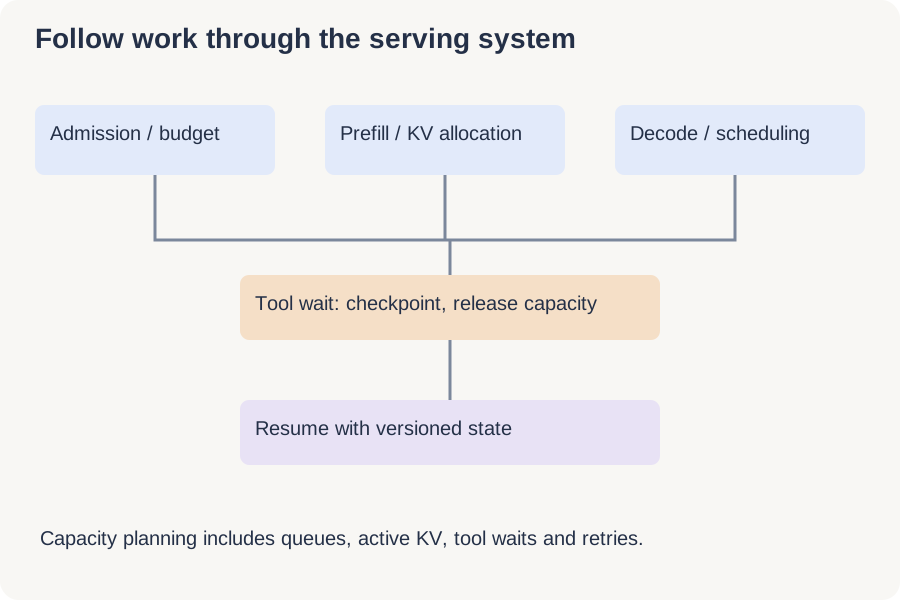
Seguir una solicitud: infraestructura de un agente de facturas
Un empleado pide explicar el retraso de INV-42 y preparar el siguiente pago si procede. El asistente consulta documentos de su inquilino y el estado, explica y propone; ejecutar exige una aprobación exacta separada. Es un sistema docente sintético, no una arquitectura de proveedor. La infraestructura sostiene un flujo durable, no solo texto fluido.
La solicitud cruza gateway autenticado, workflow, recuperación, inferencia, gateway de herramientas y sistema de negocio. Sus fallos difieren: repetir lecturas suele ser posible, repetir un pago con timeout exige conciliar su resultado. El proceso del modelo no es dueño de la verdad transaccional. El estado durable conserva pasos pendientes, evidencia y confirmaciones.
Antes del hardware, define llegadas, ráfagas, distribución de tokens, llamadas por tarea, fan-out, latencia de herramientas y plazos. Separa interacción y conciliación en segundo plano. Diez solicitudes/s no bastan: 200 tokens y ocho llamadas largas son cargas distintas. Determina qué estado se recupera sin repetir inferencia no determinista; una conversación no es por sí sola un checkpoint.
Etapa 1: admisión, contexto y presupuestos
El gateway autentica y resuelve el inquilino antes de encolar. El rate limit protege el servicio compartido; admisión decide si aún puede cumplir el plazo. Rechazar o aplazar pronto suele ser mejor que una cola ilimitada con respuestas inútilmente tardías.
Reserva contexto para instrucciones, esquemas de herramientas, evidencia, historial y salida máxima. La ventana es un límite, no un objetivo de llenado. Selecciona material pertinente y autorizado; el truncado no debe eliminar políticas o procedencia ni omitir aprobación para incluir más documentos.
Estima tokens al admitir y concilia con consumo real. Limita concurrencia y ocupación por inquilino además de solicitudes. Pocos prompts enormes pueden agotar memoria. Propaga cancelación a búsqueda e inferencia. Un ejemplo sintético admite 24 generaciones y 48 solicitudes en cola con plazo de dos segundos: ilustra límites, no recomienda valores. La equidad requiere progreso del segundo inquilino, no solo baja latencia media.
Etapa 2: prefill, decoding, memoria KV y planificación
Tras recuperar evidencia, inferencia procesa el prompt y genera tokens. Prefill y decoding tienen patrones distintos: un prompt largo retrasa el primer token; una respuesta larga ocupa capacidad después. Distingue latencia inicial, entre tokens, hasta el último y hasta terminar la tarea.
La memoria KV convencional se estima como 2 × capas × cabezas KV × dimensión × tokens × bytes por elemento, sumada sobre secuencias residentes. Con 32 capas, 8 cabezas KV, dimensión 128, 8192 tokens y 2 bytes, una secuencia requiere 1 GiB; dieciséis requieren 16 GiB. Pesos, activaciones, fragmentación y estado adicional no están incluidos. En atención de consultas agrupadas no sustituyas cabezas KV por cabezas de consulta.
El batching comparte ejecución pero esperar un lote aumenta latencia. Las solicitudes terminan en momentos distintos y cambian memoria y secuencias activas. Dividir un prefill largo puede proteger decoding, según kernels, hardware y tráfico. Un lote uniforme no representa toda mezcla real.
La caché de prefijos de vLLMhttps://docs.vllm.ai/en/stable/features/automatic_prefix_caching/ reutiliza cálculo de prefijos comunes. Reduce prefill repetido, no la generación de nuevos tokens. Distingue tráfico frío y caliente y sus condiciones de aislamiento.
Distingue cuellos de botella antes de comprar capacidad. Prefill procesa atención y capas sobre el prompt; decoding vuelve a leer pesos y caché para producir pocos tokens por secuencia. El límite depende de lote, contexto, kernels y hardware. El paralelismo tensorial añade comunicación crítica; el de pipeline necesita trabajo suficiente para ocultar huecos. Las réplicas aumentan capacidad si el modelo cabe y el tráfico se distribuye.
Separar prefill y decode introduce transferencia de KV. Para 1 GiB de caché y un enlace ideal de 25 GiB/s, solo los bytes requieren al menos 40 ms; protocolo, contención y coordinación añaden tiempo. Es un límite aritmético, no una medición. Separar pierde valor si transferencia y capacidad ociosa cuestan más que la interferencia evitada. La cuantización requiere kernels compatibles; menos bits no prueban mayor velocidad ni calidad idéntica.
Etapa 3: routing y fallback cambian el sistema
Una consulta sencilla puede ir al modelo barato y una disputa al más capaz. El router puede clasificar mal o enviar todo a la ruta cara. Conserva decisión, versiones del modelo y prompt y presupuesto para atribuir regresiones.
El fallback puede diferir en sintaxis de herramientas, contexto, seguimiento de instrucciones y negativas. Un adaptador normaliza protocolo, no equivalencia funcional. Exige evidencia de comportamiento antes de activarlo; mantiene los mismos controles de autoridad y aprobación.
El circuit breaker reduce llamadas al proveedor fallido; backoff y presupuestos limitan amplificación, pero no prueban si hubo efecto. Separa reintentos de inferencia y negocio: una propuesta nueva no autoriza otro pago. El checkpoint conserva operación lógica y estado, no solo texto. Un fallback defendible compara semántica, costes y fallos de ruta principal, alternativa y abstención segura, no solo disponibilidad.
Etapa 4: capacidad, colas, coste y trabajo útil
La planificación empieza con la curva de servicio: cómo cambian rendimiento aceptado y latencia al crecer la carga. Cerca de saturación, las colas crecen aunque la utilización media parezca normal. Más tokens pueden coexistir con menos solicitudes terminadas a tiempo; define calidad y plazo para contar trabajo útil.
En un sistema estable, la ley de Little relaciona trabajo medio en curso con tasa de llegada y tiempo medio. Ocho solicitudes/s y tres segundos implican 24 en curso. Es una relación contable bajo estabilidad, no garantía de que 24 plazas cumplan p99. Importan ráfagas, varianza y fallos correlacionados.
En un ejemplo sintético, 1000 solicitudes cuestan 20 USD y 800 son aceptadas: 0,02 USD por solicitud y 0,025 por tarea aceptada. Si una ruta barata cuesta 16 USD pero solo acepta 500, el segundo coste sube a 0,032. Para coste total incluye reservas, ociosidad, almacenamiento, red y revisión humana por separado.
Una tarea no equivale a una llamada. Diez tareas/s con tres llamadas por tarea producen 30 llamadas/s antes de reintentar. Si un 10% necesita independientemente un intento adicional, la estimación es 33 llamadas/s. Es un modelo sintético de un solo reintento; fallos correlacionados y bucles lo invalidan. Limita intentos por tarea y globalmente.
El escalado depende del arranque y estado. Si cargar pesos tarda minutos, un pico de segundos necesita holgura existente, cola o rechazo, no una réplica lista después. Usa edad de cola, tokens activos y capacidad medida cuando corresponda. Más capacidad importa si aumenta las tareas aceptadas a tiempo sin degradar calidad ni equidad entre inquilinos.
Etapa 5: despliegue, recuperación y operación defendible
Una release incluye pesos, tokenizer, prompt, esquemas, índice, cuantización, motor y routing. Versiona artefactos y compatibilidad. Reproducir un incidente puede exigir documentos y respuestas históricas, no solo el modelo.
Tras validación offline, usa sombra sin efectos y después canary limitado real. Compara con baseline contemporáneo porque cambia el tráfico. Rollback restaura compatibilidad del workflow y esquemas, no revierte pagos confirmados. No experimentes con efectos irreversibles sin aprobación y compensación explícitas.
Define recuperación y pérdida tolerable de datos por separado para workflow y caché. KV puede recalcularse con coste; perder evidencia de aprobación o efectos confirmados es distinto. Conserva cancelación, revocación e idempotencia al recuperar. Entrega modelo de carga, capacidad medida, plan de recuperación por dependencias y reporte de efectos en tareas. Hardware y plataformas valen si eliminan el cuello medido y reducen riesgo y coste total.
How the four disciplines fit together
Security determines which actions are permitted. Infrastructure executes work within capacity and failure constraints. Observability preserves evidence of what happened. Evaluation tests whether a change improves the outcome under a declared contract. None substitutes for the others.
Mecanismos, investigación y mercado — referencias en inglés
The following chapters provide the mathematical examples, experiments, research papers and dated company evidence behind the operational story. Return to the lifecycle when deciding where each mechanism belongs.
1. The unit of progress is a completed workload
An AI infrastructure stack turns electricity, silicon, software and operational labor into training runs or useful responses. A faster accelerator is only one input. A customer experiences the time to a correct answer; an operator pays for reserved capacity, idle time, retries and failures as well as successful computation. The important question is therefore not “which chip has the largest number?” but “what bottleneck prevents this workload from meeting its service objective?”
Definitions. An accelerator is a processor optimized for selected computations. HBM is high-bandwidth memory close to the accelerator; it is not interchangeable with host RAM or remote storage. Scale-up interconnects connect processors within a tightly coupled system; scale-out networking joins systems. A service-level objective (SLO) specifies a measurable target such as a latency percentile. Goodput is the rate of useful completions satisfying specified constraints, rather than every generated token or attempted request.
Before this lesson: understand that matrix multiplication creates reusable parallel work, while autoregressive generation has a dependency between output steps. Understand a byte, a second and a watt: power measures a rate of energy use, and capacity in GiB says nothing by itself about transfer rate. Finally, distinguish average latency from a tail percentile. An average can improve while the slowest users experience worse service. Review attention and KV-cache correctness if those distinctions are unfamiliar.
Learning goals: draw the system boundary; calculate a cache budget with units; identify a misleading benchmark comparison; explain why an acquisition adds an engineering capability; and design a repeatable serving experiment. The company map below is selective, not a complete procurement recommendation or a claim that every listed product is available in every region.
2. Read the stack from the workload down
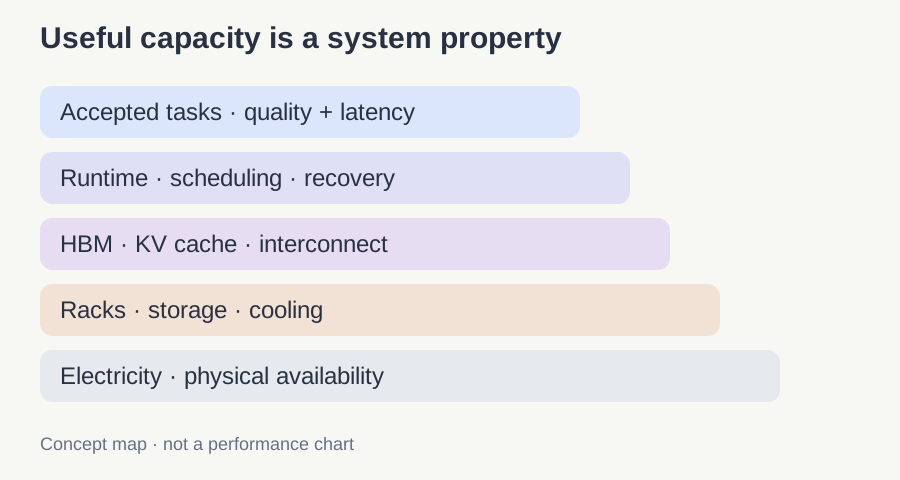
Start at the application. A short autocomplete request, a long-document question and an agent executing twenty tool steps have different prompt lengths, output lengths and interruption patterns. A speech assistant needs predictable delay; an overnight research job may accept queuing. One aggregate “tokens per second” metric conceals these differences. Record the request distribution before choosing a runtime or hardware platform.
The serving runtime schedules requests and manages state. Continuous batching can admit new work as other requests finish, but mixing a large prompt with latency-sensitive decoding can create interference. Cache allocation determines how many active sequences fit. Parallelism then distributes weights and work across processors. If a model requires frequent collectives or expert routing, communication may erase the benefit of additional compute.
The rack supplies the physical constraints: memory channels, interconnect topology, cooling and electrical delivery. A training job also needs dataset throughput and durable checkpoints. A data pipeline can starve expensive processors; a recovery procedure can waste a large fraction of a run even when individual kernels are fast. Capacity planning must include failed jobs and reloading weights, not just the steady state.
Our engineering interpretation is that differentiation increasingly comes from coordinating these layers. An efficient kernel does not repair a slow scheduler; a faster network does not fix an inaccurate low-precision model; an available GPU does not imply an energized rack. This is why infrastructure is both a distributed-systems problem and an industrial deployment problem.
Panorama: puntos de control, compradores y competencia
Evidencia revisada el 8 de noviembre de 2026. La documentación acredita una oferta, no eficacia medida independientemente. Las tesis competitivas y oportunidades son análisis de Token Lab; los ejemplos sintéticos no son resultados empresariales.
Infraestructura de IA: ¿quién controla capacidad, flujos y responsabilidad?
Revisión comprobada el 8 de noviembre de 2026. Las fuentes oficiales establecen alcance y hitos; las conclusiones competitivas son interpretación propia. No es un ranking de cuotas ni un benchmark independiente. Las páginas sin fecha se comprobaron ese día; otras fechas indican publicación o actualización.
El mercado es una cadena de responsabilidades
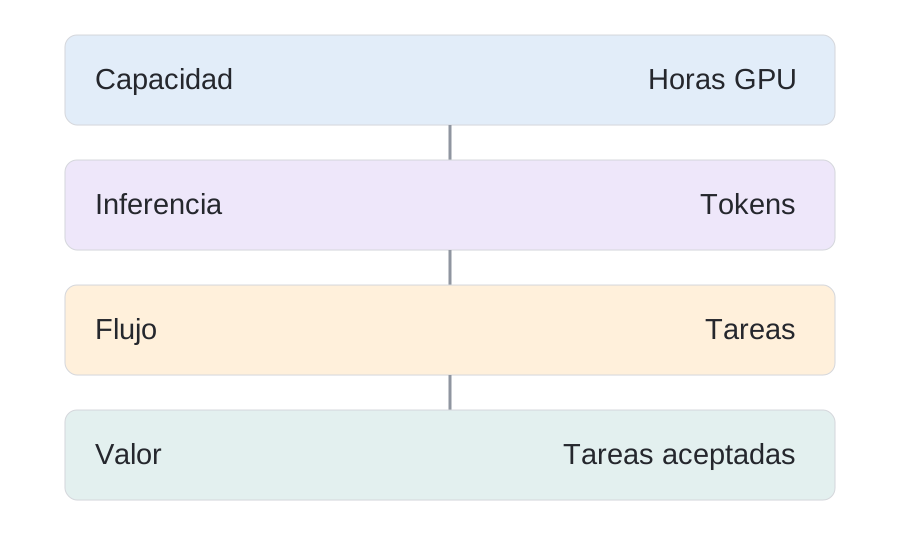
Sigue un asistente empresarial desde documentos almacenados hasta una tarea terminada. La plataforma de datos entrega evidencia autorizada; la nube GPU aporta capacidad; el operador de inferencia produce respuestas; la aplicación decide qué acción permite. Cada capa alivia un cuello de botella distinto. Tratar a todos como nubes intercambiables oculta comprador, márgenes y responsabilidad. Los juicios competitivos son interpretaciones, no cuotas medidas ni recomendaciones de inversión. Un endpoint privado puede proteger el transporte mientras una aplicación con exceso de permisos filtra registros de otro cliente.
Arquitectura: inferencia con límites de latencia y memoria
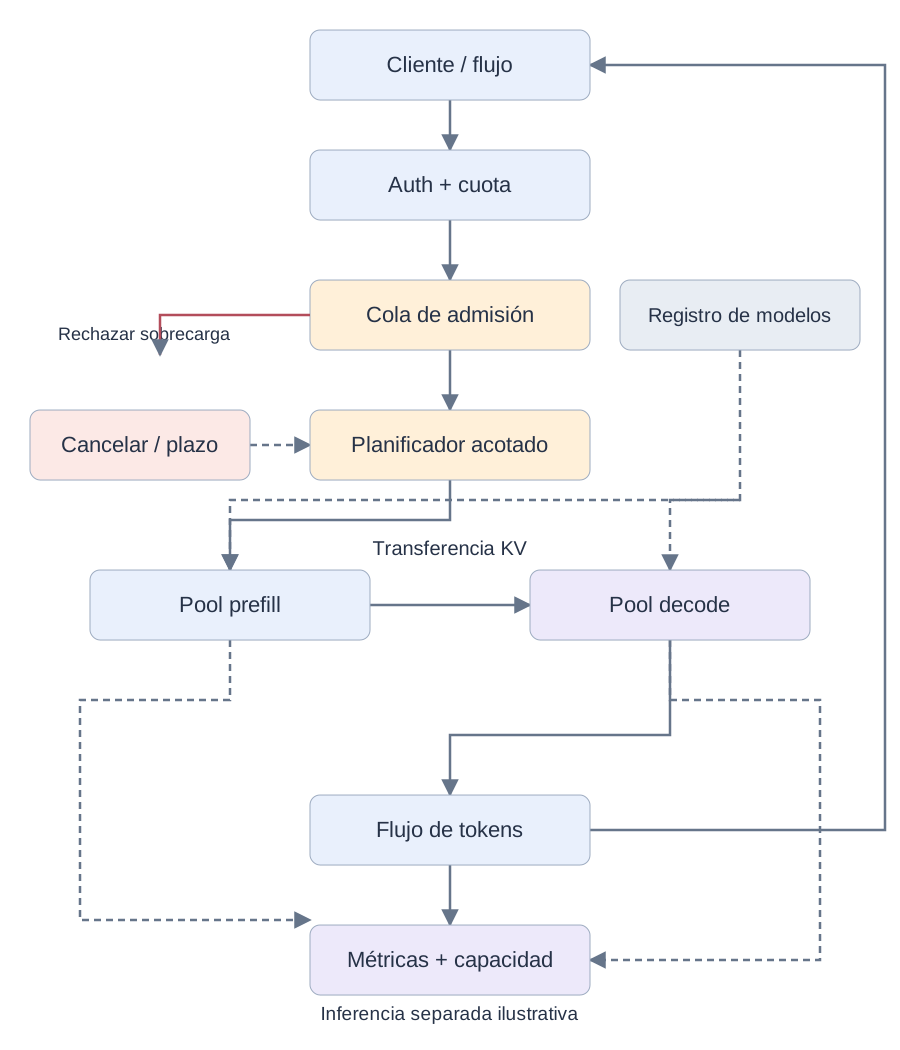
El diagrama elige prefill/decode separados para mostrar costes, no para imponerlos. La admisión reserva presupuestos de tokens y concurrencia antes de encolar. El planificador envía el prompt a prefill y transfiere KV a un trabajador decode compatible. El registro aporta artefactos fijados. Ambos pools emiten métricas; cancelación y plazos deben llegar a los trabajadores para liberar reservas.
La especialización debe compensar serialización, red y coordinación. La ejecución conjunta evita la transferencia y puede servir mejor a cargas pequeñas. Compartir prefijos exige compatibilidad de modelo, formato y aislamiento. Limite cola y espera: escalar no elimina instantáneamente la saturación. Separe tiempo en cola, primer token, cadencia y pico KV para no confundir capacidad barata con solicitudes mejor completadas.
Posiciones de empresas y productos
Mapa selectivo, no cuota de mercado ni certificación. La cobertura depende de edición, integración, despliegue y modo de aplicación.
NVIDIA
- Propiedad / organización
- NVIDIA
- Punto de control
- Aceleradores, interconexión y orquestación
NVIDIA vende hardware y software complementarios para convertir GPU en un servicio útil. Dynamo aborda la inferencia distribuida y Run:ai la asignación de cargas. El 13 de octubre de 2026 abrió el código de la plataforma Run:ai completa, con cuatro componentes modulares. Interpretación analítica: las funciones genéricas de planificación sufren presión de precios, mientras integración y soporte conservan valor. Las cuotas y el uso compartido de GPU no establecen autorización de aplicaciones ni prueban aislamiento fuerte entre clientes.
NVIDIA: full Run:ai platform open-source release ↗https://developer.nvidia.com/blog/nvidia-runai-is-now-open-source-as-part-of-nvidia-dsx-ai-factory-platform · NVIDIA Dynamo ↗https://www.nvidia.com/en-us/ai/dynamo/
AWS
- Propiedad / organización
- Amazon
- Punto de control
- Nube y API de modelos gestionadas
AWS atiende a empresas que ya utilizan sus sistemas de identidad, facturación y operaciones. Bedrock combina acceso gestionado a modelos con IAM; su ventaja incluye contratación e integración, no solo velocidad. La seguridad sigue un modelo de responsabilidad compartida. El cliente debe delimitar credenciales, datos y herramientas posteriores. Poder invocar un modelo no autoriza todas las acciones que este proponga. Evalúa controles de la implementación concreta, en lugar de convertir la marca de nube en una política de seguridad completa.
Amazon Bedrock: data protection and shared responsibility ↗https://docs.aws.amazon.com/bedrock/latest/userguide/data-protection.html · Amazon Bedrock: invocation permissions ↗https://docs.aws.amazon.com/bedrock/latest/userguide/inference.html
Microsoft Foundry
- Propiedad / organización
- Microsoft
- Punto de control
- Plano de control de IA empresarial
Microsoft reúne modelos, desarrollo de agentes y recursos Azure conectados bajo una administración empresarial. El comprador suele tener Entra y compromisos de consumo Azure, por lo que contratación y gobierno pesan mucho. Foundry ofrece roles de recurso/proyecto, identidades gestionadas y redes privadas. Reducen exposición, pero no aíslan automáticamente todas las dependencias: el gateway de IA y los servicios de datos requieren configuración propia. El equipo de aplicación debe autorizar cada acción sensible y conciliar su resultado real.
Microsoft Foundry architecture ↗https://learn.microsoft.com/en-us/azure/foundry/concepts/architecture · Microsoft Foundry network isolation ↗https://learn.microsoft.com/en-us/azure/foundry/how-to/configure-private-link
Google Cloud
- Propiedad / organización
- Alphabet
- Punto de control
- IA, datos y gobierno de nube
Google Cloud compite en la unión de datos empresariales y flujos de IA gestionados. Combina identidad, perímetros de servicio y controles de cifrado/claves, con cobertura distinta por servicio. Las condiciones de residencia distinguen ciertas funciones de grounding y RAG. Interpretación analítica: integrar datos existentes puede ser más defendible que ofrecer un catálogo. El riesgo para el comprador es suponer que aprobar un servicio aprueba todas sus funciones conectadas. Revisa cada ruta de procesamiento y función, sin extrapolar una conclusión a toda la plataforma.
Google Cloud service-specific data residency ↗https://cloud.google.com/terms/data-residency · Google Cloud: securely deploying AI ↗https://cloud.google.com/blog/products/identity-security/mastering-secure-ai-on-google-cloud-a-practical-guide-for-enterprises/
CoreWeave
- Propiedad / organización
- CoreWeave
- Punto de control
- Nube GPU y flujo de desarrollo
CoreWeave aporta capacidad GPU especializada y amplía software mediante Weights & Biases y OpenPipe. El cliente compra entrega fiable y una ruta más corta entre desarrollo, entrenamiento y servicio. Interpretación analítica: controlar experimentación y postentrenamiento puede mejorar retención y demanda de cómputo, sin eliminar intensidad de capital ni concentración. Los controles de plataforma protegen infraestructura; los permisos de aplicación siguen separados. Completar una adquisición acredita propiedad, no integración exitosa, mayor calidad del modelo o seguridad de la aplicación.
CoreWeave completes Weights & Biases acquisition ↗https://www.coreweave.com/blog/coreweave-completes-acquisition-of-weights-biases · CoreWeave 2025 Form 10-K ↗https://www.sec.gov/Archives/edgar/data/1769628/000176962826000104/crwv-20251231.htm
Nebius
- Propiedad / organización
- Nebius Group
- Punto de control
- Capacidad GPU y nube de producción
Nebius combina grandes suministros dedicados, servicios de nube gestionados y gobierno de producción. Su contrato con Microsoft muestra que un hyperscaler puede ser competidor y cliente. El anuncio de 2025 describió unos 17.400 millones de dólares hasta 2031, condicionados a despliegue y disponibilidad, con posible ampliación. No son ingresos anuales ni efectivo cobrado. IAM y gobierno de infraestructura facilitan adopción empresarial; las políticas de datos del cliente y los permisos de acción del agente no quedan resueltos por un contrato de capacidad.
Nebius Cloud 3.6 governance release ↗https://nebius.com/newsroom/nebius-ai-cloud-3-6-strengthens-developer-experience-and-governance-for-production-operations · Nebius–Microsoft agreement ↗https://www.sec.gov/Archives/edgar/data/1513845/000110465925088312/tm2525580d1_6k.htm
Together AI
- Propiedad / organización
- Together AI
- Punto de control
- Inferencia y despliegue de modelos abiertos
Together se dirige a equipos que quieren modelos abiertos sin construir toda la operación de servicio. Los endpoints dedicados reservan GPU aisladas y añaden funciones de despliegue y rendimiento. La diferencia comercial es la utilización: horas GPU reservadas pueden convenir a demanda estable; facturar tokens evita reservas ociosas con tráfico irregular. Las regiones dependen del plan y configuración. El aislamiento no elimina dudas sobre acceso del proveedor, ni la compatibilidad API garantiza semántica operativa portable. Valida modelo y distribución reales.
Together dedicated model inference ↗https://www.together.ai/dedicated-model-inference · Together EU deployment requirements ↗https://support.together.ai/articles/8079447813-eu-data-centers-and-dedicated-model-deployment
Fireworks AI
- Propiedad / organización
- Fireworks AI
- Punto de control
- Motor de inferencia y operaciones gestionadas
Fireworks puede operar su stack en GPU del cliente mediante Sovereign, separando propiedad de infraestructura de software y operaciones. El cliente gestiona el borde de red; Fireworks documenta una credencial de instalación auditable e identidades de componentes limitadas. BYOC no significa ausencia de acceso del proveedor. El desbordamiento opcional a la nube cambia el perímetro de datos. Las mejoras anunciadas de rendimiento y utilización son afirmaciones comerciales, no una comparación justa entre proveedores. La defensa competitiva exige eficiencia repetible y buena operación.
Fireworks Sovereign shared responsibility ↗https://fireworks.ai/product/sovereign · Fireworks enterprise controls and retention exceptions ↗https://fireworks.ai/solutions/for-enterprise
Baseten
- Propiedad / organización
- Baseten
- Punto de control
- Servicio y despliegue de modelos personalizados
Baseten atiende a equipos de producto que necesitan despliegue gestionado de modelos entre capacidades de nube. Sus prácticas del 5 de noviembre de 2026 distinguen infraestructura compartida con separación lógica, clústeres dedicados, autohospedaje y operación híbrida: fronteras de confianza diferentes. Interpretación analítica: integración personalizada y operaciones fiables pueden diferenciarlo más allá del catálogo. El comprador debe revisar ubicación de cargas, acceso del proveedor y alcance de cumplimiento por producto; una certificación de una oferta no se extiende automáticamente a otra.
Baseten security practices ↗https://www.baseten.co/security-practices
Databricks
- Propiedad / organización
- Databricks
- Punto de control
- Plataforma de datos, modelos y aplicaciones
Databricks compite alrededor de datos empresariales y flujos que los convierten en modelos y aplicaciones. MosaicML añadió entrenamiento, Tabular interoperabilidad de formatos y Neon sustenta el Postgres operativo Lakebase. Interpretación analítica: integración y estado acumulado generan costes de cambio más allá de los pesos. El gobierno reduce fragmentación, pero no sustituye autorización en ejecución. Un permiso de catálogo no autoriza un pago externo concreto, y guardar una traza no demuestra su liquidación.
Databricks–MosaicML acquisition agreement ↗https://www.databricks.com/company/newsroom/press-releases/databricks-signs-definitive-agreement-acquire-mosaicml-leading-generative-ai-platform · Databricks–Tabular completed acquisition update ↗https://www.databricks.com/blog/databricks-tabular · Databricks Lakebase launch powered by Neon ↗https://www.databricks.com/company/newsroom/press-releases/databricks-launches-lakebase-new-class-operational-database-ai-apps
Un despliegue puede combinar competidores
Estas capas suelen complementarse, no sustituirse. Una empresa puede alquilar GPU a una nube especializada, ejecutar el stack de inferencia de otro proveedor y mantener el gobierno de datos en una plataforma empresarial. Hay varias facturas, pero el usuario percibe un servicio. Asigna un responsable a cada fallo: capacidad ausente, despliegue bloqueado, evidencia inaccesible, generación lenta y acción no autorizada son incidentes distintos. Integrar reduce coordinación, pero un contrato único no iguala la fiabilidad de los componentes. Para startups, la oportunidad atractiva es una frontera que falla repetidamente entre proveedores y resulta costosa de operar internamente, no otro panel de utilización GPU.
Detalle técnico: prefill, decode y memoria KV
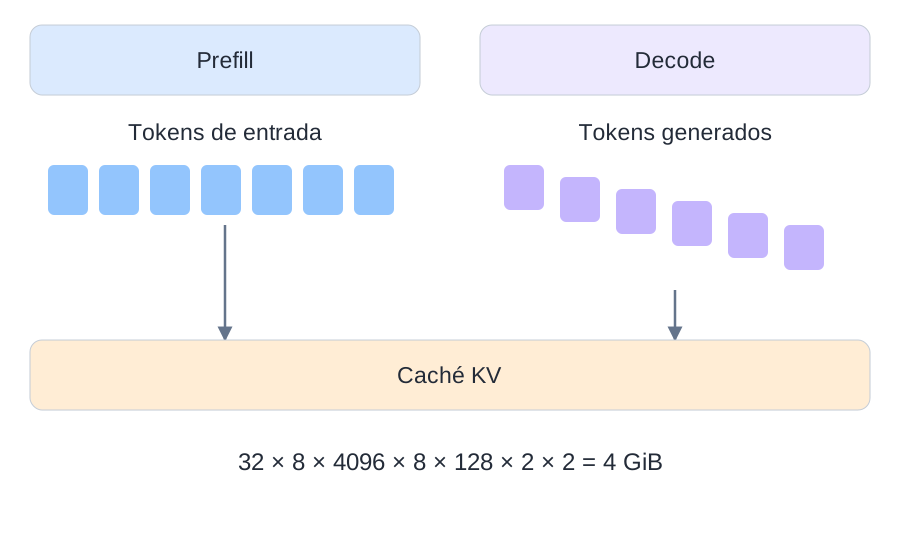
Prefill procesa la entrada y construye estados key/value; decode lee estados previos mientras genera tokens. Los cuellos de botella dependen de carga y hardware. El batching continuo puede mejorar utilización, pero demasiada concurrencia añade colas y presión de memoria. Separar ambas fases permite distinta planificación a cambio de transferencias KV y red. La velocidad debe cumplir latencia al primer token y entre tokens con la concurrencia requerida.
Los bytes del caché convencional son aproximadamente 2 × capas × secuencias activas × tokens almacenados por secuencia × cabezas KV × dimensión de cabeza × bytes por elemento. Con 32, 8, 4096, 8, 128 y 2, respectivamente, resultan 4 GiB. El ejemplo sintético excluye pesos, activaciones, fragmentación y metadatos. La atención con consultas agrupadas reduce cabezas KV; compartir prefijos exige reutilización válida y aislamiento. Planifique la ocupación máxima, no solo la solicitud media.
Capacidad, tokens y economía de tareas aceptadas
El negocio de capacidad asume riesgos de equipos, energía, entrega y utilización. El software de inferencia compite en rendimiento útil bajo límites de latencia y calidad; las plataformas de datos, en integración y retención. Ejemplo sintético: A cobra 20 dólares por 1.000 solicitudes con 800 resultados aceptables, 0,025 por tarea. B cobra 16, pero solo obtiene 500 resultados aceptables, 0,032 por tarea. B es más barato por solicitud y más caro por tarea aceptada. Incluye reservas ociosas, reintentos, movimiento de datos y revisión humana; mantén constantes tareas, umbral de calidad y plazo.
Otro ejemplo sintético separa riesgo de capacidad y margen de software. Un trabajador reservado cuesta 240 dólares por día de 24 horas. Con utilización productiva del 80%, sus 19,2 horas útiles cuestan 12,50 dólares cada una; al 25%, seis horas cuestan 40 dólares cada una. El precio reservado no cambia. No es una cotización de GPU, y tiempo ocupado no implica resultados útiles. Por eso importan los compromisos de utilización, la diversidad de cargas y quién paga la capacidad ociosa al comparar al propietario de infraestructura con software sobre GPU del cliente. No se deducen márgenes privados.
Dónde quedan defensas y problemas abiertos
El código abierto desplaza beneficios, no los elimina. Los cuatro componentes Run:ai estandarizan parte de la planificación, pero la distribución comunitaria no incluye soporte empresarial. Puede haber oportunidades duraderas en recuperación heterogénea, enrutamiento entre proveedores sujeto a políticas, atribución de costes y evidencia portable. Un router debe respetar región, retención, calidad y permisos de failover, no solo precio. Pesos abiertos no hacen portables IAM, evaluaciones ni estado de despliegue. Exige responsabilidades y exportación claras. Analiza qué fallo operativo recurrente tiene un presupuesto definido y si el proveedor de plataforma puede incluir su solución en el paquete.
4. Electricity data: scale and uncertainty
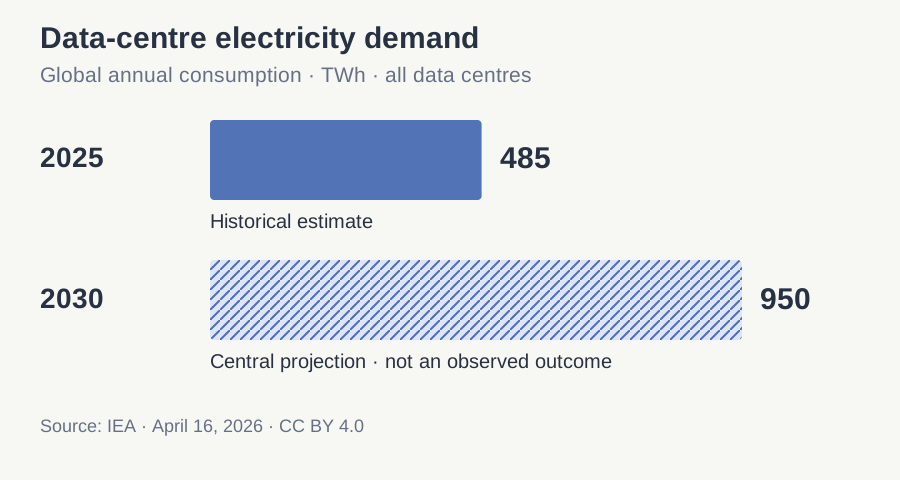
The IEA's 2026 update puts global data-centre electricity consumption at 485 TWh in 2025 and projects approximately 950 TWh in 2030 in its central outlook. These are not AI-only figures. The projected increase is roughly 1.96×, not an observation that consumption has already doubled. The report also identifies physical supply constraints, including HBM and power-system bottlenecks. IEA source, scope and assumptionshttps://www.iea.org/reports/key-questions-on-energy-and-ai/executive-summary.
Electricity demand is a useful scale indicator, not an AI capability metric. Lower energy per task can coexist with higher total consumption if adoption grows or tasks become more computationally intensive. A query that initiates repeated planning, retrieval and verification cannot be compared with a single short completion simply by counting user messages.
For a facility, distinguish IT load from total facility load. Power usage effectiveness is total facility energy divided by IT energy over the same measurement interval; it does not describe model quality. A lower value cannot compensate for wasted computation. For deployment decisions, measure energy per accepted task, peak power, cooling constraints and grid availability separately. A global TWh forecast cannot tell you whether a particular site can connect next quarter.
5. The technical frontier: what to optimize, and what can fail
Prefill and decode disaggregation
Prefill processes the input sequence and initializes the cache; decode repeatedly produces another token. Their operating points differ. DistServe studies separating the phases and selecting resource allocations around time-to-first-token and time-per-output-token constraints. Its original preprint appeared January 18, 2024; this reading pins arXiv v3, June 6, 2024. Abstracthttps://arxiv.org/abs/2401.09670v3 · PDFhttps://arxiv.org/pdf/2401.09670v3.
The useful inference is not “separation is always faster.” Moving cache state costs bandwidth and coordination. With short prompts or a constrained network, colocated execution can be simpler and competitive. Measure cache-transfer time, queue delay and both latency objectives. Hold offered load constant; a configuration that rejects difficult requests must not appear faster merely because it serves an easier subset.
KV cache as a first-class resource
Cache memory grows with active sequence tokens. Grouped-query attention reduces the number of key/value heads relative to query heads, changing memory requirements. Prefix caching can reuse shared prompt state, but tenant boundaries and cache keys must prevent unauthorized reuse. Offloading may increase capacity while adding transfer latency. These are separate interventions: benchmark each rather than calling all of them “cache optimization.”
Mixture of experts and interconnects
An MoE layer routes tokens to selected expert networks. Sparse activation reduces the arithmetic used per token relative to activating every expert, but weights still need storage and routing creates communication. Skewed expert demand can create hot spots. Compare expert placement, token imbalance, communication overlap and tail latency. Counting active parameters alone does not determine serving cost.
Quantization and speculative decoding
Lower precision can reduce memory traffic, but scales, outliers and unsupported kernels complicate the result. Verify downstream task quality and numerical behavior, not only model loading. Speculative decoding proposes multiple tokens and verifies them with a target model; useful acceleration depends on acceptance, proposal cost and verification efficiency. Keep the target distribution and implementation assumptions explicit. A fast draft with low acceptance can slow the full system.
Training reliability and elastic scheduling
Large training jobs coordinate many devices. More devices create more opportunities for hardware or software interruption. Checkpoint frequency trades useful computation against recovery exposure; storage contention can make frequent checkpoints expensive. For a shared cluster, optimize fairness and queue wait as well as accelerator occupancy. High utilization from low-priority work is not success if urgent jobs repeatedly miss deadlines.
Adquisiciones, capital e implicaciones estratégicas
Las adquisiciones desplazan el punto de control
CoreWeave anunció W&B el 4 de marzo de 2025 y cerró el 5 de mayo; anunció OpenPipe el 3 de septiembre y su declaración vincula el cierre al día 5. Conecta así capacidad, desarrollo y postentrenamiento. Databricks anunció MosaicML el 26 de junio de 2023 y cerró el 19 de julio; unos 1.300 millones incluían retención de personal. Su blog confirma Tabular completado el 7 de junio de 2024. Lakebase salió el 11 de junio de 2025 con tecnología Neon; no establecemos la fecha legal exacta del cierre de Neon. El patrón indica integración de flujos recurrentes, no prueba ventas cruzadas exitosas. Anuncio, cierre e integración son hitos diferentes.
Fuentes primarias de productos y transacciones
- NVIDIA: full Run:ai platform open-source release ↗https://developer.nvidia.com/blog/nvidia-runai-is-now-open-source-as-part-of-nvidia-dsx-ai-factory-platform ·
- NVIDIA Dynamo ↗https://www.nvidia.com/en-us/ai/dynamo/ ·
- Amazon Bedrock: data protection and shared responsibility ↗https://docs.aws.amazon.com/bedrock/latest/userguide/data-protection.html ·
- Amazon Bedrock: invocation permissions ↗https://docs.aws.amazon.com/bedrock/latest/userguide/inference.html ·
- Microsoft Foundry architecture ↗https://learn.microsoft.com/en-us/azure/foundry/concepts/architecture ·
- Microsoft Foundry network isolation ↗https://learn.microsoft.com/en-us/azure/foundry/how-to/configure-private-link ·
- Google Cloud service-specific data residency ↗https://cloud.google.com/terms/data-residency ·
- Google Cloud: securely deploying AI ↗https://cloud.google.com/blog/products/identity-security/mastering-secure-ai-on-google-cloud-a-practical-guide-for-enterprises/ ·
- CoreWeave completes Weights & Biases acquisition ↗https://www.coreweave.com/blog/coreweave-completes-acquisition-of-weights-biases ·
- CoreWeave 2025 Form 10-K ↗https://www.sec.gov/Archives/edgar/data/1769628/000176962826000104/crwv-20251231.htm ·
- Nebius Cloud 3.6 governance release ↗https://nebius.com/newsroom/nebius-ai-cloud-3-6-strengthens-developer-experience-and-governance-for-production-operations ·
- Nebius–Microsoft agreement ↗https://www.sec.gov/Archives/edgar/data/1513845/000110465925088312/tm2525580d1_6k.htm ·
- Together dedicated model inference ↗https://www.together.ai/dedicated-model-inference ·
- Together EU deployment requirements ↗https://support.together.ai/articles/8079447813-eu-data-centers-and-dedicated-model-deployment ·
- Fireworks Sovereign shared responsibility ↗https://fireworks.ai/product/sovereign ·
- Fireworks enterprise controls and retention exceptions ↗https://fireworks.ai/solutions/for-enterprise ·
- Baseten security practices ↗https://www.baseten.co/security-practices ·
- Databricks–MosaicML acquisition agreement ↗https://www.databricks.com/company/newsroom/press-releases/databricks-signs-definitive-agreement-acquire-mosaicml-leading-generative-ai-platform ·
- Databricks issuer release: MosaicML acquisition completed ↗https://www.prnewswire.com/news-releases/databricks-completes-acquisition-of-mosaicml-301881059.html ·
- Databricks–Tabular completed acquisition update ↗https://www.databricks.com/blog/databricks-tabular ·
- Databricks Lakebase launch powered by Neon ↗https://www.databricks.com/company/newsroom/press-releases/databricks-launches-lakebase-new-class-operational-database-ai-apps ·
- CoreWeave announces OpenPipe agreement ↗https://www.coreweave.com/news/coreweave-to-acquire-openpipe-leader-in-reinforcement-learning ·
- CoreWeave 2025 Q3 filing: OpenPipe closing ↗https://www.sec.gov/Archives/edgar/data/1769628/000176962825000062/crwv-20250930.htm ·
Source and maintenance notes
Primary links are placed beside the claims they support. Acquisition amounts retain their original basis; undisclosed values remain undisclosed. Product specifications and release statements are vendor disclosures, not comparative evidence from Token Lab. The diagrams and reference calculations are original educational material. Corrections should identify the section, source and proposed replacement; a source-access date is not a paper publication date.
All frontier research · Top Company Frontier · Editorial standards
Práctica y verificación
Práctica: infraestructura bajo fallos y carga
Detén el modelo tras proponer: al reiniciar sigue pendiente de aprobación. Detén workflow tras confirmación de herramienta y concilia antes de repetir. El transcript no es un checkpoint durable.
Inyecta timeouts, argumentos inválidos y versiones incompatibles. Exige intentos acotados, estados explícitos y misma autorización en rutas principal y alternativa; compara abstención segura con presupuesto igual.
Reproduce contextos largos, herramientas lentas, cancelaciones, picos, caché fría y fallos hasta detectar fugas o colas crecientes. Registra hardware, precisión, modelo, scheduler y software. Compara throughput con p95 y aceptación iguales; fija rollback antes.
Supera límites de actividad y cola: verifica sobrecarga explícita, memoria acotada y progreso de otro inquilino. Varía entrada, salida y prefijos por separado, con caché fría/caliente y aislamiento. Informa throughput, cola de latencia, memoria y aceptación.
Recupera de caída regional, cuota agotada, búsqueda lenta y reinicio en aprobación; comprueba cancelación, revocación e idempotencia. Distingue mediciones locales de garantías distribuidas no probadas.
7. Reproduce a memory and cost budget
This is an original teaching calculation, not a vendor benchmark. Assume B active sequences, T cached tokens per sequence, L transformer layers, Hkv key/value heads, head dimension d and b bytes per stored value. K and V each have shape [B, Hkv, T, d] per layer. Ignoring allocation overhead and sharding:
For B=8, T=8192, L=32, Hkv=8, d=128 and b=2, the cache occupies 8 GiB. At 32768 tokens it occupies 32 GiB. Changing Hkv from 8 to 32 also gives 32 GiB at the shorter length. GiB means 2³⁰ bytes; device specifications expressed in GB need conversion before subtraction.
This is logical total cache size, not a claim about per-device allocation. Add weights, temporary activations, runtime reservations, fragmentation and any duplicated/sharded state. Weight quantization does not automatically quantize the cache. In a mixed-length batch, replace B×T with the sum of each active sequence's cached length.
At an illustrative $8 per hour and two accepted requests per second, the capacity cost is $0.001111 per accepted request. One accepted request per second doubles it. These hypothetical prices exclude network, storage, labor and idle reservations. “Accepted” should include a task-quality check and the agreed latency constraint; otherwise a faster but less useful system gets an unfair advantage.
Local capacity experiment
KV cache: 8.000 GiB for the stated eight-sequence configuration.
Predict the result before doubling the context length. No inputs leave your browser.
Download infra-capacity.py. Python 3.10+, standard library only; deterministic arithmetic, no random seed, network requests or model API. Run python3 infra-capacity.py.
"""Teaching arithmetic, not a GPU benchmark. Python 3.10+, standard library."""
from math import isclose


def kv_gib(batch, tokens, layers, kv_heads, head_dim, bytes_per_value):
    values = (batch, tokens, layers, kv_heads, head_dim, bytes_per_value)
    if any(not isinstance(x, int) or isinstance(x, bool) or x <= 0 for x in values):
        raise ValueError("All dimensions and bytes per value must be positive integers")
    return 2 * batch * tokens * layers * kv_heads * head_dim * bytes_per_value / 2**30


def cost_per_success(hourly_cost, accepted_per_second):
    if hourly_cost < 0 or accepted_per_second <= 0:
        raise ValueError("Nonnegative cost and positive accepted throughput required")
    return hourly_cost / (3600 * accepted_per_second)


if __name__ == '__main__':
    small = kv_gib(8, 8192, 32, 8, 128, 2)
    long = kv_gib(8, 32768, 32, 8, 128, 2)
    assert small == 8 and long == 32
    assert kv_gib(8, 8192, 32, 32, 128, 2) == 32
    assert kv_gib(8, 8192, 32, 8, 128, 1) == 4
    assert isclose(cost_per_success(8, 2), 8/7200)
    assert cost_per_success(8, 1) == 2 * cost_per_success(8, 2)
    for args in [(0, 1, 1, 1, 1, 2), (1, -1, 1, 1, 1, 2)]:
        try:
            kv_gib(*args)
        except ValueError:
            pass
        else:
            raise AssertionError('Invalid dimensions accepted')
    print(f'KV: 8k = {small:.1f} GiB; 32k = {long:.1f} GiB')
    print(f'Cost per accepted request: ${cost_per_success(8, 2):.6f}')
    print('8 checks passed')
Expected output:
KV: 8k = 8.0 GiB; 32k = 32.0 GiB
Cost per accepted request: $0.001111
8 checks passed
A real benchmark protocol
Pin the model checkpoint, tokenizer, runtime commit, kernels, precision, hardware topology and power configuration. Replay the same timestamped request trace under cold and warm caches. Sweep offered load until an SLO fails. Report arrivals, successful completions, errors, quality, p50/p95/p99 latency and throughput together. Repeat independent runs and publish spread, not just the best run.
Ablate one factor at a time: colocated versus separated phases; cache reuse off versus on; full versus reduced precision. Compare equal hardware budgets first, then equal cost and power budgets if available. Do not drop out-of-memory failures from the denominator. This lesson verifies arithmetic only; it does not run a GPU service or reproduce a paper's headline speedup.
8. Open problems and original interview practice
Unresolved problems: managing long-lived agent state without runaway memory; sharing processors without noisy-neighbor latency; predicting MoE traffic; reliable heterogeneous execution; reducing recovery loss; and reconciling interactive demand with power constraints. Each problem joins at least two layers. A promising research question specifies both an improvement and the condition under which it stops helping.
For example: can a scheduler reduce p99 latency without reducing accepted throughput for another tenant? Can a cache-placement policy save memory without increasing disclosure risk? Can a hardware-independent intermediate representation preserve performance across kernels rather than merely compile? These are measurable questions. “More efficient infrastructure” is not yet an experiment.
The following are original simulations, not reported company interview questions.
1. Why can a 2× faster kernel leave end-to-end latency almost unchanged?
First hint: Separate queue, computation, communication and tool time.
Answer and analysis
If the improved kernel was only 10% of total latency, halving it changes total time from 1 to 0.95: approximately 1.053× speedup. Queueing can further change the result under load. Measure the critical path before optimizing.
Score yourself: 1/5 names the concept; 2/5 defines it; 3/5 derives the relevant mechanism or calculation; 4/5 tests a counterexample; 5/5 states assumptions, trade-offs and an evaluation that could disprove the answer.
2. A model fits in memory. Why can inference still fail?
First hint: Weights are not the only resident state.
Answer and analysis
Concurrent KV caches, activation workspace and allocator reservations can exhaust memory. Calculate each term with units, inspect actual peak allocations, then test mixed sequence lengths and admission control. Model parameter count alone is insufficient.
Score yourself: 1/5 names the concept; 2/5 defines it; 3/5 derives the relevant mechanism or calculation; 4/5 tests a counterexample; 5/5 states assumptions, trade-offs and an evaluation that could disprove the answer.
3. When does prefill/decode separation lose?
First hint: Account for the state crossing the boundary.
Answer and analysis
Transfer and coordination can dominate for short requests or slow links. Sweep prompt length and offered load with fixed SLOs, include network contention, and compare equal resources. A paper’s maximum speedup is not a universal prediction.
Score yourself: 1/5 names the concept; 2/5 defines it; 3/5 derives the relevant mechanism or calculation; 4/5 tests a counterexample; 5/5 states assumptions, trade-offs and an evaluation that could disprove the answer.
4. What would make a cheaper accelerator more expensive per successful request?
First hint: Include software, utilization and failures.
Answer and analysis
Lower rental cost can be offset by unavailable kernels, compilation, retries, low quality or idle reservation. Compare accepted goodput and total ownership costs using the same workload, not hardware price alone.
Score yourself: 1/5 names the concept; 2/5 defines it; 3/5 derives the relevant mechanism or calculation; 4/5 tests a counterexample; 5/5 states assumptions, trade-offs and an evaluation that could disprove the answer.
Continue with inference systems, the attention project and the companion AI security survey. These topics meet at cache isolation, scheduling privileges and operational reliability.
9. Frontier research agenda: five falsifiable projects
The following are Token Lab's proposed research directions, not claims that these methods have already succeeded or are novel. Search the literature before claiming novelty. Each proposal starts with an engineering failure and ends with evidence that would count against the idea. Select one narrow workload for a first PoC; broad claims require replication across tasks, implementations and operating conditions.
1. Long-context capacity under a latency budget
Why existing approaches are insufficient: A scheduler that treats each request as an identical job ignores the memory-time footprint of a long context. Reserving only current cache size can over-admit work; reserving maximum context can waste capacity.
Testable hypothesis: A reservation policy using predicted remaining tokens can improve accepted throughput at a fixed out-of-memory risk and latency SLO.
Baselines and fair comparison: Compare current-size reservation, worst-case reservation and a simple length-bucket policy before adding a learned predictor. Use the same arrival trace and cap total memory.
Measurements: Report accepted goodput, rejection rate, prediction calibration, out-of-memory events and p99 latency by length bucket. Include deliberately underestimated output lengths.
What would falsify the claim: Reject the hypothesis if the apparent gain comes from rejecting long requests, increasing failures, or obtaining future token lengths unavailable at admission. A useful system should degrade gracefully when predictions are wrong.
2. Disaggregation when the network is shared
Why existing approaches are insufficient: Dedicated-link benchmarks can hide contention. Prefill/decode separation moves a large cache between stages while training, storage and other tenants may use the same fabric.
Testable hypothesis: Topology-aware placement and bounded transfers can preserve the gain under realistic cross-traffic.
Baselines and fair comparison: Compare colocated serving, naive separation and bandwidth-aware placement. Sweep prompt length, batch size and network contention without changing total accelerators.
Measurements: Measure transfer bytes and duration, queue wait, TTFT, TPOT and goodput. Report the crossover region where separation stops helping, not only the best configuration.
What would falsify the claim: Reject if the method needs dedicated bandwidth that the baseline was denied, or reduces one latency metric by violating the other. A robust result includes topology changes and link degradation.
3. Portable performance across accelerator families
Why existing approaches are insufficient: A model can compile on two systems while one falls back to slow kernels or numerical approximations. Portability of source code and portability of performance are different goals.
Testable hypothesis: A small set of workload-aware kernel choices can retain quality and predictable performance across two supported platforms.
Baselines and fair comparison: Use the default runtime, hand-tuned platform paths and the proposed portable selection policy. Pin model weights and compare identical task outputs with appropriate numerical tolerances.
Measurements: Report compile time, fallback operations, end-to-end cost, energy when measurable, quality and maintenance effort. Include dynamic sequence shapes and an unseen model variant.
What would falsify the claim: Reject if gains require per-model manual retuning comparable to the specialized baseline, or if quality drops explain throughput. Document unsupported operators instead of silently excluding them.
4. Power-aware service without exporting the cost to users
Why existing approaches are insufficient: Optimizing energy in isolation can defer work until queues become unacceptable; optimizing latency alone can create demand peaks. Long reasoning workloads further vary per-request compute.
Testable hypothesis: A controller that jointly chooses admission, batching and power limits can reduce energy per accepted task while maintaining a declared latency envelope.
Baselines and fair comparison: Compare fixed power, static batching and an SLO-only scheduler. Replay identical bursts; keep task quality fixed and include controller overhead.
Measurements: Measure joules per accepted task, wall power, p95/p99 latency, throughput, rejection and recovery after a burst. State whether power is device-only or facility-wide.
What would falsify the claim: Reject if saved energy is just unserved work, if the measurement omits another device, or if gains vanish outside a smooth synthetic trace. Grid-level claims require evidence beyond GPU telemetry.
5. Persistent agent state across failures and tenants
Why existing approaches are insufficient: An agent session may outlive a process, move across hardware and hold private context. Cache migration and prefix reuse create both a systems optimization and an authorization problem.
Testable hypothesis: A versioned state protocol with tenant-scoped keys can support recovery without exposing stale or unauthorized context.
Baselines and fair comparison: Compare no reuse, process-local reuse and shared reuse with explicit ownership. Inject restarts, revocations and concurrent updates.
Measurements: Measure recovery time, recomputation, cache hit rate, accepted throughput and isolation violations. Test correctness of outputs and policy decisions after each migration.
What would falsify the claim: Reject if recovery works only without revocation, if a cross-tenant key collision leaks state, or if the method assumes all workers are equally trusted. This is a joint infrastructure/security project.
From a two-week PoC to a defensible report
In the first stage, write the system boundary, assumptions and failure criterion before implementing the proposed method. Build the simplest baseline and a reproducible fixture. In the second stage, add one intervention and run controlled sweeps; retain failed runs and explain exclusions. In the final stage, test an unseen workload or attack family and write a limitations section. Separate what your experiment measured from what you hope will generalize.
A useful report contains a configuration manifest, data-generation procedure, code commit, exact commands, raw observations, aggregation script and a table of threats to validity. Use multiple seeds when randomness matters; repeated deterministic arithmetic is not independent evidence. Publish negative results: the boundary where a technique stops working is often the most transferable lesson.