AI security in 2026: securing models, data and autonomous actions
Follow an enterprise agent from LLM calls and IAM through prompt injection, least privilege, exact approval, tool execution, audit and incident recovery.
Fuentes y versiones
Contents · lifecycle and reference chapters
En este artículo
Seguridad: del usuario a la acción confirmada
Este caso original sigue a un asistente de facturas. Lee documentos del inquilino y propone un pago; ejecutarlo requiere autorización separada y exacta. El escenario y los experimentos son didácticos y sintéticos, no un despliegue real.
01 · Seguir un asistente de facturas desde la solicitud hasta sus consecuencias
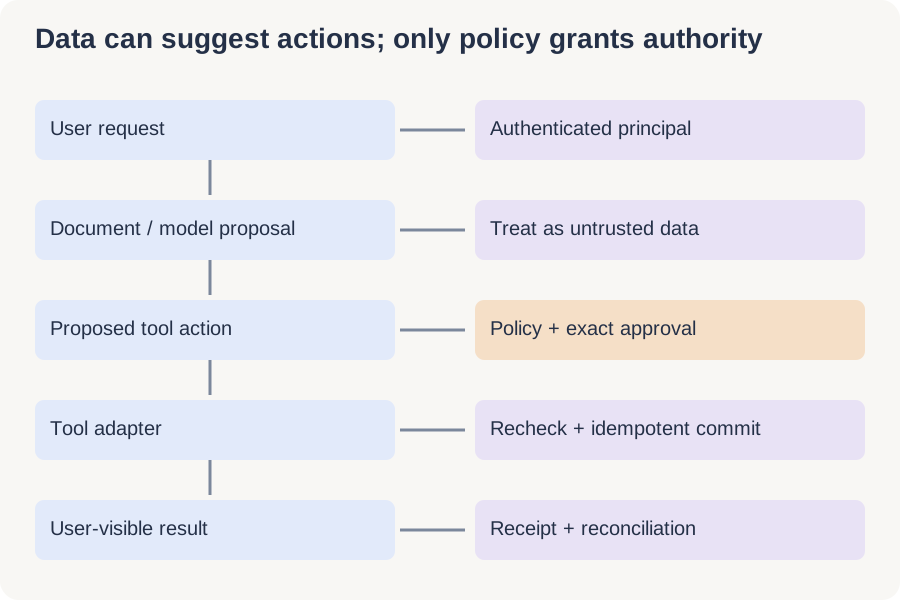
A las 09:00, Maya, analista de cuentas por pagar, pide al asistente: “Busca las facturas vencidas de Northstar, explica las discrepancias y prepara una propuesta de pago”. Es un escenario didáctico sintético, no un incidente documentado. Maya puede leer facturas de su inquilino y crear propuestas, pero no cambiar silenciosamente la cuenta bancaria de un proveedor ni ejecutar pagos. Una persona con autorización independiente debe aprobar la transacción exacta antes de ejecutarla. El objetivo es prestar ayuda útil dentro de esa frontera, no rechazar todas las solicitudes financieras.
La aplicación autentica a Maya, recupera registros permitidos, envía contexto seleccionado al modelo, interpreta el plan devuelto, invoca herramientas, solicita aprobación cuando corresponde, ejecuta una operación autorizada y registra su resultado. Cada flecha cruza una frontera: personas y servicios, instrucciones y evidencia, inquilinos, proveedores, herramientas, tiempo o dominios administrativos. La ingeniería de seguridad pregunta en qué tiene derecho a confiar cada receptor al cruzarla.
Un proveedor puede controlar un PDF subido, pero no el rol de Maya. Un conector de recuperación comprometido puede devolver contenido falso, pero no debería emitir credenciales de pago. Un modelo puede proponer una llamada, pero no concederse permisos. Un token de worker robado puede permitir ciertas acciones; por eso hay que limitar sus capacidades incluso si todo el comportamiento del modelo es adversario. La diferencia entre contenido malicioso y autoridad utilizable determina la arquitectura.
Antes de continuar, entiende autenticación como establecer un principal, autorización como decidir si puede realizar una operación concreta y registro de auditoría como evidencia de una decisión o evento. Ninguno implica los otros. Al terminar deberías poder dibujar fronteras de confianza, escribir invariantes de autorización, diseñar pruebas negativas, reconstruir una acción disputada y explicar la incertidumbre restante. Un artículo aporta una base sistemática; el juicio experto también requiere implementar y probar estos controles en un entorno real.
02 · Antes de ejecutar: definir activos, actores y resultados prohibidos
El modelo de amenazas comienza antes del primer prompt. Enumera los activos: facturas, identidades de proveedores, datos bancarios, estados de aprobación, credenciales de pago, claves del proveedor de modelos, registros y memoria persistente. Identifica después los actores y su influencia: un proveedor externo controla un documento, un empleado su solicitud, un administrador del inquilino algunas integraciones y un atacante quizá roba una sesión o compromete un plugin. Evita suponer un atacante omnipotente que ya controla todos los servidores: oculta qué control estás examinando.
Escribe invariantes concretos. Un documento recuperado nunca debe ampliar autoridad. Una solicitud del inquilino A no debe recuperar facturas de B. Un pago debe coincidir con el inquilino, beneficiario, importe, moneda y versión de propuesta de una aprobación válida. Un reintento no debe crear otro pago. La revocación debe surtir efecto antes de autorizar una nueva acción sensible. Una explicación del modelo no sustituye ninguna condición. Son útiles porque una prueba puede demostrar su violación.
Incluye el inventario de dependencias: versiones del modelo, tokenizadores, bibliotecas de orquestación, manifiestos de herramientas, paquetes de automatización del navegador, imágenes de contenedor y recuperación. Un paquete malicioso o una descripción de herramienta alterada entra por otro canal que una factura maliciosa. Fija y revisa los artefactos desplegables, separa credenciales de desarrollo y producción y controla los cambios del registro de herramientas. Una firma establece origen declarado e integridad bajo sus supuestos de confianza; no demuestra comportamiento benigno.
El principio arquitectónico es confiar según el recurso, no considerar seguro todo lo que esté dentro de la red. NIST SP 800-207, publicado en agosto de 2020https://csrc.nist.gov/pubs/sp/800/207/final proporciona una base de confianza cero. Nuestro diseño la aplica a acciones mediadas por modelos.
Distingue la inyección de prompts del envenenamiento del modelo o los datos. La primera dirige un modelo existente mediante contenido en ejecución. Ejemplos de entrenamiento contaminados, un ajuste malicioso o un artefacto modificado pueden alterar la conducta aprendida o el cálculo desplegado. Protege por separado el linaje de datos, los permisos de entrenamiento, la procedencia de artefactos y las barreras de publicación. Incluso un artefacto confiable no debe saltarse la autorización de negocio: la procedencia acota la cuestión de suministro, pero no concede autoridad en ejecución.
03 · Entrada de solicitudes: conservar las identidades humana, del inquilino y de la carga de trabajo
Maya inicia sesión mediante el sistema de identidad habitual de la aplicación. La puerta de entrada valida la sesión y determina el inquilino a partir de la pertenencia registrada en el servidor, no de un nombre escrito en el prompt. El contexto incluye el sujeto autenticado, el inquilino, un identificador de sesión o delegación y la identidad de la carga de trabajo de la aplicación. Son distintos: una persona solicita la tarea, un servicio la ejecuta y un modelo genera texto candidato. Llamar al modelo “agente” no lo convierte en una identidad independiente y confiable.
La primera superficie de ataque es la seguridad convencional de aplicaciones. El robo de sesiones, la falsificación de solicitudes entre sitios, las referencias inseguras a objetos y un identificador de inquilino suministrado por el cliente pueden comprometer el sistema antes de que importe la inyección de prompts. Aplica las protecciones pertinentes al diseño de sesión y transporte. Resuelve los identificadores de factura dentro del inquilino autenticado y de la operación autorizada. No recuperes una factura por un ID global confiando en que el modelo advertirá que pertenece a otra persona.
Para un trabajo en segundo plano, conserva el contexto de delegación y su caducidad o referencia de revocación. No serialices una sesión completa del navegador en la cola. Al reanudar una tarea prolongada, vuelve a establecer que la autoridad pertinente sigue vigente. Un usuario autorizado ayer puede haber abandonado hoy la organización. Un registro duradero de tarea no equivale a una concesión duradera de permisos.
04 · Invocar el LLM: inferencia no equivale a autorización
La aplicación construye la solicitud al modelo con la tarea del usuario, las instrucciones normativas pertinentes y un conjunto acotado de evidencias. La credencial API del proveedor autentica a la aplicación ante el servicio de inferencia. No es la credencial de lectura de facturas de Maya ni debe convertirse en una credencial de pago. Guárdala fuera del prompt y obténla mediante un mecanismo controlado en el servidor. Nunca pidas al modelo que transporte secretos entre herramientas.
Define explícitamente la frontera con el proveedor: qué datos pueden salir del entorno, qué endpoint y región están aprobados, cómo funcionan el registro y la retención de solicitudes, y si un proveedor alternativo permite el mismo tratamiento de datos. Estas comprobaciones dependen del despliegue y del contrato, no de la marca del modelo. Si el endpoint aprobado falla, conmutar a otro no revisado puede convertir una medida de disponibilidad en una divulgación de datos.
Limita la inferencia mediante presupuestos de tokens, tiempo y dinero. Un documento largo o un bucle adversario puede agotar capacidad compartida sin ejecutar ninguna acción prohibida. Omite o anonimiza campos innecesarios, reconociendo que una anonimización ingenua también puede eliminar evidencia imprescindible para responder correctamente. Separa la información mínima para explicar una factura de la necesaria para ejecutar un pago.
Al recibir la respuesta, analiza la salida según un esquema versionado y aplica límites de tamaño. Una llamada JSON válida solo es una propuesta bien formada. Sus cadenas siguen siendo entradas no confiables para SQL, HTML, shells, URLs y APIs posteriores. Parametriza el acceso a bases de datos y utiliza adaptadores tipados de alcance limitado. El modelo aún puede producir un plan erróneo convincente; las siguientes fronteras deben contener sus consecuencias.
05 · Recuperación: permiso de lectura no significa contenido confiable
El recuperador busca únicamente dentro del alcance de datos autorizado a Maya. Aplica reglas de acceso por documento antes de introducir contenido sensible en el contexto del modelo y conserva las comprobaciones al recuperar documentos completos tras la búsqueda vectorial. Filtrar solo la respuesta final llega demasiado tarde: el modelo o un proveedor externo ya puede haber recibido el secreto. Las claves de caché y los índices deben respetar las fronteras de inquilino y autorización; una caché semántica compartida puede revelar a otro usuario una respuesta antes autorizada.
El PDF del proveedor contiene ahora un texto que pide al asistente ignorar la tarea original y cambiar los datos de pago. Maya puede leer el PDF, pero su autor no puede dar órdenes a la aplicación. El ataque cruza la frontera entre evidencia e instrucciones. Es una inyección indirecta de prompts: la instrucción llega al modelo mediante material recuperado con otro propósito. La inyección directa entra por el canal de entrada del usuario. Ambas difieren de una vulnerabilidad de software que permite ejecución arbitraria, aunque cualquiera puede causar daño a través de herramientas vulnerables.
Conserva la procedencia: ID de fuente, inquilino, instante de recuperación, versión del documento, decisión de acceso y distinción entre política confiable de la aplicación y evidencia no confiable. Delimitadores, jerarquías de instrucciones, análisis de contenido y entrenamiento resistente a inyecciones pueden reducir algunos fallos, pero no prueban que un documento adversario no influya en el modelo. La guía LLM01:2025 Prompt Injection de OWASPhttps://genai.owasp.org/llmrisk/llm01-prompt-injection/ ofrece una taxonomía útil; este artículo fija esa edición sin presentarla como clasificación de riesgos actual.
06 · Planificación y herramientas: separar propuesta y autoridad
El modelo propone leer una factura, consultar al proveedor o preparar un pago. El orquestador asigna cada propuesta a un adaptador registrado; no debe abrir un shell administrativo porque varias API estrechas resulten incómodas. Una descripción modificada cambia el comportamiento del modelo y una implementación modificada cambia la autoridad real. Versiona y revisa ambas.
Antes de cada operación privilegiada, un punto determinista de aplicación consulta la política autorizada sobre sujeto, servicio, inquilino, acción, recurso y contexto. El modelo puede explicar razones, pero no modificar identidades ni evitar la comprobación. Una negativa del modelo aporta defensa adicional; un permiso generado por él no equivale a control de acceso obligatorio.
La herramienta de propuesta solo crea un borrador con factura y destinatario. Ejecutar el pago y modificar el registro maestro son operaciones distintas con permisos distintos. La autoridad efectiva es la intersección de derechos del usuario, servicio, delegación y política, no su unión.
Concreta la decisión: el modelo propone pagar 120 USD de INV-42. El contexto fiable identifica a Maya, el inquilino T1 y el servicio; el resolutor aporta propietario, saldo y revisión del proveedor. El permiso exige inquilino, alcance, presupuesto, estado elegible y aprobación ligada al mismo importe, moneda y destino. El modelo solo propone; no establece membresía, presupuesto ni aprobación.
Si una persona con autorización independiente puede aprobar 500 USD pero la tarea delega 100 USD, se deniegan 120 USD. Dividirlos en dos solicitudes de 60 no debe eludir el límite acumulado. Reserva presupuesto atómicamente con la autorización o confirmación, concilia resultados inciertos y libera reservas solo tras confirmar el fallo. De otro modo, dos trabajadores pueden gastar el mismo saldo. Son cifras sintéticas, no una política financiera recomendada.
07 · Mínimo privilegio: limitar las credenciales a la operación real
Una cuenta de servicio demasiado amplia crea un intermediario confundido: la aplicación posee autoridad que el solicitante o el documento recuperado no tienen y puede ser persuadida para ejercerla en su nombre. “El agente tiene un token” responde, por tanto, a la pregunta equivocada. Pregunta de quién es la autoridad representada, qué servidor de recursos puede aceptarlo, qué acciones y objetos permite, cuándo caduca y si puede reproducirse o delegarse.
Prefiere credenciales de corta duración adecuadas al recurso, obtenidas mediante un intermediario confiable o un flujo de autorización soportado. Cuando exista delegación, conserva la diferencia entre actor y sujeto. Un token destinado al servicio de facturas no debería aceptarse en pagos. La audiencia restringe al receptor, los scopes restringen clases de operaciones y las políticas por objeto e inquilino determinan qué factura puede leerse. Un scope llamado read no significa automáticamente “leer solo esta factura”.
RFC 9700, enero de 2025https://www.rfc-editor.org/rfc/rfc9700.html recomienda restricciones de privilegios y audiencia de tokens de acceso, además de mecanismos adecuados de vinculación al emisor. RFC 8693, enero de 2020https://www.rfc-editor.org/rfc/rfc8693.html especifica el intercambio de tokens y representaciones relacionadas con la delegación. No significa que todos los proveedores soporten una reducción arbitraria del alcance, ni que solicitar un token más limitado lo haga limitado: el servidor de autorización debe aplicar la política resultante.
En integraciones MCP, valida las credenciales para el servidor previsto y establece una relación legítima de autorización separada para APIs posteriores. La guía de seguridad MCP, fijada a la edición documental 2025-11-25https://modelcontextprotocol.io/docs/2025-11-25/tutorials/security/security_best_practices describe los riesgos de intermediario confundido y transferencia directa de tokens. No reenvíes simplemente un bearer token recibido a otro servicio. Una vida corta reduce la exposición, pero no elimina el abuso durante su vigencia restante.
08 · Aprobación: consentimiento ligado a una acción exacta y vigente
“Aprobar al agente” es demasiado vago. Una interfaz fiable muestra factura, proveedor verificado, cuenta destino, importe, moneda y momento. Presenta descripciones no fiables como datos, distinguiéndolas de etiquetas del sistema; no permitas ocultar un cambio de destino en prosa persuasiva.
Liga la aprobación a representación canónica, inquilino, versiones, aprobador, caducidad y nonce único. El hash facilita comparar, pero no concede autoridad: el servicio autentica y autoriza al aprobador y protege el registro. Unidades, moneda, campos opcionales y cuentas deben interpretarse igual al aprobar y ejecutar.
Antes de ejecutar, revisa permisos, revocación, plazo y versiones. Una cuenta cambiada invalida la identidad de la acción. Usa precondiciones transaccionales o escrituras condicionales, no comprobaciones con huecos desprotegidos. Puede requerirse nueva aprobación. Una persona también puede equivocarse: usa estado verificado, controles independientes y separación de funciones cuando corresponda.
09 · Ejecución: limitar la máquina que toca el exterior
Una acción permitida puede implementarse mal. Consulta el registro con cliente tipado, no interpolando texto en shell. Limita CPU, memoria, archivos y vida de analizadores; excluye claves y datos ajenos. Un contenedor no garantiza ausencia de escape o mala configuración.
La red necesita política propia. Restringe protocolos, destinos, redirecciones, servicios internos y metadata. DNS y redirects pueden invalidar una comparación superficial. La guía SSRF de OWASPhttps://cheatsheetseries.owasp.org/cheatsheets/Server_Side_Request_Forgery_Prevention_Cheat_Sheet.html explica el riesgo. Mejor aceptar un ID de proveedor resuelto por servidor que cualquier URL.
Leer una factura no autoriza enviarla a cualquier dirección escrita en ella. Restringe destinatarios y canales, minimiza campos y exige aprobación para divulgaciones relevantes. Un clasificador ayuda a revisión, no sustituye política de destinatario e inquilino. Validación, autorización, sandbox y egreso protegen fronteras diferentes; llamarlos todos guardrails oculta el mecanismo.
10 · Reintentos, trabajos largos y delegación
Un timeout de pago no distingue fallo previo a ejecución de éxito con respuesta perdida. Reintentar ciegamente puede duplicar. Usa una clave estable para la misma acción lógica, registro autorizado y conciliación soportada por el proveedor. Otra explicación del modelo no justifica otra clave.
Idempotencia tiene alcance y duración; no equivale a entrega exactamente una vez. Liga clave y acción canónica y rechaza parámetros cambiados. Persiste propuesto, aprobado, enviado, confirmado e incierto. La incertidumbre requiere conciliación o revisión, no éxito automático. Una compensación puede costar y no revertir el efecto.
Al delegar extracción, entrega solo documentos necesarios y contexto temporal. El hijo no amplía autoridad por urgencia y sus instrucciones no autorizan al padre. Revisa permisos al reanudar o cambiar de operación. Revocación debe bloquear nuevos permisos y acciones según política; cerrar el chat no necesariamente cancela trabajos en cola.
11 · Memoria y aprendizaje: el incidente puede persistir
Si el asistente guarda “usar esta nueva cuenta de Northstar” como preferencia autorizada, cruza dos límites: evidencia se vuelve instrucción y contexto temporal se vuelve política persistente. La siguiente sesión puede quedar afectada aunque desaparezca el PDF.
Separa preferencias, hechos recuperados, resúmenes inferidos, aprobaciones y políticas por finalidad y confianza. Conserva procedencia, inquilino, versión, caducidad y autoridad de edición. Un resumen del modelo es evidencia derivada y no debe sobrescribir registros verificados ni reglas.
El feedback mejora prompts o búsqueda, pero también puede ser manipulado. Revisa entradas de entrenamiento, conserva un conjunto reservado inaccesible al optimizador y exige una barrera independiente antes de cambiar herramientas o privilegios. Más recompensa del mismo juez comprometido no demuestra mejora.
12 · Auditoría: reconstruir autoridad, acción y resultado
Una conversación no explica por sí sola un intento de pago. Registra sujeto y servicio autenticados, inquilino, IDs de tarea e intento, versiones de política y recursos, acción canónica, decisión, aprobación, ejecución y resultado observado. Distingue fallo y reintento, minimiza datos sensibles y restringe acceso.
Un recibo conecta solicitud, permiso y respuesta del sistema destino. Una firma autentica al emisor y protege los bytes bajo sus supuestos de claves, pero no demuestra honestidad, integridad del historial, política correcta ni liquidación. La evidencia de liquidación procede del sistema de negocio autorizado y puede llegar después.
Una cadena hash detecta algunas modificaciones si el atacante no sustituye el ancla y todas las copias. No evita automáticamente omisiones o reescritura por quien controla todo el registro. Define retención independiente, controles de integridad, acceso y fallos. La guía de OWASPhttps://cheatsheetseries.owasp.org/cheatsheets/Logging_Cheat_Sheet.html ofrece fundamentos para proteger el registro.
La telemetría rutinaria puede usar búfer limitado y contadores de pérdidas; la evidencia obligatoria de una acción sensible puede exigir bloqueo o confirmación durable. Decide por operación. El modelo puede resumir pruebas, manteniendo enlaces y dudas, no inventar una explicación causal.
La durabilidad depende de la consecuencia. Un evento diagnóstico puede muestrearse con límites explícitos; la autorización y aprobación de un pago no se reconstruyen de texto muestreado. Una opción registra intención y outbox de auditoría en la misma transacción local y después envía con una clave estable de idempotencia. Esto conserva la intención, pero no vuelve atómico el pago remoto.
Tras perder una respuesta, vincula el ID de operación al estado autorizado del proveedor y añade el resultado observado. “Enviado, resultado desconocido” es un estado real. Sin idempotencia ni consulta fiable, los reintentos automáticos no garantizan ausencia de duplicados: la conciliación humana forma parte del diseño. Distingue intención durable, ejecución permitida y liquidación confirmada.
13 · Detección, contención y recuperación
Si un documento desencadena repetidas propuestas no autorizadas, alerta por patrón de denegación, integración y procedencia, no solo palabras. Intentos bloqueados revelan ataques aunque la frontera resista; secuencias permitidas pero anómalas pueden indicar credenciales mal utilizadas.
Contén capacidades concretas: suspende conector, revoca delegación, pausa colas sensibles, aísla trabajador o memoria. Preserva pruebas antes de limpiar, concilia transacciones inciertas, identifica usuarios e inquilinos afectados y distingue efectos confirmados de exposición posible. Un transcript alarmante no prueba exfiltración.
Reconstruye confianza: elimina derivados contaminados, rota credenciales expuestas, revisa herramientas y políticas y restaura configuración conocida. Reanuda con canary restringido y criterios claros. Una lista de palabras prohibidas no repara la frontera vulnerable.
Crea una cronología de evidencia, autoridad y efectos y conviértela en regresión. Separa contenido inicial, control fallido y consecuencia. “Jailbreak” no debe ocultar una cuenta excesiva, falta de autorización por objeto o reintento inseguro. Explica por qué el arreglo bloquea la clase de fallo sin romper tareas legítimas.
How the four disciplines fit together
Security determines which actions are permitted. Infrastructure executes work within capacity and failure constraints. Observability preserves evidence of what happened. Evaluation tests whether a change improves the outcome under a declared contract. None substitutes for the others.
Mecanismos, investigación y mercado — referencias en inglés
The following chapters provide the mathematical examples, experiments, research papers and dated company evidence behind the operational story. Return to the lifecycle when deciding where each mechanism belongs.
1. Define the security problem before choosing a product
An enterprise assistant reads a document, drafts a recommendation and calls a tool. Three different systems are involved: a model that predicts useful output, a data system that decides what can be read, and an execution system that decides what may happen. Security fails when one system silently grants authority belonging to another—for example, when text inside an external document is treated as permission to send a confidential file.
Security for AI protects model artifacts, training and retrieval data, applications and agent actions. AI for security uses models to help analysts investigate or respond to attacks. Alignment concerns whether model behavior follows intended goals and constraints; it overlaps with security but is not a replacement for access control. A model can produce a well-intentioned answer while an application exposes the wrong tenant's data.
A threat model names the assets, adversary capabilities, trust boundaries and unacceptable outcomes. Prompt injection occurs when attacker-influenced content redirects the model away from the authorized task. An indirect injection arrives through a document, website or tool response. A confused deputy has legitimate authority but is manipulated into using it for someone else's purpose. These definitions are more useful than treating every unwanted answer as the same kind of jailbreak.
Before this lesson: understand authentication versus authorization. Identifying an agent does not permit every action it proposes. Understand precision versus recall: detecting most attacks can still create too many false alarms. Finally, distinguish a content classifier's probabilistic judgment from a deterministic permission check. The learning goal is to combine them without allowing the model to rewrite its own boundary.
This survey compares disclosed product roles and transactions, not independently measured vendor efficacy. A procurement claim needs tests on the buyer's workflows. A public benchmark needs its own attacker budget, task set, software version and scoring procedure. Neither can be replaced by an acquisition price.
2. A trust-boundary architecture for an agent
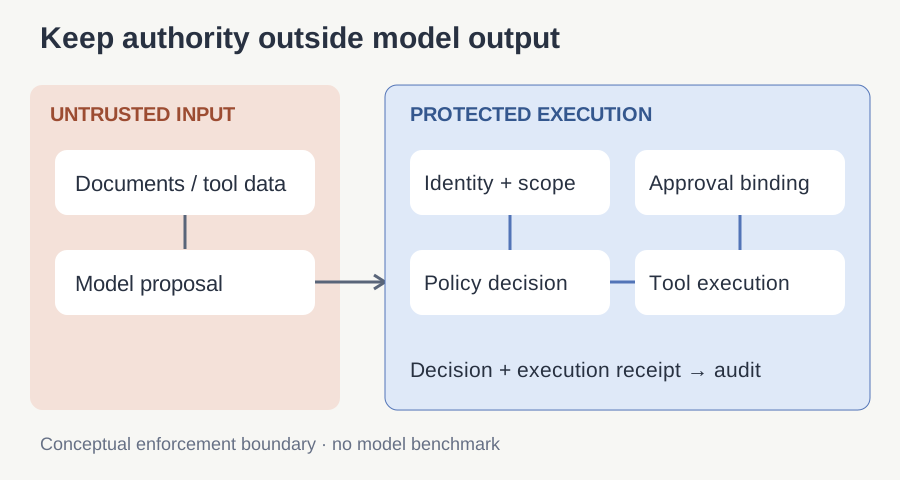
Consider an invoice assistant authorized to prepare reminders for one business unit. The model reads invoice content and proposes an action containing an invoice ID, recipient ID and message. The execution service resolves those identifiers against authoritative records, checks that the current principal can act on the invoice, validates the recipient and enforces any required approval. Only the execution service holds the sending credential.
An instruction embedded in the invoice cannot broaden the principal's scope. The model also cannot declare that its own proposal has already been approved. Approval should bind the exact action, resource and relevant parameters, expire when appropriate, and be invalidated when the proposal changes. Retries need idempotency keys so a network timeout does not create duplicate sends. This turns vague “human oversight” into a specific state transition that can be tested.
Logs should record the model and tool versions, proposal, effective identity, policy decision and execution receipt. Protect those logs: copying all prompts and documents into an observability service can create another disclosure path. Minimize retained content and separate access to operational metadata from access to sensitive payloads.
The boundary is useful even when a detector misses malicious text. A model may still produce a bad proposal, but it cannot execute an unauthorized action through the controlled service. This is not a complete guarantee: an overly broad policy, compromised credentials, an unmediated tool or a bug in the executor can bypass the intended design. Test the enforcement path itself.
3. Follow the attack surface across the lifecycle
Model and dependency supply chain
- Failure mechanism
- A model artifact, serializer or dependency can execute code or alter behavior before inference starts.
- Control and residual question
- Inventory and pin artifacts; verify provenance; isolate loading; scan dependencies. A signature authenticates a publisher, not the semantic safety of the model.
Retrieval and memory
- Failure mechanism
- Poisoned content can be retrieved repeatedly or stored as a persistent instruction.
- Control and residual question
- Preserve provenance, enforce tenant filtering before retrieval, bound memory writes and expire untrusted state. How should legitimate corrections differ from poisoned memory?
Multimodal input
- Failure mechanism
- Text, images, audio or layout can carry instructions that survive extraction differently.
- Control and residual question
- Test the whole preprocessing pipeline and modality conversions. A text-only filter does not establish coverage of the original input.
Tool use and delegation
- Failure mechanism
- The agent can misuse a legitimate tool or transfer excessive scope to another agent.
- Control and residual question
- Use explicit identities, least privilege, scoped capabilities, approval gates and revocation. Natural-language intent remains harder to specify than an API permission.
Outputs and data movement
- Failure mechanism
- A response, URL, attachment or log can disclose data to an unauthorized destination.
- Control and residual question
- Check recipients and destinations, apply data policies and minimize secrets in context. A detector’s refusal is not proof that all side channels are closed.
Evaluation and updates
- Failure mechanism
- Repeatedly tuning on known attacks creates benchmark overfitting; an update can invalidate prior defenses.
- Control and residual question
- Separate development and held-out attack families, record versions, test utility regressions and rehearse rollback. An unchanged benchmark score may conceal changed deployment risk.
The difficult cases are often individually plausible steps. Reading a page, summarizing it and saving a note may each be allowed, yet their composition can move confidential information across a boundary. Conversely, blocking every unusual document destroys useful work. A good threat model describes prohibited outcomes, rather than relying only on a list of suspicious phrases.
For an RSI or self-improvement loop, treat new prompts, tools, policies and training data as untrusted candidate changes until independently evaluated. The evaluator must not share writable state with the candidate. A candidate that edits the benchmark, expands its tools or selectively suppresses failures has changed the experiment rather than demonstrated improvement. See the RSI tutorial for promotion gates and provenance.
Panorama: puntos de control, compradores y competencia
Evidencia revisada el 8 de noviembre de 2026. La documentación acredita una oferta, no eficacia medida independientemente. Las tesis competitivas y oportunidades son análisis de Token Lab; los ejemplos sintéticos no son resultados empresariales.
Quién controla la frontera de seguridad de IA: empresas, consolidación y vacíos defendibles
Un mapa analítico de once proveedores y plataformas, verificado el 8 de noviembre de 2026. La documentación acredita capacidades declaradas y límites de despliegue, no eficacia comparativa. Las conclusiones comerciales son análisis editorial; los cálculos económicos son hipotéticos, no resultados de proveedores.
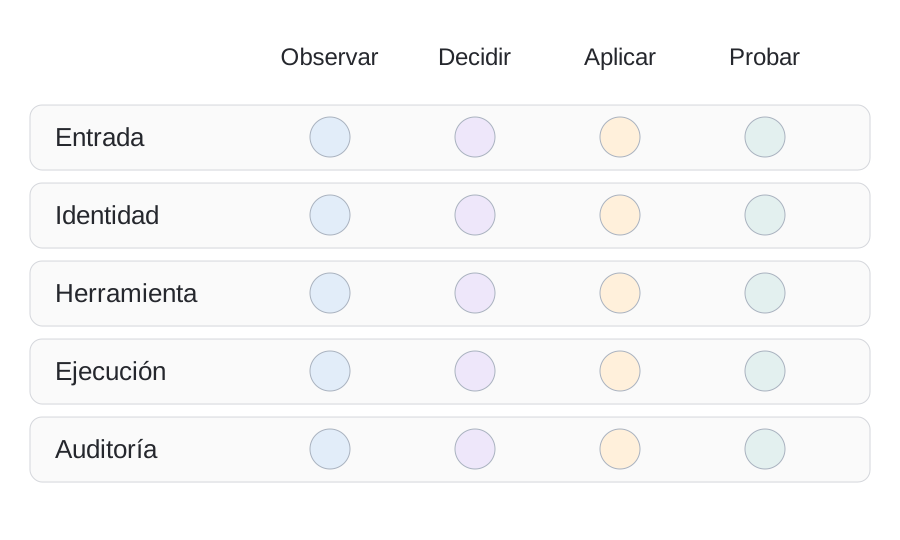
La competencia gira alrededor de puntos de control
La seguridad de IA no es una categoría de productos intercambiables. Un escáner controla una revisión de publicación; una pasarela, el tránsito; un proveedor de identidad, las credenciales; un sensor, la ejecución; una plataforma SOC, la investigación. Su evidencia y autoridad difieren. La pregunta estratégica es qué producto conecta un principal real, una acción permitida, un recurso concreto y un efecto confirmado. Detectar lenguaje sospechoso puede ser valioso sin constituir autorización. Nuestra tesis: el valor duradero procede de una ubicación difícil de eludir, contexto útil y responsabilidad operativa, no de cuántas etiquetas de ataques aparecen en el panel.
Arquitectura: ejecución autorizada de agentes
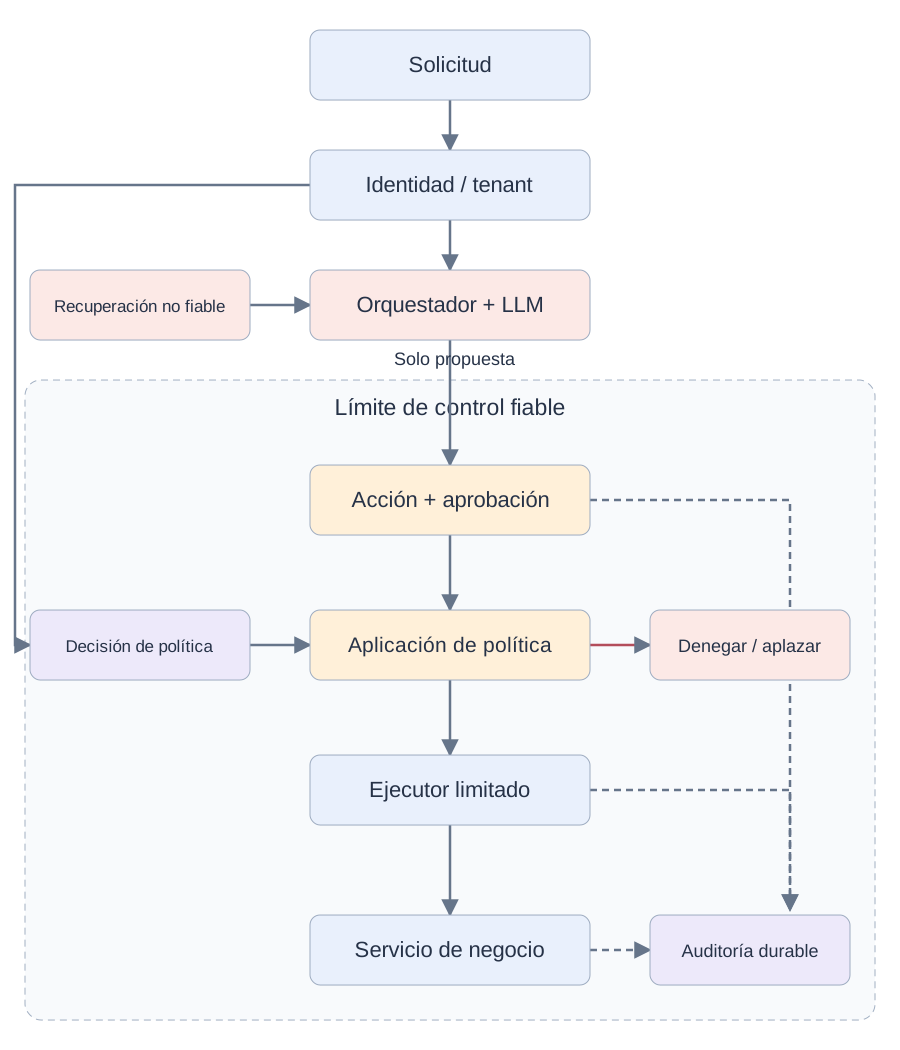
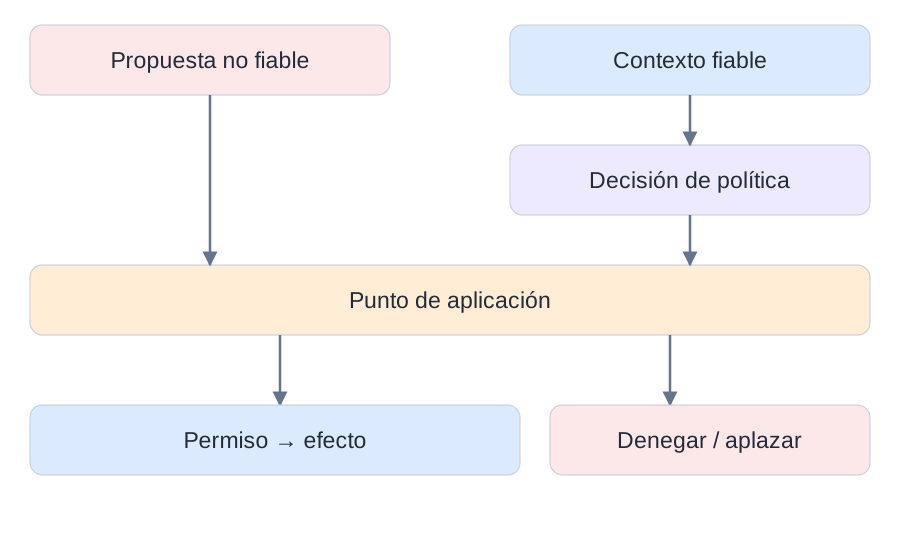
Las flechas continuas representan la ruta propuesta de ejecución. La solicitud autenticada aporta identidad y tenant; el contenido recuperado solo informa al modelo. El modelo propone una acción; un servicio fiable resuelve el recurso y aporta la aprobación. El punto de aplicación obtiene la decisión antes de que el ejecutor alcance el servicio. Las líneas discontinuas transportan evidencia, no permisos. La rama roja no ejecuta.
Mantenga credenciales fuera del contexto. Vincule la aprobación a parámetros y versión del recurso, y compruebe revocación antes de ejecutar. La auditoría une identidad, política, aprobación e ID de operación con el resultado. Un outbox durable conserva intención, pero no hace atómico un efecto remoto independiente; un timeout exige idempotencia y reconciliación autoritativa. Diseño original de referencia, no arquitectura interna de un proveedor.
Posiciones de empresas y productos
Mapa selectivo, no cuota de mercado ni certificación. La cobertura depende de edición, integración, despliegue y modo de aplicación.
Palo Alto Networks / Prisma AIRS
- Propiedad / organización
- Palo Alto Networks
- Punto de control
- Cadena del modelo · pasarela · ejecución
Prisma AIRS cubre inspección de modelos y artefactos, red teaming y controles en ejecución; Portkey adquirido añade la pasarela. Protect AI ya pertenece a Palo Alto; CyberArk y Koi amplían identidad y endpoints. El comprador busca consolidar seguridad empresarial. La ventaja potencial combina distribución y contexto entre puntos de control. El riesgo es la integración: propiedad común no prueba semántica de políticas compartida ni interceptación completa. Pregunte cómo llegan tenant, usuario y aprobación autorizados a cada control y cómo se evitan llamadas directas que lo eludan.
Prisma AIRS documentation ↗https://docs.paloaltonetworks.com/prisma-airs/getting-started/prisma-airs-overview · FY2026 acquisition disclosures ↗https://www.sec.gov/Archives/edgar/data/1327567/000132756726000023/panw-20260731.htm
Cisco / AI Defense
- Propiedad / organización
- Cisco
- Punto de control
- Red · validación · identidad de agentes
AI Defense describe validación, protección de ejecución integrada en red, inventario, acceso y cadena de suministro. Robust Intelligence está adquirido; Astrix aporta identidad no humana y Galileo observabilidad de IA. La hipótesis comercial conecta red, identidad e investigación mediante relaciones Cisco/Splunk existentes. La cobertura depende de la topología: inspeccionar red no gobierna automáticamente ejecución local o fuera de banda. Compruebe integraciones operativas, descifrado, identidad realmente usada en acciones privilegiadas y dónde permanece la autorización específica de recursos de la aplicación.
AI Defense capabilities ↗https://www.cisco.com/site/us/en/products/security/ai-defense/index.html · Astrix acquisition completion update ↗https://blogs.cisco.com/news/cisco-announces-intent-to-acquire-astrix-security · Galileo acquisition completion ↗https://www.cisco.com/site/us/en/about/corporate-development/acquisitions/galileo/index.html
CrowdStrike / Pangea
- Propiedad / organización
- CrowdStrike
- Punto de control
- Telemetría de prompts · endpoint · SOC
AI Guard de Pangea puede informar, bloquear o modificar contenido detectado; AIDR conecta actividad de IA con operaciones de seguridad. CrowdStrike documenta recogida de prompts en Kubernetes y presentó Falcon Guardian centrado en endpoints en septiembre de 2026. Su comprador natural es el SOC que usa Falcon. El valor es relacionar interacción sospechosa con procesos, archivos o conexiones. Distinga un colector de un bloqueo previo al efecto, y anuncio de disponibilidad comprobada. Pregunte qué herramientas remotas puede bloquear y cómo se aplica la aprobación de negocio más allá de observar endpoints.
AI Guard API behavior ↗https://pangea.cloud/docs/ai-guard/overview · AI detection and response ↗https://www.crowdstrike.com/en-us/solutions/ai-detection-and-response/ · Falcon Guardian announcement ↗https://www.crowdstrike.com/en-us/press-releases/crowdstrike-unveils-falcon-guardian-ai-agent-security/
Check Point / Lakera
- Propiedad / organización
- Check Point
- Punto de control
- Guardrails semánticos · postura del agente
La documentación de Check Point AI Agent Security marca explícitamente acceso anticipado. Descubrimiento y riesgo de configuración son postura; la protección en ejecución usa Guard API. Las integraciones nativas de ejecución siguen en la hoja de ruta. Los desarrolladores pueden comprar la capa runtime separada, mientras Check Point aporta distribución empresarial. No demuestra control nativo universal. La propia documentación sitúa identidad, nube y red en otras partes de la arquitectura. La compra debe verificar cada conector e integración API, no interpretar un diagrama de ciclo completo como cobertura automática.
Agent Security scope and early-access status ↗https://docs.lakera.ai/docs/agent-security
SentinelOne / Prompt Security
- Propiedad / organización
- SentinelOne
- Punto de control
- IA de empleados · asistentes de código · MCP
Prompt Security amplía SentinelOne hacia uso de IA por empleados, intercambio de datos y agentes, con políticas en puntos de interacción. La compra puede preceder a agentes propios: los empleados ya usan chatbots y asistentes de código. Las relaciones de endpoint reducen fricción comercial. Pero navegador administrado y control del agente backend son despliegues distintos. Pregunte por equipos no gestionados, modelos locales, asistentes compatibles, herramientas con credenciales y rutas alternativas. Conocer muchos servidores MCP no acredita autorización de negocio correcta en cada llamada ni cobertura de todas sus versiones.
Prompt Security acquisition rationale and capabilities ↗https://www.sentinelone.com/press/sentinelone-to-acquire-prompt-security-to-advance-genai-security/ · Current platform ↗https://www.sentinelone.com/platform/securing-ai-prompt/
HiddenLayer
- Propiedad / organización
- HiddenLayer
- Punto de control
- Cadena de IA · simulación · ejecución
HiddenLayer separa análisis de cadena de suministro, simulación y protección en producción; anunció seguridad de harnesses de agentes de código mediante hooks nativos en agosto de 2026. Su especialización encaja con modelos sensibles y entornos heterogéneos. La ventaja hipotética combina investigación adversarial e integración en publicación. Valídela con formatos soportados, ataques, falsos positivos y evasiones. Las afirmaciones sin agente o sin datos de entrenamiento se interpretan por módulo, no como ausencia universal de instrumentación. Analizar un artefacto no prueba datos de entrenamiento limpios ni autorización de cada acción posterior.
Platform modules ↗https://www.hiddenlayer.com/platform · Agent harness announcement ↗https://www.hiddenlayer.com/newsroom
Noma Security
- Propiedad / organización
- Noma Security
- Punto de control
- Postura de IA · acceso · sesión
Noma combina AI-SPM, control de acceso, respuesta en ejecución y red teaming. Describe contexto de sesión, identidad, datos y línea base, con monitorización, alertas, bloqueo o enmascarado mediante gateways y hooks existentes. La diferenciación hipotética detecta secuencias peligrosas de llamadas aparentemente normales. CISO y plataforma deben desplegar juntos. Verifique identidad entre subagentes, eventos perdidos, concurrencia y efectos diferidos. Un guardrail en lenguaje natural no es una política de autorización verificada. La puntuación de comportamiento aporta evidencia, pero tenant, recursos y presupuesto necesitan una fuente autorizada.
Platform control layers ↗https://noma.security/platform · Runtime enforcement and context ↗https://noma.security/platform/runtime-protection/
Upwind
- Propiedad / organización
- Upwind
- Punto de control
- Cargas cloud · contexto · sensores de IA
Upwind relaciona postura cloud, telemetría y actividad de IA, y analiza instrucciones y skills. Entra por la infraestructura donde la acción del agente se vuelve real: procesos, credenciales, almacenes y salida de datos. Encaja con compradores cloud-native que necesitan priorizar remediación. Separe IA que investiga amenazas de controles que protegen la IA del cliente. Sensores y alternativas sin agente difieren. Pregunte qué se bloquea antes de ejecutar, cómo llega la intención semántica a la política y qué remediaciones requieren aprobación humana. Visibilidad runtime no equivale a autorización de negocio.
Cloud and AI runtime architecture ↗https://www.upwind.io/feed/upwind-ai-security-securing-your-ai-stack-from-the-inside-out · Agent context scanning ↗https://www.upwind.io/feed/announcing-the-upwind-ai-context-scanner-securing-ai-agents-instructions-skills-and-model-context
Microsoft / Entra, Defender, Purview
- Propiedad / organización
- Microsoft
- Punto de control
- Identidad · gobierno de datos · agentes
Entra Agent ID aporta identidades; la seguridad de Agent 365 conecta Entra, Defender y Purview, y este último trata protección de datos y cumplimiento. Microsoft parte de empleados, documentos y administración ya instalados: distribución y contexto son sus activos estratégicos. Esto presiona inventarios o políticas básicas independientes. Pero registrar una identidad no prueba que cada herramienta la use. Verifique licencias, plataformas, permisos delegados frente a los de aplicación, revocación, acceso entre tenants y acciones externas. El entorno Microsoft existente ayuda a integrar, no demuestra que un interruptor proteja todos los flujos autónomos.
Agent identities ↗https://learn.microsoft.com/en-us/entra/agent-id/what-are-agent-identities · Agent 365 security architecture ↗https://learn.microsoft.com/en-us/security/security-for-ai/agent-365-security · Agent data governance ↗https://learn.microsoft.com/en-us/purview/ai-agents
Google Cloud / Model Armor, Wiz
- Propiedad / organización
- Punto de control
- Ruta de contenido · contexto cloud
Model Armor examina prompts, respuestas y documentos ante inyección y datos sensibles. Distingue inspección sin bloqueo de integraciones de aplicación, incluidas rutas MCP de Google Cloud. Wiz, adquirido en marzo de 2026, añade contexto cloud, no autorización universal de agentes. Google puede adjuntar controles a compras de IA e infraestructura gestionadas. Verifique región e idioma: la documentación indica detección omitida para ciertos controles no ingleses en algunas regiones. Registrar un hallazgo no es bloquearlo; IAM de recursos, aislamiento de tenants y aprobación exacta del negocio siguen siendo responsabilidades separadas.
Model Armor deployment modes ↗https://docs.cloud.google.com/model-armor/overview · Language and regional detection boundaries ↗https://docs.cloud.google.com/model-armor/sanitize-prompts-responses · Wiz acquisition completed ↗https://blog.google/innovation-and-ai/infrastructure-and-cloud/google-cloud/wiz-acquisition/
AWS / Bedrock AgentCore
- Propiedad / organización
- AWS
- Punto de control
- Pasarela de herramientas · autorización
AgentCore Policy usa Cedar para autorización granular de herramientas y recursos, con condiciones de identidad y parámetros. Su posición está cerca de la ejecución y complementa, no sustituye, detección probabilística. Encaja con equipos AWS o que enrutan herramientas por AgentCore Gateway. Reutilizar identidades y operación cloud puede aportar ventaja económica. Pero la autoridad del motor depende de sus entradas: no corrige identidades inventadas por el modelo, gateways eludidos o controles de tenant ausentes. Presupuestos con estado, idempotencia, aprobación y efectos externos inciertos siguen necesitando diseño de aplicación.
Policy control boundary ↗https://docs.aws.amazon.com/bedrock-agentcore/latest/devguide/policy.html · Cedar design rationale ↗https://aws.amazon.com/blogs/security/why-policy-in-amazon-bedrock-agentcore-chose-cedar-for-securing-agentic-workflows/
Seguir un ataque en el flujo de facturas
Un PDF del proveedor pide al agente sustituir la cuenta beneficiaria. Las ACL de recuperación deciden si el empleado puede leer el documento, no si sus instrucciones son fiables. Un filtro puede señalar la inyección; identidad y pasarela limitan las herramientas delegadas. El servicio de pago debe vincular por separado la aprobación a tenant, beneficiario, importe, moneda y versión de factura, evitando efectos duplicados. Sensores de endpoint/nube detectan procesos o salidas inesperadas; auditoría relaciona decisiones con resultados confirmados. Si falla el detector, otras fronteras deben contener el daño. Detectar el texto no basta si el backend acepta aprobaciones falsificadas.
Detalle técnico: separar decisión y aplicación
El punto de decisión de políticas (PDP) evalúa identidad, tenant, acción, recurso y estado confiables. El punto de aplicación (PEP) intercepta la operación y aplica esa decisión. Todas las rutas hacia el efecto protegido deben atravesarlo, incluidos reintentos y trabajos en segundo plano. Un clasificador aporta una señal de riesgo, pero no crea identidades ni permisos. Identidad, filtro de contenido y gateway pueden complementarse sin sustituirse.
Un permiso puede quedar obsoleto antes de ejecutarse. Vincule la aprobación a la acción exacta y a la versión del recurso; use escrituras condicionales o transacciones cuando existan. Si falla una dependencia de autorización, las acciones sensibles deben denegarse o aplazarse según una política explícita, no delegarse al modelo. El gateway no garantiza atomicidad dentro de otro servicio. Importa quién asume esas brechas de integración.
Compra hipotética: medir también la interrupción
Supongamos un millón de tareas mensuales, cien maliciosas. Con detección del 90% y falsos positivos del 0,1% sobre tareas benignas, aparecen 90 alertas maliciosas y unas 1.000 benignas: aproximadamente el 8,3% son verdaderas. A cinco minutos por revisión, son unas 91 horas de analista antes de atender incidentes. Son entradas didácticas inventadas, no un benchmark. El producto puede merecer la compra, pero deben incluirse pérdida esperada, trabajo legítimo bloqueado, cobertura, latencia, revisión y contención. Comparar porcentajes de detección sin tasas base ni umbrales oculta la economía.
Dónde quedan oportunidades defendibles
Persisten problemas difíciles: interceptar agentes locales y remotos, mantener identidad en delegaciones, revocar durante tareas largas, presupuestos atómicos, idempotencia y conciliación de efectos inciertos. Intención en múltiples turnos, memoria contaminada y procedencia de resultados superan la clasificación de un prompt. Un nuevo actor creíble debe elegir un fallo acotado y costoso, identificar quién aplica el control y demostrar reducción con tráfico benigno realista. Exija evidencia ante pérdida de telemetría, idiomas no admitidos, hooks eludidos, caídas de política y recuperación. La unidad competitiva es un flujo gobernado con fiabilidad, no un contador de análisis. Es una hipótesis, no una predicción de ganadores.
Adquisiciones, capital e implicaciones estratégicas
Consolidación: acuerdo no equivale a cierre
Protect AI se incorporó a Palo Alto Networks el 22 de julio de 2025; Pangea a CrowdStrike el 26 de septiembre; Prompt Security a SentinelOne el 5 de septiembre; Lakera a Check Point el 22 de octubre. Son operaciones cerradas, no competidores independientes. En 2026 Palo Alto cerró Portkey el 29 de mayo, tras anunciar la intención el 30 de abril. Cisco completó Galileo el 22 de mayo y Astrix el 29 de junio; Google completó Wiz el 11 de marzo. Las fechas prueban propiedad, no integración total. La tesis combina distribución, identidad, telemetría y control; todavía debe demostrarse la calidad de integración.
Capital no equivale a ventaja defendible
Las empresas anunciaron $100M de serie B para HiddenLayer el 2 de septiembre de 2026, $100M de serie B para Noma el 31 de julio de 2025 y $400M de serie C para Upwind el 28 de octubre de 2026. Es financiación, no ingresos ni cuota de mercado. Los especialistas necesitan justificar pago adicional frente a controles incluidos: integraciones difíciles, investigación adversarial, aplicación fiable entre entornos o dominio del flujo operativo. Las grandes plataformas tienen contratación y telemetría instaladas, pero pueden conservar huecos entre identidad, estado de aplicación y efectos remotos. Ni financiación ni adquisición resuelven por sí solas esa ejecución.
Fuentes primarias de productos y transacciones
- Protect AI acquisition completed ↗https://investors.paloaltonetworks.com/news-releases/news-release-details/palo-alto-networks-completes-acquisition-protect-ai ·
- Pangea acquisition closing disclosed in annual filing ↗https://www.sec.gov/Archives/edgar/data/1535527/000153552726000010/crwd-20260131.htm ·
- Prompt Security transaction completed ↗https://www.sec.gov/Archives/edgar/data/1583708/000110465925088079/tm2525181d1_8k.htm ·
- Lakera acquisition accounting disclosure ↗https://www.sec.gov/Archives/edgar/data/1015922/000117891326001932/R11.htm ·
- Portkey acquisition completed ↗https://investors.paloaltonetworks.com/news-releases/news-release-details/palo-alto-networks-completes-acquisition-portkey-secure-ai ·
- Astrix acquisition: completed update ↗https://blogs.cisco.com/news/cisco-announces-intent-to-acquire-astrix-security ·
- Galileo acquisition completed ↗https://www.cisco.com/site/us/en/about/corporate-development/acquisitions/galileo/index.html ·
- Google completes Wiz acquisition ↗https://blog.google/innovation-and-ai/infrastructure-and-cloud/google-cloud/wiz-acquisition/ ·
- HiddenLayer Series B announcement ↗https://www.hiddenlayer.com/news/hiddenlayer-100m-series-b-ai-security ·
- Noma Series B announcement ↗https://noma.security/blog/noma-security-raises-100m-to-drive-adoption-of-ai-agent-security ·
- Upwind Series C announcement ↗https://www.upwind.io/blog/the-next-wave-is-here-upwinds-400m-series-c-to-build-the-cloud-ai-security-platform ·
- Prisma AIRS documentation ↗https://docs.paloaltonetworks.com/prisma-airs/getting-started/prisma-airs-overview ·
- FY2026 acquisition disclosures ↗https://www.sec.gov/Archives/edgar/data/1327567/000132756726000023/panw-20260731.htm ·
- AI Defense capabilities ↗https://www.cisco.com/site/us/en/products/security/ai-defense/index.html ·
- AI Guard API behavior ↗https://pangea.cloud/docs/ai-guard/overview ·
- AI detection and response ↗https://www.crowdstrike.com/en-us/solutions/ai-detection-and-response/ ·
- Falcon Guardian announcement ↗https://www.crowdstrike.com/en-us/press-releases/crowdstrike-unveils-falcon-guardian-ai-agent-security/ ·
- Agent Security scope and early-access status ↗https://docs.lakera.ai/docs/agent-security ·
- Prompt Security acquisition rationale and capabilities ↗https://www.sentinelone.com/press/sentinelone-to-acquire-prompt-security-to-advance-genai-security/ ·
- Current platform ↗https://www.sentinelone.com/platform/securing-ai-prompt/ ·
- Platform modules ↗https://www.hiddenlayer.com/platform ·
- Agent harness announcement ↗https://www.hiddenlayer.com/newsroom ·
- Platform control layers ↗https://noma.security/platform ·
- Runtime enforcement and context ↗https://noma.security/platform/runtime-protection/ ·
- Cloud and AI runtime architecture ↗https://www.upwind.io/feed/upwind-ai-security-securing-your-ai-stack-from-the-inside-out ·
- Agent context scanning ↗https://www.upwind.io/feed/announcing-the-upwind-ai-context-scanner-securing-ai-agents-instructions-skills-and-model-context ·
- Agent identities ↗https://learn.microsoft.com/en-us/entra/agent-id/what-are-agent-identities ·
- Agent 365 security architecture ↗https://learn.microsoft.com/en-us/security/security-for-ai/agent-365-security ·
- Agent data governance ↗https://learn.microsoft.com/en-us/purview/ai-agents ·
- Model Armor deployment modes ↗https://docs.cloud.google.com/model-armor/overview ·
- Language and regional detection boundaries ↗https://docs.cloud.google.com/model-armor/sanitize-prompts-responses ·
- Policy control boundary ↗https://docs.aws.amazon.com/bedrock-agentcore/latest/devguide/policy.html ·
- Cedar design rationale ↗https://aws.amazon.com/blogs/security/why-policy-in-amazon-bedrock-agentcore-chose-cedar-for-securing-agentic-workflows/ ·
Source and maintenance notes
Primary links are placed beside the claims they support. Acquisition amounts retain their original basis; undisclosed values remain undisclosed. Product specifications and release statements are vendor disclosures, not comparative evidence from Token Lab. The diagrams and reference calculations are original educational material. Corrections should identify the section, source and proposed replacement; a source-access date is not a paper publication date.
All frontier research · Top Company Frontier · Editorial standards
Práctica y verificación
14 · Validar ataques y utilidad conjuntamente
Crea un entorno local sintético con dos inquilinos, herramientas mock y registro de pagos falso. Mantén el flujo legítimo y cambia una frontera cada vez: recuperación, credenciales, aprobación, egreso o auditoría. Define entrada atacante, efecto prohibido, punto de aplicación y resultado legítimo requerido.
Puntúa efectos: lectura, divulgación o cambio no autorizado, no palabras alarmantes. Informa utilidad, falsas denegaciones, latencia y coste, indicando si el denominador son intentos, tareas, payloads o sesiones. Cero fallos en una colección pequeña no demuestra riesgo cero; variantes correlacionadas no son observaciones independientes.
Añade controles negativos: instrucciones citadas legítimamente, reintentos, cambios de cuenta aprobados y enlaces normales. Permite feedback limitado en pruebas adaptativas pero reserva un conjunto fuera del desarrollo. Iguala presupuestos; diez jueces caros frente a una comprobación barata no aíslan una mejora algorítmica.
Investiga políticas comprensibles al componer herramientas, procedencia conservada sin retención excesiva y auditoría que distinga relatos plausibles de intervenciones eficaces. Compara con una base determinista y publica fallos. El objetivo es un argumento de seguridad de todo el ciclo, no una garantía universal.
Práctica: explicar la arquitectura, no solo los términos
Estas preguntas son originales, no preguntas reales atribuidas a empresas. Antes de abrir cada respuesta, dibuja el límite de confianza e identifica el componente que lo impone.
El modelo rechaza la instrucción inyectada en un PDF. ¿Es seguro el flujo de pagos?
Pista: Identifica qué componente puede ejecutar realmente un pago.
Mostrar respuesta y análisis
No basta. El rechazo es una conducta observada: inspecciona la autorización determinista, la vinculación de la aprobación y las credenciales de la herramienta. Envía una propuesta adversaria al mismo control y verifica que no produce un efecto prohibido en el libro mayor. Comprueba también la operación legítima; un rechazo no garantiza seguridad general.
¿En qué se diferencian una clave de API del modelo y un token delegado del usuario?
Pista: Separa el acceso a inferencia de la autoridad sobre recursos empresariales.
Mostrar respuesta y análisis
La clave permite invocar inferencia; la delegación restringe actor, destinatario, alcance y vigencia de operaciones empresariales. Ninguna debe aparecer en el contexto del modelo. Valida destinatario, autorización por objeto y caducidad: una clave de inferencia no concede autoridad empresarial.
Se aprueban 100 dólares para el proveedor A, pero cambia su cuenta antes de ejecutar. ¿Qué haces?
Pista: Compara la acción aprobada con la versión actual del recurso.
Mostrar respuesta y análisis
Rechaza o solicita nueva aprobación según la política. Vincula la aprobación a campos canónicos y versiones relevantes y compruébalos atómicamente al ejecutar. Una comprobación seguida de una escritura desprotegida permite una carrera.
La herramienta agota el tiempo tras solicitar un pago. ¿Puede reintentar el agente?
Pista: Un timeout no demuestra que el pago no ocurrió.
Mostrar respuesta y análisis
Usa un identificador estable y una clave de idempotencia, y reconcilia con registros autoritativos. Reintenta la misma solicitud vinculada solo si el servidor garantiza esa semántica; de lo contrario conserva el estado desconocido y escala. Una clave nueva puede duplicar el pago.
Un recibo firmado afirma que el pago terminó. ¿Qué demuestra?
Pista: Distingue integridad, autorización y verdad empresarial.
Mostrar respuesta y análisis
Bajo los supuestos de confianza de la clave, demuestra que quien la controla emitió esos bytes. No demuestra por sí solo exhaustividad, autorización correcta ni liquidación. Relaciona decisión de política, aprobación y libro mayor independiente; trata la evidencia ausente o contradictoria.
Rúbrica: 1 punto identifica el riesgo; 2 define el límite; 3 identifica quién comprueba identidad, acción y recurso; 4 verifica efectos reales con casos positivos y negativos; 5 aborda concurrencia, revocación, evidencia incompleta y riesgo residual.
Proyecto final: construye un simulador local de facturas para dos tenants con aprobación exacta, documento inyectado, timeout y auditoría reconstruible. Demuestra prevención y finalización legítima, y documenta las diferencias respecto a producción.
Práctica: comprobar cada frontera
Ejecuta casos sintéticos sobre el mismo flujo legítimo. Inspecciona estado y auditoría, no solo texto.
Identidad: IDs iguales entre inquilinos, membresía revocada y campos alterados no cruzan alcance.
Modelo y cadena: compara revisiones limpias y sospechosas; rechaza salidas malformadas, enormes o herramientas no registradas y gestiona timeouts.
Recuperación: la inyección no concede autoridad y documentos legítimos con instrucciones citadas siguen siendo útiles.
Delegación: deniega audiencia incorrecta, scopes ausentes, caducidad y escalada del hijo.
Aprobación: modifica un centavo, moneda, destino o revisión; caduca o revoca. Ningún efecto no autorizado se confirma.
Ejecución: bloquea destinos y rutas prohibidos, limita agotamiento y conserva adjuntos legítimos.
Reintentos: duplicados, respuestas perdidas y reinicios se concilian con el registro sin duplicar efectos.
Memoria: comprueba fugas entre inquilinos, inyección en resúmenes y derivados tras borrar fuentes.
Auditoría: eventos ausentes, IDs inconsistentes, resultados falsos y caída del registro activan el comportamiento declarado.
Informa prevención y utilidad, confianza residual en identidad, límites de concurrencia y conciliación humana; no prometas atomicidad global.
Run the authority boundary, not just a prompt
The model can propose an Action. The application supplies the trusted Grant, approval record, clock and stable operation key. This simulator checks their relationship before a ledger write. It also rejects a second payment under a different retry key. All records are synthetic and in memory; there is no network, credential or payment service.
Python 3.10+, standard library, deterministic: download agent-authority.py.
python3 agent-authority.py"""Offline policy-and-receipt simulator, Python 3.10+, standard library only.
Not production IAM, a payment API, or a cryptographic audit implementation.
The caller is trusted test code. Untrusted model output supplies Action only.
"""
from dataclasses import dataclass, replace
from hashlib import sha256
import json
@dataclass(frozen=True)
class Action:
tenant: str
invoice: str
revision: int
payee: str
cents: int
operation: str = 'pay'
@dataclass(frozen=True)
class Grant:
user: str
tenant: str
audience: str
invoice: str
max_cents: int
expires: int
revision: int
def digest(action):
return sha256(json.dumps(action.__dict__, sort_keys=True,
separators=(',', ':')).encode()).hexdigest()
class Ledger:
def __init__(self):
self.commits = {} # durable and transactional in a real implementation
self.events = []
self.revoked = set()
self.audit_available = True
self.invoice_revision = 4
def execute(self, action, grant, approval, key, now):
"""approval is a trusted approval-service record, not model text.
Single-threaded transaction simulation; no exactly-once network claim.
"""
reason = None
if grant.user in self.revoked: reason = 'revoked'
elif now >= grant.expires: reason = 'expired'
elif grant.audience != 'ledger': reason = 'audience'
elif action.tenant != grant.tenant: reason = 'tenant'
elif action.invoice != grant.invoice: reason = 'resource'
elif action.operation != 'pay': reason = 'operation'
elif type(action.cents) is not int or not 0 < action.cents <= grant.max_cents: reason = 'amount'
elif action.revision != self.invoice_revision or grant.revision != self.invoice_revision: reason = 'stale_revision'
elif approval != digest(action): reason = 'approval_binding'
elif not self.audit_available: reason = 'audit_unavailable'
elif key in self.commits:
if self.commits[key]['digest'] != digest(action): reason = 'idempotency_conflict'
else: return self.commits[key] # same receipt, no second write
if reason is None and any(r['invoice'] == action.invoice and r['tenant'] == action.tenant for r in self.commits.values()):
reason = 'already_settled'
if reason:
self.events.append({'state': 'denied', 'reason': reason})
return {'state': 'denied', 'reason': reason}
receipt = {'state': 'committed', 'digest': digest(action), 'key': key,
'actor': grant.user, 'tenant': grant.tenant,
'invoice': action.invoice, 'revision': action.revision, 'policy': 'teaching-v1'}
# In production: commit effect and durable audit/outbox atomically,
# or use downstream idempotency + reconciliation; this is in-memory.
self.commits[key] = receipt
self.events.append(dict(receipt))
return receipt
action = Action('tenant-a', 'inv-7', 4, 'supplier-42', 5000)
grant = Grant('user-1', 'tenant-a', 'ledger', 'inv-7', 10000, 100, 4)
approval = digest(action)
ledger = Ledger()
assert ledger.execute(action, grant, approval, 'op-1', 50)['state'] == 'committed'
assert ledger.execute(action, grant, approval, 'op-1', 51)['state'] == 'committed'
assert len(ledger.commits) == 1
assert ledger.execute(action, grant, approval, 'different-key', 51)['reason'] == 'already_settled'
assert ledger.execute(replace(action, tenant='tenant-b'), grant, approval, 'op-2', 50)['reason'] == 'tenant'
assert ledger.execute(replace(action, payee='attacker'), grant, approval, 'op-2', 50)['reason'] == 'approval_binding'
assert ledger.execute(replace(action, cents=10001), grant, approval, 'op-2', 50)['reason'] == 'amount'
assert ledger.execute(action, replace(grant, audience='search'), approval, 'op-2', 50)['reason'] == 'audience'
assert ledger.execute(action, grant, approval, 'op-2', 100)['reason'] == 'expired'
ledger.invoice_revision = 5
assert ledger.execute(action, grant, approval, 'op-2', 50)['reason'] == 'stale_revision'
ledger.invoice_revision = 4
ledger.audit_available = False
assert ledger.execute(action, grant, approval, 'op-2', 50)['reason'] == 'audit_unavailable'
ledger.audit_available = True
ledger.revoked.add('user-1')
assert ledger.execute(action, grant, approval, 'op-2', 50)['reason'] == 'revoked'
assert len(ledger.commits) == 1
print('13 checks passed: approval, tenant, audience, budget, revision, expiry, audit, revocation and replay.')
print('One committed effect. Model-proposed changes cannot expand the trusted grant.')
13 checks passed: approval, tenant, audience, budget, revision, expiry, audit, revocation and replay.
One committed effect. Model-proposed changes cannot expand the trusted grant.
Production gaps: a digest is not a signature. Real approval records need authenticated issuance, approver authority, expiry and replay controls. Validate tokens cryptographically; use a transactional database, concurrency controls, authoritative invoice state, downstream idempotency and reconciliation. This single-threaded example does not prove exactly-once delivery or tamper-proof audit storage.
6. Data that actually tells us something
AgentDojo provides a concrete research substrate: 97 tasks and 629 security test cases involving tool-using agents. The original arXiv submission was June 19, 2024; this survey pins v3, November 24, 2024, whose revision notes include an implementation bug fix and travel-suite changes. Paper abstracthttps://arxiv.org/abs/2406.13352v3 · PDFhttps://arxiv.org/pdf/2406.13352v3 · Author codehttps://github.com/ethz-spylab/agentdojo. Those counts describe a benchmark, not the prevalence of attacks in customer deployments.
Three distinct quantities are needed. Clean utility measures completion without attack. Attack success measures a defined attacker objective under a specified opportunity and budget. Defended utility measures legitimate completion with the defense present. Report all three. An agent that cannot complete a banking task in the clean condition may also fail to execute the injected action; that is not necessarily a successful defense.
Denominators must be explicit. Was success counted per attack attempt, per task, or after the adversary tried many candidates and selected the best? Did the attacker see the defense or query its feedback? Was tool execution inspected, or only the final natural-language answer? A refusal message can accompany an earlier unauthorized tool call. A screenshot of a safe-looking answer is weak evidence about the full trajectory.
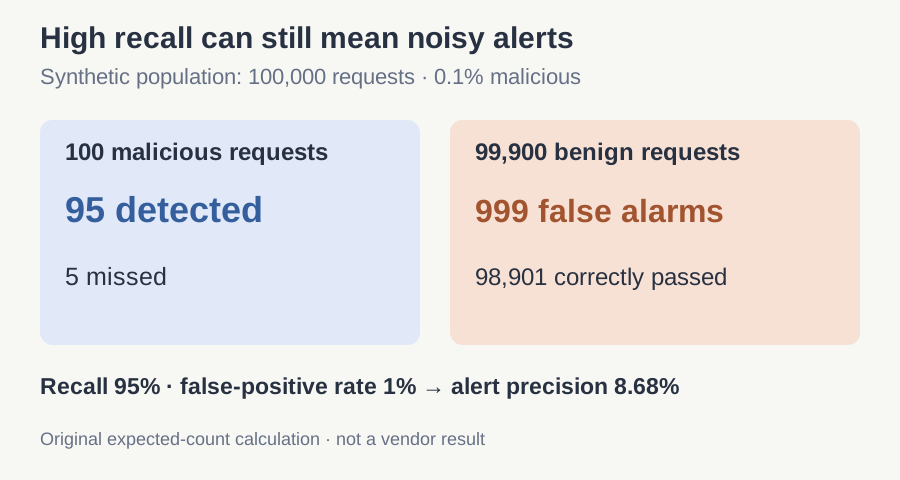
Assume 100,000 requests, an attack prevalence of 0.1%, a true-positive rate of 95%, and a false-positive rate of 1%. Expected counts are 95 true alerts, 999 false alerts and five missed attacks. Only 8.68% of alerts correspond to malicious requests. A seemingly small false-positive rate can overwhelm operations when attacks are rare.
Here π is attack prevalence, r is true-positive rate and f is false-positive rate. These are probabilities, not percentages entered as whole numbers. The formula follows by dividing expected true positives by all expected positive predictions. It does not imply that deployment prevalence is known or that adaptive attacks remain distributed like test samples.
Local false-alarm experiment
95 true alerts; 999.0 false alerts; alert precision 8.68%.
Population, prevalence and recall stay fixed at the stated teaching assumptions. No inputs leave your browser.
Download security-base-rate.py. Python 3.10+, standard library only; deterministic arithmetic, no random seed, network requests or model API. Run python3 security-base-rate.py.
"""Expected counts in a synthetic population, not vendor performance."""
from math import isclose


def audit(n, prevalence, tpr, fpr):
    if not isinstance(n, int) or isinstance(n, bool) or n <= 0:
        raise ValueError('n must be a positive integer')
    if not all(0 <= x <= 1 for x in (prevalence, tpr, fpr)):
        raise ValueError('Rates must be in [0, 1]')
    tp = n * prevalence * tpr
    fn = n * prevalence * (1 - tpr)
    fp = n * (1 - prevalence) * fpr
    tn = n * (1 - prevalence) * (1 - fpr)
    precision = tp / (tp + fp) if tp + fp else None
    return tp, fp, fn, tn, precision


if __name__ == '__main__':
    tp, fp, fn, tn, precision = audit(100000, .001, .95, .01)
    assert isclose(tp, 95)
    assert isclose(fp, 999)
    assert isclose(fn, 5)
    assert isclose(tp + fp + fn + tn, 100000)
    assert isclose(precision, 95/1094)
    assert audit(100, 0, 1, 0)[4] is None
    assert audit(100, 1, 1, 0)[4] == 1
    try:
        audit(100, -.1, .95, .01)
    except ValueError:
        pass
    else:
        raise AssertionError('Invalid rate accepted')
    print(f'TP={tp:.0f}, FP={fp:.0f}, FN={fn:.0f}, TN={tn:.0f}')
    print(f'Alert precision={100*precision:.2f}%')
    print('8 checks passed')
Expected output:
TP=95, FP=999, FN=5, TN=98901
Alert precision=8.68%
8 checks passed
Before reducing f to 0.1%, predict the outcome: false alerts become 99.9 and precision approximately 48.74% if recall is unchanged. In a real detector, changing the threshold generally changes recall too. The calculator isolates the arithmetic; it is not a threshold-tuning algorithm. A missed low-impact test attack and an unauthorized high-value transaction also have different costs.
7. Build a fair security evaluation
Start with a workflow inventory and concrete forbidden outcomes: sending data to a non-owner, accessing another tenant's record, running an unapproved command, or changing an authorization policy. Define the adversary's entry point and budget. A user who directly owns the account and a third party controlling one retrieved page are different adversaries; do not mix their results.
Maintain a clean task set with validated expected outcomes. Create attack families on separate development fixtures and freeze a held-out set before tuning. Include benign text that resembles an attack, multiple languages, long contexts, interrupted tool sequences and malicious content that appears only after an initial harmless step. Track software and policy versions so that a changed score can be attributed to an intervention.
Use four baselines: the original agent; a detector-only variant; a deterministic tool-policy gate; and their combination. Keep model, tools, tasks, allowed scopes and attack budgets fixed. Measure forbidden actions, clean success, defended success, false blocks, latency, cost and coverage of action paths. An ablation must not give one system fewer privileges or easier tasks without acknowledging the change.
Inspect complete traces. Validate tool arguments and actual side effects, not the model's description of them. Verify that denied actions did not execute, then verify that permitted actions still complete. Include timeouts, retries, expired approvals and revocation during a multi-step run. An observer that alerts after a transfer is a detective control; it is not preventive enforcement.
Repeat stochastic model runs and report uncertainty. Group results by task family to expose correlated failures. Repeated attempts against one template do not supply the same evidence as independent families. For zero observed violations, use a confidence bound with explicit assumptions; see the alignment evidence tutorial. Never turn 0/n into a promise of zero future risk.
8. Original interview practice and engineering decisions
These are original simulations, not verified questions from the companies discussed. Answer with a threat model and an observable test, not a list of product names.
1. Why can 95% attack recall still create an unusable alert queue?
First hint: Use prevalence and the benign population as well as recall.
Answer and analysis
At 0.1% prevalence in 100000 requests, there are 100 malicious and 99900 benign cases. A 1% false-positive rate creates 999 false alerts, exceeding 95 true alerts. Discuss triage cost, threshold trade-offs and the uncertainty of the prevalence estimate.
Score yourself: 1/5 names the concept; 2/5 defines it; 3/5 derives the relevant mechanism or calculation; 4/5 tests a counterexample; 5/5 states assumptions, trade-offs and an evaluation that could disprove the answer.
2. Why does an ethical explanation not authorize a tool call?
First hint: Separate behavior prediction from authoritative permission.
Answer and analysis
An explanation is generated content. A policy service should resolve identity, resource scope, recipient and approval from authoritative state. Test a persuasive proposal with an out-of-scope recipient and prove that the executor denies it before any side effect.
Score yourself: 1/5 names the concept; 2/5 defines it; 3/5 derives the relevant mechanism or calculation; 4/5 tests a counterexample; 5/5 states assumptions, trade-offs and an evaluation that could disprove the answer.
3. How could a defense achieve zero attack success while being useless?
First hint: Inspect clean task completion.
Answer and analysis
Refusing everything, disabling every tool, or failing the workflow can prevent attacker objectives while also preventing authorized work. Report utility and attack success together, plus the exact permissions and denominators.
Score yourself: 1/5 names the concept; 2/5 defines it; 3/5 derives the relevant mechanism or calculation; 4/5 tests a counterexample; 5/5 states assumptions, trade-offs and an evaluation that could disprove the answer.
4. What changes when an agent can write memory or improve its own prompt?
First hint: Think across runs, not only within one request.
Answer and analysis
Poisoned state can persist after the original input disappears. Version memory and prompts, restrict writes and evaluate candidates on untouched tasks with an independent gate. Test rollback and ensure the candidate cannot alter evaluation evidence.
Score yourself: 1/5 names the concept; 2/5 defines it; 3/5 derives the relevant mechanism or calculation; 4/5 tests a counterexample; 5/5 states assumptions, trade-offs and an evaluation that could disprove the answer.
For an engineer, a strong first project is a small controlled executor with auditable permissions and adversarial fixtures. For a researcher, the next step is a task family that exposes a specific failure in existing defenses without redefining success after seeing results. Continue with bounded tools, authorization after learning and the infrastructure companion.
9. Frontier research agenda: five falsifiable projects
The following are Token Lab's proposed research directions, not claims that these methods have already succeeded or are novel. Search the literature before claiming novelty. Each proposal starts with an engineering failure and ends with evidence that would count against the idea. Select one narrow workload for a first PoC; broad claims require replication across tasks, implementations and operating conditions.
1. Semantic authorization beyond a tool allowlist
Why existing approaches are insufficient: An API can be allowed while a particular recipient, amount or purpose is not. Natural-language requests often underspecify the legitimate scope, and agents revise plans as they work.
Testable hypothesis: A typed action proposal bound to resource-level policy and explicit approvals reduces unauthorized effects without excessive false blocks.
Baselines and fair comparison: Compare prompt-only restrictions, tool-name allowlists and resource-scoped enforcement. Use tasks with the same tool but different ownership and destinations.
Measurements: Measure actual unauthorized effects, authorized completion, approval burden and policy coverage. Mutate parameters after approval and test revocation between planning and execution.
What would falsify the claim: Reject if the evaluator accepts self-reported authorization or if benign success collapses. A typed schema checks structure; it does not by itself prove that the values are permitted.
2. Adaptive prompt injection under a fixed attack budget
Why existing approaches are insufficient: A defense tuned to a static phrase collection can learn surface patterns. An attacker can observe failures, alter content and exploit a different point in the workflow.
Testable hypothesis: Training or detection informed by provenance and task boundaries generalizes better than phrase matching at matched clean utility.
Baselines and fair comparison: Compare a phrase baseline, a model detector and an execution gate, with separate adaptive attack runs against each. Match query and token budgets.
Measurements: Report success per attempt and per task after the full budget, clean utility, attack cost and failures on unseen task families. Preserve all attempted attacks, not only successful examples.
What would falsify the claim: Reject if improvement disappears when attackers adapt, or if one defense gets less attack effort. Do not report a fixed-template score as a guarantee against strategic adversaries.
3. Long-horizon memory poisoning and recovery
Why existing approaches are insufficient: A single harmless-looking note can influence later decisions after the original document is gone. Most short episodes miss persistence, delayed triggers and the cost of removing contaminated state.
Testable hypothesis: Provenance-aware memory writes with quarantine and selective rollback can reduce persistent influence while retaining useful learned preferences.
Baselines and fair comparison: Compare no persistent memory, unrestricted memory and the proposed write policy. Use multi-session legitimate tasks interleaved with controlled contamination fixtures.
Measurements: Measure delayed violations, useful retention, time to detect, rollback completeness and collateral forgetting. Inspect every downstream copy of the tainted state.
What would falsify the claim: Reject if the defense succeeds only by deleting all memory or assumes a known infection time. Recovery must address derived summaries and replicas, not only the original record.
4. Multimodal and multilingual boundary preservation
Why existing approaches are insufficient: A security decision made on extracted text may not cover instructions encoded in an image, an audio segment or layout. Translation and OCR change what the model sees.
Testable hypothesis: Tracking provenance through preprocessing and testing modality-specific transformations improves coverage at matched utility.
Baselines and fair comparison: Compare a text-only detector, independent modality filters and the proposed end-to-end pipeline on paired inputs expressing the same authorized task.
Measurements: Report results by language and modality, extraction errors, false blocks, task quality and latency. Include benign ambiguous layouts and low-quality scans.
What would falsify the claim: Reject if a global average hides failure in one language, or if the defense gets access to a clean transcription unavailable in production. Human labels need agreement checks too.
5. Security evaluation for self-improving agents
Why existing approaches are insufficient: When candidates alter prompts, tools or code, the evaluator and reward become attractive targets. Passing more tests may mean learning the tests rather than improving robust capability.
Testable hypothesis: An isolated promotion gate with held-out task families and immutable execution receipts can detect more invalid improvements than an in-loop score alone.
Baselines and fair comparison: Compare self-scoring, a shared-state evaluator and an independent evaluator. Introduce benign improvements, reward exploits and unauthorized tool-scope changes as distinct candidate types.
Measurements: Measure legitimate gain, exploit acceptance, retained abilities, scope changes and audit reproducibility. Keep a final test set untouched until selection finishes.
What would falsify the claim: Reject if the candidate can edit the score, if test contamination is ignored, or if safety comes only from forbidding all changes. A useful gate must accept genuine improvements as well as reject exploits.
From a two-week PoC to a defensible report
In the first stage, write the system boundary, assumptions and failure criterion before implementing the proposed method. Build the simplest baseline and a reproducible fixture. In the second stage, add one intervention and run controlled sweeps; retain failed runs and explain exclusions. In the final stage, test an unseen workload or attack family and write a limitations section. Separate what your experiment measured from what you hope will generalize.
A useful report contains a configuration manifest, data-generation procedure, code commit, exact commands, raw observations, aggregation script and a table of threats to validity. Use multiple seeds when randomness matters; repeated deterministic arithmetic is not independent evidence. Publish negative results: the boundary where a technique stops working is often the most transferable lesson.