Jev y el harness de agentes: decisiones, contexto, coste y control
Análisis técnico del modelo de decisiones y del PDF viral, con arquitectura propia, cálculos y un harness local reproducible.
Fuentes y versiones
En este artículo
Qué cambia Jev y qué conserva el software
Un agente de programación es un programa con estado que alterna inferencia y acciones. El harness construye contexto, presenta herramientas, limita recursos y registra resultados. El modelo propone un parche; el runtime decide qué versión del repositorio ve y qué puede ejecutar.
Jev es un modelo de decisiones de TypeSafe, no un generador de código sustituto. Devuelve juicios tipados a partir del estado [1]. Seguiremos un agente SRE que corrige la amplificación de reintentos de un cliente HTTP: el generador modifica código y el decisor ayuda a seleccionar evidencia. Autenticación, permisos y ejecución siguen siendo responsabilidades del software.
El objetivo es calcular el beneficio real del enrutamiento y construir un harness reproducible. JSON define contratos; la probabilidad representa incertidumbre; una caché sólo es válida para una identidad y versión concretas. El ejercicio requiere funciones Python y conceptos de timeout, sin modelo de pago.
Leer la promesa en el nivel correcto
El PDF de doce páginas se identifica como síntesis independiente de septiembre de 2026, sin respaldo de TypeSafe: propone estado explícito, contexto según consulta y rutas bajo política [2]. Almeida figura como coautor de InstructGPT [3], pero eso no demuestra la autoría del PDF.
El informe de TypeSafe atribuye 193,6× y 444,6× a workflows System One seleccionados, con probabilidades de modelos como referencia [4]. No prueba esa mejora en agentes completos. El mensaje aportado tampoco documenta una reproducción de la instalación en dos horas.
Una decisión, un workflow y una corrección aceptada son unidades distintas. Ahorrar por intento puede encarecer cada solución si aumentan los fallos. Aquí presentamos análisis propio y una simulación local, no una reconstrucción del modelo privado.
De texto generado a decisiones acotadas
La generación autorregresiva predice tokens sucesivos; una decisión acotada elige entre resultados ya definidos. TypeSafe describe salidas paralelas y denomina RLCD a su entrenamiento [4] [5]. Las fuentes revisadas no permiten reproducir arquitectura, pérdida y datos; no inventamos una implementación interna.
“Arregla el servicio” requiere investigación. “¿Qué subsistema debe recibir este paquete de evidencia?” tiene candidatos definidos. Sin embargo, una traza sin la política de reintentos puede inducir una respuesta formalmente válida y causalmente equivocada.
El esquema impide nombres de herramientas inexistentes, no la elección equivocada de una herramienta válida. Es como una función tipada que devuelve el entero incorrecto. Hay que comparar calidad, calibración y latencia contra un LLM con salida estructurada sobre la misma tarea.
En la notación, x es entrada, y₁:T la secuencia generada, s el estado, Q la pregunta y A las respuestas permitidas. La segunda expresión abstrae una interfaz, no el entrenamiento privado de Jev.
Diseñar la pregunta antes del modelo
Choice selecciona alternativas; Score expresa niveles ordenados; Noul devuelve la probabilidad de una proposición [6] [7] [8]. Una relevancia de 0,8 no significa 80% de correcciones válidas. Elegir un subsistema tampoco demuestra que el fallo esté entre los candidatos.
Nuestro paquete incluye objetivo, revisión, aserción fallida, fragmentos, IDs permitidos y evidencia ausente. Preguntamos por suficiencia y relevancia por separado. La insuficiencia provoca más búsqueda, no una elección obligatoria. Ausencia y contradicción se registran de forma distinta.
Agrupe preguntas independientes sobre una instantánea. Si B necesita la respuesta de A, ejecute otra etapa. Versione rúbrica y umbrales para que los registros históricos mantengan su significado.
Calibración, concentración y coste del error
Choice confidence reescala la probabilidad máxima respecto a la distribución uniforme [9]. Con tres opciones y máximo 0,8 resulta 0,7. No son dos confirmaciones independientes. Noul no lleva un campo confidence separado.
La calibración describe grupos: cerca de 0,8, el evento debería ocurrir aproximadamente el 80% de las veces. Un predictor constante puede estar calibrado y discriminar mal. La exactitud alta tampoco evita exceso de confianza en fallos raros. Analice repositorios, idiomas y clases de acciones por separado.
Ejemplo propio: un error cuesta 100 unidades y una revisión perfecta cuesta 2. Actuar cuesta en expectativa (1−p)×100; sólo gana si p>0,98. No es un umbral recomendado: la revisión también falla y las pérdidas cambian. La probabilidad nunca concede permisos.
Arquitectura para el incidente de reintentos
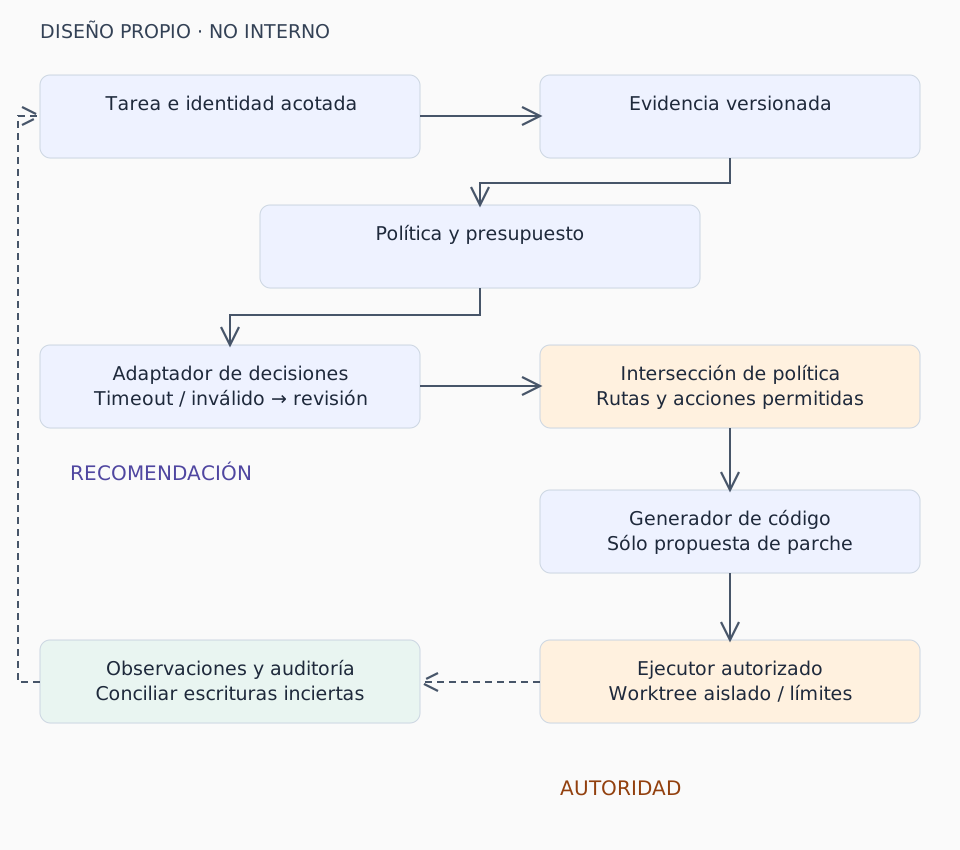
El controlador crea un ID, verifica acceso y fija un commit. El lector adjunta rutas, rangos y hashes a archivos autorizados. Los secretos se filtran antes de cualquier llamada externa, incluido el router. El almacén conserva observaciones inmutables; el controlador mantiene el estado activo y la política.
El constructor fija instrucciones y la aserción fallida, después añade evidencia dentro del presupuesto. La recomendación del decisor se intersecta con proveedores autorizados y recursos restantes. El generador propone un parche; el ejecutor verifica alcance y contenido antes de aplicarlo en un worktree aislado. Las salidas son datos, nunca autoridad.
Ante timeout se conserva una ruta prudente o revisión. Respuestas inválidas no ejecutan herramientas. Una versión obsoleta requiere releer. Cancelar evita nuevas acciones, no necesariamente cargos ya enviados. Tras un crash se reconcilian resultados desconocidos antes de repetir escrituras.
| Componente | Entrada → salida | No demuestra |
|---|---|---|
| Decisor | Evidencia y opciones → probabilidades | Permiso ni certeza |
| Constructor | Fragmentos y presupuesto → paquete | Irrelevancia de lo omitido |
| Política | Identidad y alcance → permitir/revisar/denegar | Corrección del parche |
| Ejecutor | Propuesta autorizada → observación | Ausencia de efecto por timeout |
| Verificador | Parche y comprobaciones → resultado | Corrección fuera de cobertura |
El contexto como presupuesto de evidencia
Para reparar reintentos, la regla de conservar el límite, el código actual y la aserción fallida pesan más que una antigua conversación. Cada fragmento necesita ID, revisión, procedencia, tamaño, permisos y marca obligatoria. Un resumen conserva el enlace a la fuente.
El modelo didáctico elige una representación por fragmento bajo presupuesto. Las utilidades son estimaciones; las dependencias importan: definición y llamada pueden ser útiles sólo juntas. Fije contratos, reserve salida y rechace presupuestos que no permitan la evidencia obligatoria.
Separe prefijo estable de evidencia dinámica para no destruir reutilización. Invalide resúmenes cuando cambien hashes. FastContext investiga búsqueda de repositorios por separado [10]; no constituye una medición de Jev.
Contabilizar la ruta completa
Ejemplo sintético: 10.000 tokens de entrada a $2/millón y 1.000 de salida a $8/millón cuestan $0,028. No son precios actuales. Una ruta barata de $0,010 más $0,015 de transferencia/revisión y $0,001 de decisión cuesta $0,026: ahorra sólo 7,1%. Otros $0,004 de reintentos eliminan el ahorro.
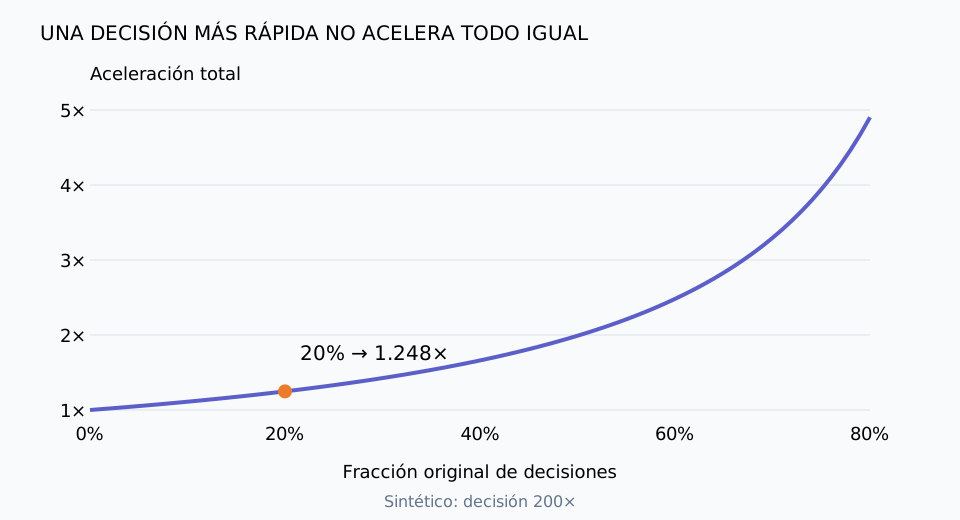
Si las decisiones ocupan 20% del tiempo y se aceleran 200×, Amdahl limita la mejora total a aproximadamente 1,248×. En tareas paralelas importa el camino crítico, no sumar spans solapados.
Mida coste por corrección aceptada incluyendo fallos, búsqueda y revisión. Iguale versiones y cachés. La caché de prompts y la residencia KV no son el mismo contrato de facturación; no presuponga reutilización entre modelos.
nᵤ, n꜀ y nₒ cuentan entrada sin caché, con caché y salida; p son dólares por millón. C_d es el coste de decidir. En S, f es la fracción temporal original y s su aceleración, con trabajo restante invariable y composición serial.
Una recomendación no es un permiso
Preparar un parche no autoriza desplegarlo. Una recomendación segura de sí misma sigue fuera de alcance. Compruebe acciones y destinos antes del enrutamiento y justo antes de ejecutar; vincule aprobación a ID, digest, destino, vencimiento y revisión.
Buscar cadenas peligrosas no asegura un shell. Subprocesos, imports y enlaces simbólicos cambian el efecto real. Use operaciones estrechas, rutas canónicas, aislamiento, límites y ausencia de credenciales de producción. Los tests también ejecutan código no confiable.
Comentarios y logs pueden contener inyección. Su procedencia no les concede autoridad. Ante timeout de escritura, consulte el resultado antes de reintentar: SQLite no crea una transacción atómica con una API externa.
Integrar una decisión antes de reconstruir el agente
Hay tres niveles: una skill enseña a integrar; una herramienta ofrece el servicio; un harness nativo controla cada turno. Instalar la primera no concede el tercero. Verifique qué permite la versión concreta del agente.
Empiece por ranking de evidencia en modo sombra, sin cambiar ejecución. Revise discrepancias y active una cohorte pequeña con rollback inmediato. Añada rutas de modelos sólo si puede transferir contexto independiente y resultados compactos.
El adaptador necesita validación, versión resuelta, deadlines, concurrencia limitada y coste de fallos. La caché incluye versiones de modelo, pregunta, política y hash de estado, sin compartir entre clientes. API y skill oficiales están al final [11] [12]. El laboratorio usa fixtures locales; no llama servicios de pago.
Cuándo compensa y dónde falla
Use código para hechos deterministas, embeddings o rerankers para relevancia, un decisor para juicios acotados y generación para nuevos parches. No convierta cada rama en una llamada AI.
El comprador típico es plataforma de desarrollo o infraestructura de agentes. Compra tareas correctas bajo restricciones de coste y privacidad. El especialista compite en latencia y calibración; el proveedor general puede agrupar routing y caché; el harness controla workflow y auditoría; el modelo local añade operación propia. No es una clasificación de cuota ni una afirmación sobre adquisiciones.
Persisten calibración de eventos raros, candidatos ausentes, dependencias podadas y errores correlacionados. Más paralelismo puede subir la factura. Optimizar un router no demuestra mejora recursiva de inteligencia.
Práctica, validación y entrevistas
Ejecute python3 lab.py con Python 3.11+. No hay dependencias, credenciales ni red. Los fixtures son deterministas y no necesitan semilla. SQLite en memoria deja cinco decisiones distintas tras reproducir la misma solicitud; no demuestra recuperación entre procesos.
El flujo fija evidencia obligatoria, valida probabilidades, propone una ruta y aplica política. El hash identifica repeticiones. La selección voraz no es óptima y los tamaños son estimados. No se ejecuta shell ni se genera un parche.
Espere policy/assertion/implementation, rechazo por presupuesto insuficiente, review para respuestas ambiguas o inválidas y deny para deploy. Una revisión nueva crea otra identidad. Inyecte proveedor no autorizado, NaN, candidato ausente y versión de política nueva: revisión, rechazo de esquema, rechazo de esquema e identidad nueva. Añada concurrencia y recuperación antes de usar almacenamiento persistente.
Compare agente original, heurística, LLM estructurado y Jev sobre tareas reservadas con iguales permisos. Separe las ablaciones de contexto y routing. Mida éxito, coste por solución, p50/p95, caché, tiempo humano y violaciones. Repita por dificultad, conserve fallos y separe calibración del test final.
Brier es la media de (p−y)²: el ejemplo da 0,255, sin demostrar calibración real. Examine cobertura y errores según umbral: enviar todo a revisión no automatiza nada. Incluya evidencia ausente, inyección, caída del servicio, hashes obsoletos y escrituras inciertas.
Descargar laboratorio Python completo"""Python 3.11+, standard library only. Offline harness simulation, NOT Jev.
No network, shell execution, real code edits, GPU or model benchmark.
Run: python3 lab.py
"""
from dataclasses import dataclass
from hashlib import sha256
import json
import math
import sqlite3
@dataclass(frozen=True)
class Chunk:
id: str
revision: str
text: str
tokens: int # Synthetic fixture sizes, not a tokenizer measurement.
utility: float
mandatory: bool = False
def select(chunks, budget):
if budget < 0 or len({c.id for c in chunks}) != len(chunks):
raise ValueError("invalid budget or duplicate chunk")
if any(c.tokens <= 0 or not math.isfinite(c.utility) for c in chunks):
raise ValueError("invalid chunk")
pinned = [c for c in chunks if c.mandatory]
left = budget - sum(c.tokens for c in pinned)
if left < 0:
raise ValueError("mandatory evidence exceeds budget")
result = pinned[:]
# A transparent greedy heuristic; not an optimal dependency-aware solver.
for c in sorted((c for c in chunks if not c.mandatory),
key=lambda c: (-c.utility / c.tokens, c.id)):
if c.tokens <= left:
result.append(c)
left -= c.tokens
return result
def validate_answer(answer):
if not isinstance(answer, dict) or set(answer) != {"choice", "probabilities"}:
raise ValueError("invalid answer schema")
p = answer["probabilities"]
if not isinstance(p, dict) or set(p) != {"local", "frontier", "review"}:
raise ValueError("unknown candidates")
if any(type(x) not in (int, float) or not math.isfinite(x) or not 0 <= x <= 1
for x in p.values()) or not math.isclose(sum(p.values()), 1.0, abs_tol=1e-8):
raise ValueError("invalid probabilities")
if answer["choice"] not in p or p[answer["choice"]] != max(p.values()):
raise ValueError("choice does not match maximum")
return p
def choose_route(answer, action, policy):
# These are typed fixture actions. No shell-string safety claims.
if action not in policy["allowed_actions"]:
return "deny"
try:
p = validate_answer(answer)
except ValueError:
return "review"
target = answer["choice"]
if target not in policy["eligible_routes"] or p[target] < policy["threshold"]:
return "review"
return target
def record(db, state, action, policy, answer):
# Identity includes all decision inputs, not just an action name.
payload = json.dumps([state, action, policy, answer], sort_keys=True,
separators=(",", ":"), allow_nan=False)
key = sha256(payload.encode()).hexdigest()
existing = db.execute("SELECT result FROM events WHERE id=?", (key,)).fetchone()
if existing:
return existing[0], True
result = choose_route(answer, action, policy)
with db:
db.execute("INSERT INTO events VALUES (?, ?, ?)", (key, payload, result))
return result, False
def run():
policy = {"version": "policy-1", "allowed_actions": ["inspect", "propose_patch"],
"eligible_routes": ["local", "frontier", "review"], "threshold": 0.9}
chunks = [Chunk("policy", "r1", "Keep retry cap; do not deploy.", 40, 1, True),
Chunk("assertion", "r1", "Expected at most three attempts.", 60, 1, True),
Chunk("implementation", "r1", "Current retry loop.", 120, 0.96),
Chunk("old_chat", "r0", "Superseded discussion.", 400, 0.1)]
chosen = select(chunks, 240)
assert [x.id for x in chosen] == ["policy", "assertion", "implementation"]
try:
select(chunks, 99)
except ValueError:
pass
else:
raise AssertionError("must reject missing mandatory evidence")
state = {"task": "retry-incident", "revision": "r1", "question_version": "q1",
"chunks": [c.__dict__ for c in chosen]}
good = {"choice": "local", "probabilities": {"local": 0.94, "frontier": 0.04, "review": 0.02}}
low = {"choice": "local", "probabilities": {"local": 0.55, "frontier": 0.4, "review": 0.05}}
malformed = {"choice": "delete_production", "probabilities": {"other": 1.0}}
# In-memory SQLite tests replay logic without leaving personal data behind.
with sqlite3.connect(":memory:") as db:
db.execute("CREATE TABLE events (id TEXT PRIMARY KEY, payload TEXT, result TEXT)")
assert record(db, state, "inspect", policy, good) == ("local", False)
assert record(db, state, "inspect", policy, good) == ("local", True)
assert record(db, state, "inspect", policy, low)[0] == "review"
assert record(db, state, "inspect", policy, malformed)[0] == "review"
assert record(db, state, "deploy", policy, good)[0] == "deny"
changed = dict(state, revision="r2")
assert record(db, changed, "inspect", policy, good) == ("local", False)
count = db.execute("SELECT COUNT(*) FROM events").fetchone()[0]
assert count == 5
n, p = 3, 0.8
confidence = (p - 1/n) / (1 - 1/n)
speedup = 1 / (0.8 + 0.2/200)
assert math.isclose(confidence, 0.7)
# Synthetic binary forecasts; Brier is not measured on Jev.
forecasts, outcomes = [0.9, 0.8, 0.4, 0.1], [1, 0, 1, 0]
brier = sum((p-y)**2 for p, y in zip(forecasts, outcomes)) / len(outcomes)
print(json.dumps({"mode": "offline_fixture_not_jev", "network_calls": 0,
"selected_chunks": [x.id for x in chosen], "audit_rows": count,
"choice_confidence": round(confidence, 6),
"synthetic_task_speedup": round(speedup, 6),
"synthetic_brier": round(brier, 6),
"replay_schema_policy_revision_checks": "passed"}, indent=2))
if __name__ == "__main__":
run()
Salida esperada
{
  "mode": "offline_fixture_not_jev",
  "network_calls": 0,
  "selected_chunks": [
    "policy",
    "assertion",
    "implementation"
  ],
  "audit_rows": 5,
  "choice_confidence": 0.7,
  "synthetic_task_speedup": 1.248439,
  "synthetic_brier": 0.255,
  "replay_schema_policy_revision_checks": "passed"
}
Contrato opcional, no ejecutado
JSON ilustrativo para POST https://api.typesafe.ai/v1/systemone, no enviado. Siga autenticación oficial con credenciales privadas del servidor, nunca del sitio estático. Registre la versión resuelta por jev-latest y dependencias bloqueadas si usa SDK. No se verificó una llamada real.
{
  "model": "jev-latest",
  "state": {
    "goal": "Identify evidence for a retry amplification incident",
    "revision": "example-r1",
    "evidence": "Fixture: retry loop restarts its attempt counter after a timeout; required cap is three attempts."
  },
  "questions": {
    "subsystem": {
      "type": "choice",
      "instructions": "Which subsystem is directly implicated by the supplied evidence?",
      "criteria": {
        "retry_control": "Attempt counting, stopping and retry budget",
        "rendering": "Displaying a user interface",
        "unknown": "The supplied evidence does not identify a subsystem"
      }
    }
  }
}
Preguntas originales, no entrevistas reales de empresas
1. ¿Por qué 200× por decisión no es 200× por tarea?
Pista: camino crítico restante. Respuesta:
2. ¿Confianza 0,99 autoriza desplegar?
Pista: creencia frente a autoridad. Respuesta: no; alcance, destino, aprobación y digest actual siguen siendo obligatorios.
3. ¿Cuándo cuesta más una ruta barata?
Pista: ambos traspasos. Respuesta: recarga, revisión, caché perdida y fallos pueden superar el ahorro; mida coste por solución aceptada.
4. ¿Cómo distinguir calibración útil de evitar todo trabajo?
Pista: riesgo y cobertura. Respuesta: errores automáticos, cobertura y coste humano juntos, con datos reservados y casos raros graves.
Puntuación: 1—términos; 2—separación modelo/harness; 3—código, coste y confianza; 4—versiones, fallos y permisos; 5—comparación justa por tarea y límites defendibles.
Continuar aprendiendo
Fundamentos explicados
Repasa el razonamiento que sostiene el método y utiliza las comprobaciones para detectar lagunas.
Un agente es un bucle con estado: observar, proponer, autorizar, ejecutar e inspeccionar. Un esquema valida argumentos, no permisos ni efectos reales. El texto del modelo es una propuesta, no evidencia de ejecución. Distingue intento, respuesta exitosa y resultado verificado.
Razona antes de abrir la solución
Una herramienta de pago agota el tiempo tras recibir la solicitud. ¿Se debe reintentar inmediatamente?
Solución paso a paso
No: el resultado es desconocido y el pago pudo completarse antes de perder la respuesta. Usa una clave de idempotencia y consulta de estado, o pausa para conciliar. Reintentar a ciegas puede duplicar un efecto irreversible; limitar pasos no corrige ese error.
Conexión con la práctica
Los asistentes con herramientas necesitan estado, autorización y condiciones de parada gestionados por la aplicación. Registra hechos, incertidumbres y confirmaciones pendientes. La autonomía necesita resultados verificables y permisos acotados.
Cómo demostrar comprensión
Traza éxito, rechazo, timeout y respuestas malformadas. Verifica que lo denegado nunca se ejecute y que los reintentos sean idempotentes. Limita pasos, tiempo y gasto por separado; empieza con herramientas simuladas.
Ejemplo Python completo
Python 3.10+ · solo biblioteca estándar · determinista, sin semilla aleatoria · sin red. Guarda el archivo y ejecuta el comando. Son comprobaciones didácticas, no benchmarks.
Descargar Python · agent.pypython3 agent.py# Python 3.10+; standard library; deterministic; no network.
# In-memory mock only: no real payment or network call.
ledger = {}
def pay(key, amount):
if key in ledger:
if ledger[key] != amount:
raise ValueError("same key with different request")
return "already applied"
ledger[key] = amount
return "applied"
assert pay("order-1", 10) == "applied"
# Pretend the reply was lost. Reconcile and retry with the same key.
assert ledger.get("order-1") == 10
assert pay("order-1", 10) == "already applied"
assert len(ledger) == 1
try:
pay("order-1", 20)
raise AssertionError("conflicting retry accepted")
except ValueError:
pass
print("one effect; duplicate retry suppressed")
Salida esperada
one effect; duplicate retry suppressed
Fundamento revisado:
Referencias y tutoriales adicionales
- TypeSafe — Introductionhttps://docs.typesafe.ai/introduction
- Jev Engineering for Coding Agents — PDF · 2026-09https://jevforagents.com/media/Jev-Engineering-for-Coding-Agents.pdf
- InstructGPT — arXiv:2203.02155v1 · 2022-03-04https://arxiv.org/abs/2203.02155v1
- TypeSafe — Introducing System One Models & Jev · 2026-09-15https://typesafe.ai/blog/introducing-system-one-models-and-jev
- TypeSafe — AI primer / RLCDhttps://docs.typesafe.ai/introduction/machine-learning-primer
- TypeSafe — Choicehttps://docs.typesafe.ai/primitives/choice
- TypeSafe — Scorehttps://docs.typesafe.ai/primitives/score
- TypeSafe — Noulhttps://docs.typesafe.ai/primitives/noul
- TypeSafe — Confidencehttps://docs.typesafe.ai/confidence
- FastContext — arXiv HTML v1https://arxiv.org/html/2606.14066v1
- TypeSafe — API / Quick starthttps://docs.typesafe.ai/introduction/quickstart
- TypeSafe — Agent skillshttps://github.com/typesafe-ai/skills
- TypeSafe — Workflow evaluationshttps://evals.typesafe.ai/
- InstructGPT — PDF v1https://arxiv.org/pdf/2203.02155v1
- FastContext — abstract / version historyhttps://arxiv.org/abs/2606.14066v1
- FastContext — PDF v1https://arxiv.org/pdf/2606.14066v1
