De bytes a un Transformer entrenado: crea un modelo de lenguaje
Un proyecto para CPU con bytes, atención causal, pérdida, AdamW, checkpoints y generación; Python ejecutable y límites explícitos.
Fuentes y versiones
En este artículo
1. Qué construiremos y qué aprende un modelo
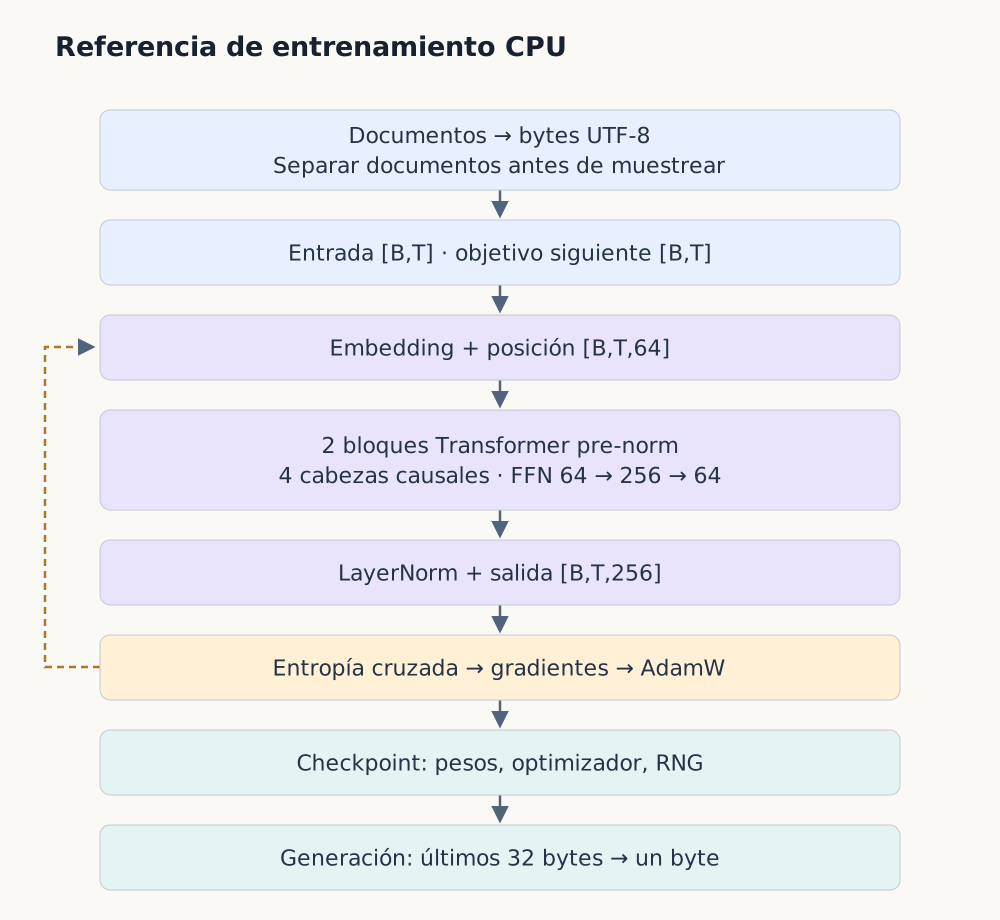
Imagina una consola que completa “node 107: status is”. Construiremos un Transformer causal, inicializaremos sus pesos al azar, lo entrenaremos con un corpus sintético original, guardaremos un checkpoint y generaremos bytes. No hacen falta pesos preentrenados, datos descargados ni una API de modelos. PyTorch aporta tensores, diferenciación automática y el optimizador: desde cero se refiere a la arquitectura y al flujo de entrenamiento, no a escribir kernels GPU.
El flujo completo de aprendizaje y generación
En pantallas pequeñas, desplaza horizontalmente o abre el diagrama completo. Ver diagrama completo
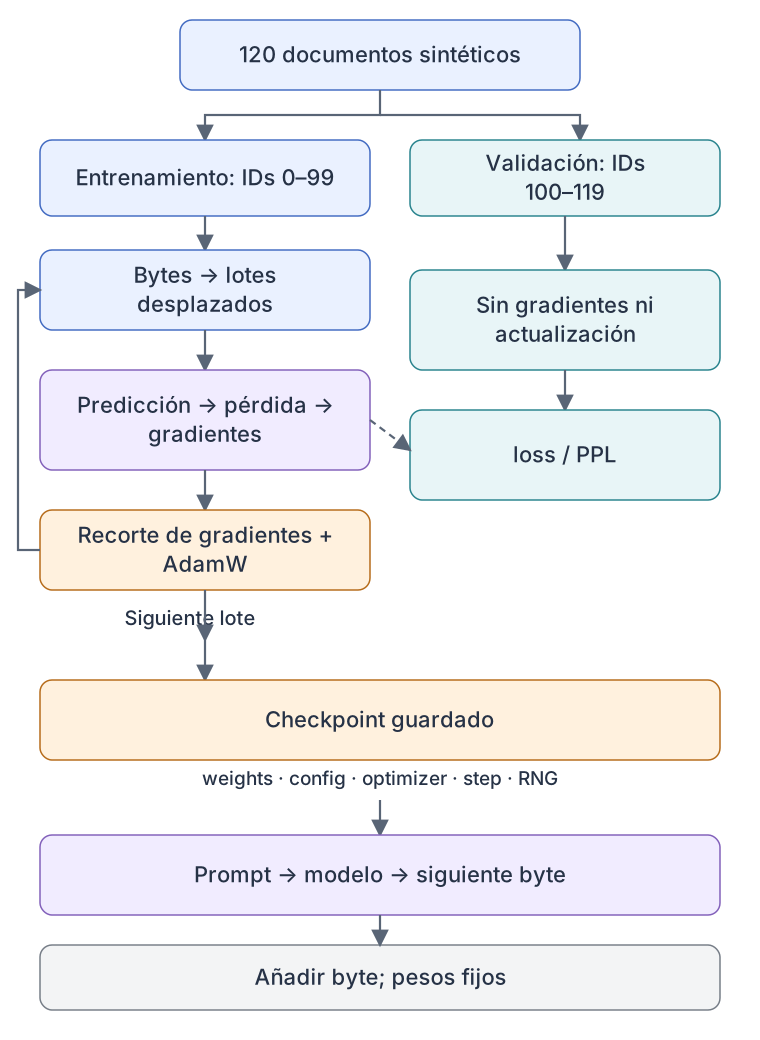
Un modelo de lenguaje estima la distribución del siguiente token condicionado por los anteriores. Los pesos representan regularidades estadísticas, no una base de hechos verificados. El modelo de 134.912 parámetros cabe en una CPU y muestra el esqueleto computacional de modelos mayores; no es un asistente general ni sigue instrucciones. El ejemplo distinguirá aprender la sintaxis de los mensajes de saber qué nodo debe estar ocupado.
Necesitas multiplicación matricial, distribuciones de probabilidad y regla de la cadena. La primera mezcla características; softmax convierte puntuaciones en probabilidades; la última propaga la señal de error. Si faltan estas bases, consulta los tutoriales del final antes de cambiar la arquitectura.
2. Preparar entorno y archivos
Descarga el proyecto y extráelo en un directorio nuevo. tiny_lm.py contiene modelo, corpus, entrenamiento y comprobaciones; generate.py es la entrada de inferencia y debe quedar al lado. Usa el proyecto como referencia al reconstruir cada función. Los fragmentos proceden de él; no son programas independientes para concatenar sin revisar.
La referencia ejecutada es Linux, Python 3.12 y PyTorch 2.5.1 CPU. Crea un entorno virtual e instala la versión fijada. La instalación descarga software; el entrenamiento usa un corpus original incorporado, sin API ni GPU. Otras plataformas pueden necesitar un paquete oficial compatible y mostrar pequeñas diferencias numéricas.
El resultado será tiny.pt con configuración, pesos, optimizador, paso y estados aleatorios. Primero aprenderás a construirlo y después a cargarlo desde otro proceso. Ejecuta entrenamiento, comprobaciones y generación en la práctica final. No necesitas pesos preentrenados.
unzip from-zero-lm.zip -d tokenlab-lm
cd tokenlab-lm
python3.12 -m venv .venv
. .venv/bin/activate
python -m pip install torch==2.5.1 --index-url https://download.pytorch.org/whl/cpu
3. De documentos a ejemplos supervisados
El corpus contiene 120 documentos: IDs pares ready e impares busy. Separamos documentos 0–99 para entrenamiento y 100–119 para validación antes de extraer ventanas. Así evitamos repartir ventanas del mismo documento entre ambos conjuntos, pero ambos comparten la misma gramática sintética: medimos interpolación, no generalización amplia.
Los bytes UTF-8 proporcionan
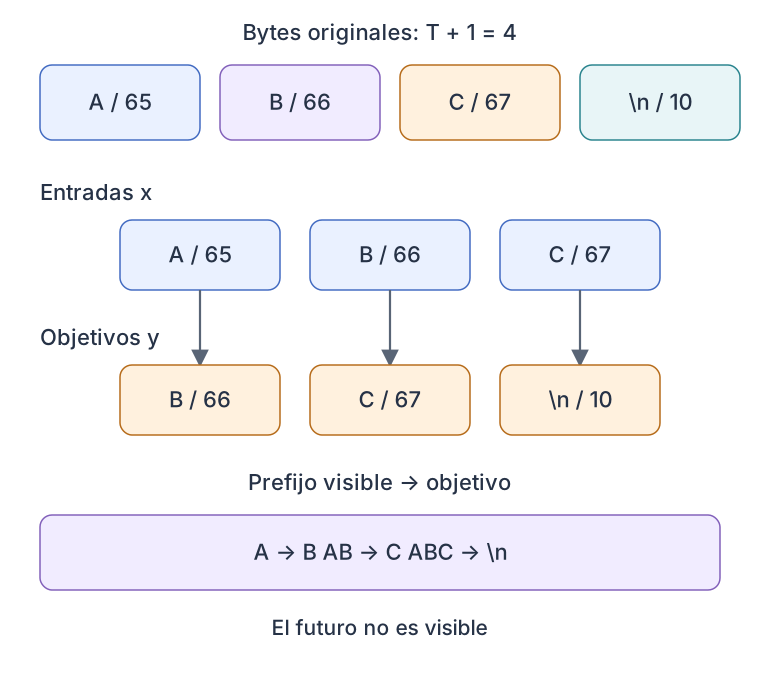
De T+1 bytes extraemos los primeros T como entrada y los últimos T como objetivo. [65,66,67,10] produce [65,66,67] → [66,67,10]. El lote tiene forma [B,T]. Las ventanas pueden cruzar saltos de línea entre documentos: si esa predicción no es válida, hacen falta límites explícitos y máscaras de pérdida.
Implementar el contrato de datos
Implementa corpus() y batch() en tiny_lm.py antes del bucle. corpus() devuelve dos cadenas de bytes; batch() convierte solo la partición elegida a IDs torch.long. El inicio debe dejar T+1 bytes: con N bytes hay N−T inicios válidos, de 0 a N−T−1. Cada muestra devuelve dos filas de longitud 32; con 16 muestras, x e y son [16,32]. Reutiliza el generador para avanzar su estado, sin reiniciar la semilla en cada paso.
Fragmento de implementación · ejecuta el proyecto completo
def corpus():
    # Original synthetic sentences. Split document IDs BEFORE window extraction.
    docs = [f'node {i:03d}: status is {"ready" if i % 2 == 0 else "busy"}.\n' for i in range(120)]
    return ''.join(docs[:100]).encode(), ''.join(docs[100:]).encode()

def batch(raw, generator, size=16):
    data=torch.tensor(list(raw), dtype=torch.long)
    t=CFG['context']
    starts=torch.randint(len(data)-t, (size,), generator=generator)
    return torch.stack([data[i:i+t] for i in starts]), torch.stack([data[i+1:i+t+1] for i in starts])
La separación es una frontera estadística. Con --text, prepara antes el corpus y asegura más de 32 bytes en cada partición. El programa concatena documentos y no implementa máscaras por documento ni deduplicación. Más datos cambian la distribución y la frecuencia con que se muestrea cada pasaje.
Una secuencia, tres objetivos
En pantallas pequeñas, desplaza horizontalmente o abre el diagrama completo. Ver diagrama completo
4. Atención: una lectura ponderada con límite causal
Usamos
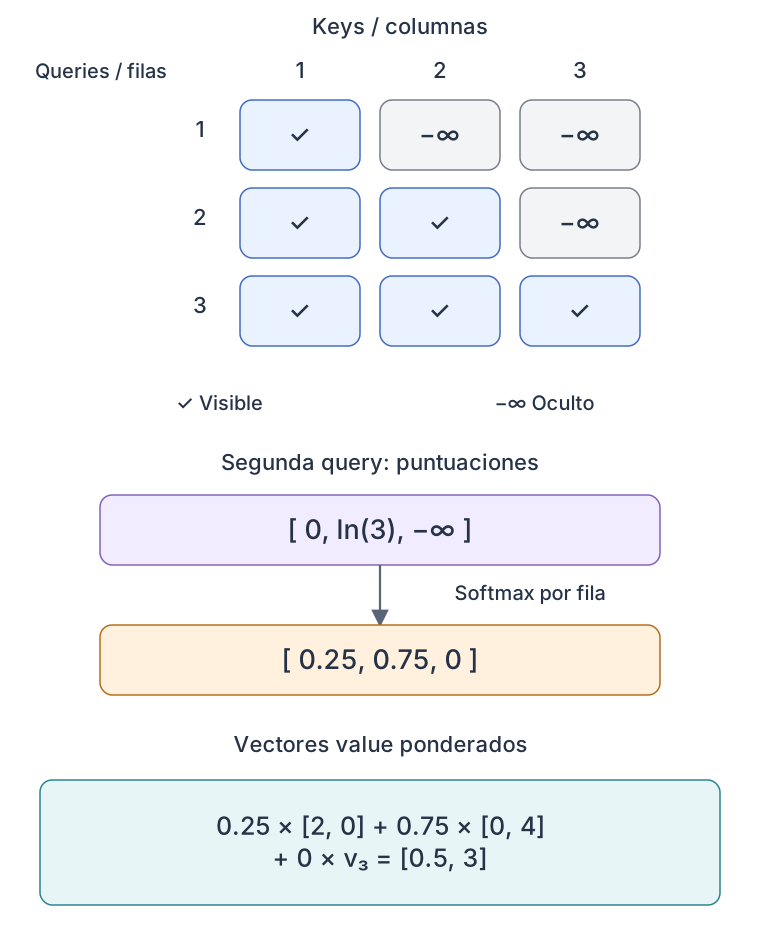
Antes de softmax, ponemos −∞ donde la clave j está en el futuro de la consulta i. Normalizamos sobre claves y multiplicamos por V. Logits escalados [0,log 3] dan [0,25;0,75]. Con valores [2,0] y [0,4], la salida es [0,5;3]. En la primera posición la segunda clave está oculta y sale [2,0]. Usamos softmax estable, nunca sobre el eje del lote.
Unimos cuatro cabezas [T,16] y proyectamos [T,64]. Los scores tienen 65.536 float32, 256 KiB por capa, sin contar otros tensores. La atención densa es cuadrática en T; esta implementación no usa FlashAttention ni caché KV. Un peso de atención tampoco demuestra causalidad explicativa.
Seguir la separación y unión de cabezas
La proyección QKV transforma [16,32,64] en [16,32,192]; chunk devuelve tres tensores de ancho 64. Cada uno pasa a [16,32,4,16] y se transpone a [16,4,32,16]. Los scores son [16,4,32,32]; el último eje representa keys, por lo que softmax(dim=-1) normaliza las posiciones fuente de cada query. La máscara triangular se difunde por lote y cabezas. Es un buffer guardado, no un parámetro optimizable.
Fragmento de implementación · ejecuta el proyecto completo
class Attention(nn.Module):
    def __init__(self, width, heads, context):
        super().__init__()
        assert width % heads == 0
        self.heads, self.dim = heads, width // heads
        self.qkv = nn.Linear(width, 3 * width)
        self.out = nn.Linear(width, width)
        self.register_buffer('mask', torch.ones(context, context, dtype=torch.bool).tril())

    def forward(self, x):
        b, t, c = x.shape
        q, k, v = self.qkv(x).chunk(3, dim=-1)
        q, k, v = [a.view(b, t, self.heads, self.dim).transpose(1, 2) for a in (q, k, v)]
        scores = q @ k.transpose(-2, -1) / math.sqrt(self.dim)
        scores = scores.masked_fill(~self.mask[:t, :t], float('-inf'))
        mixed = scores.softmax(dim=-1) @ v
        return self.out(mixed.transpose(1, 2).contiguous().view(b, t, c))
El resultado [16,4,32,16] se transpone, se hace contiguo y se fusiona a ancho 64. Omitir la transposición mezcla tiempo y cabezas. La escala es √16=4 por cabeza, no √64=8. Enmascarar después de softmax sin renormalizar pierde masa; aquí se enmascaran scores antes.
Atención causal: de la máscara al vector
En pantallas pequeñas, desplaza horizontalmente o abre el diagrama completo. Ver diagrama completo
5. Sigue cada tensor por el decodificador
Usamos
Cada bloque pre-normalizado suma atención sobre LayerNorm(X) y después una red de dos capas sobre el nuevo estado normalizado. Esa red aplica 64→256, GELU y 256→64 por posición. Atención mezcla posiciones; la red transforma características. Las conexiones residuales facilitan una ruta directa, sin resolver todos los problemas de optimización.
Una LayerNorm final y una proyección independiente [64,256] producen logits [16,32,256]. No compartimos pesos de entrada y salida. Con sesgos y normalizaciones son 134.912 parámetros, 539.648 bytes en float32. Gradientes, momentos de Adam y activaciones requieren memoria adicional.
LayerNorm calcula media y varianza sobre D características de cada token y aplica escala y sesgo aprendidos; no mezcla ejemplos ni mira al futuro. GELU aporta no linealidad. En la fórmula usamos vectores columna:
Montar el decodificador por dependencias
Implementa Attention, después Block y finalmente TinyLM. nn.Module registra las capas para que parameters() y state_dict() incluyan sus pesos. Los IDs indexan filas del embedding, no representan magnitudes numéricas. El embedding posicional distingue el mismo byte en distintas posiciones. Cada rama residual devuelve [B,T,D] para sumar elemento a elemento. Dos bloques transforman características y la cabeza lineal convierte 64 características en 256 puntuaciones sin normalizar.
Fragmento de implementación · ejecuta el proyecto completo
class Block(nn.Module):
    def __init__(self, c):
        super().__init__()
        d=c['width']
        self.n1, self.n2 = nn.LayerNorm(d), nn.LayerNorm(d)
        self.attn = Attention(d, c['heads'], c['context'])
        self.ff = nn.Sequential(nn.Linear(d, 4*d), nn.GELU(), nn.Linear(4*d, d))

    def forward(self, x):
        x = x + self.attn(self.n1(x))
        return x + self.ff(self.n2(x))

class TinyLM(nn.Module):
    def __init__(self, cfg=CFG):
        super().__init__()
        self.cfg = cfg
        self.tokens = nn.Embedding(cfg['vocab'], cfg['width'])
        self.positions = nn.Embedding(cfg['context'], cfg['width'])
        self.blocks = nn.Sequential(*[Block(cfg) for _ in range(cfg['layers'])])
        self.norm = nn.LayerNorm(cfg['width'])
        self.head = nn.Linear(cfg['width'], cfg['vocab'], bias=False)
        self.apply(self.init)

    @staticmethod
    def init(m):
        if isinstance(m, (nn.Linear, nn.Embedding)):
            nn.init.normal_(m.weight, std=.02)
            if getattr(m, 'bias', None) is not None: nn.init.zeros_(m.bias)

    def forward(self, ids):
        if ids.ndim != 2 or not 0 < ids.shape[1] <= self.cfg['context']:
            raise ValueError('Expected [batch, time], 1 <= time <= context')
        x = self.tokens(ids) + self.positions(torch.arange(ids.shape[1], device=ids.device))
        return self.head(self.norm(self.blocks(x)))
Usa CFG como definición única al construir y recargar. Cambiar ancho, vocabulario o capas altera formas y puede invalidar checkpoints anteriores. forward rechaza más de 32 posiciones. Ampliar contexto exige modificar tabla posicional y máscara, y considerar memoria cuadrática; no basta con aceptar entradas mayores.
| Etapa | Entrada → salida | Límite |
|---|---|---|
| Incrustación | [B,T] → [B,T,D] | |
| Q / K / V | [B,T,D] → [B,H,T,D/H] | 64 ÷ 4 = 16 |
| Atención | [B,H,T,T] × [B,H,T,D/H] | j≤i |
| Proyección | [B,T,D] → [B,T,V] | 134.912 parámetros |
| Pérdida | [BT,V] + [BT] → scalar | nats / byte |
6. Pérdida, gradientes y actualización
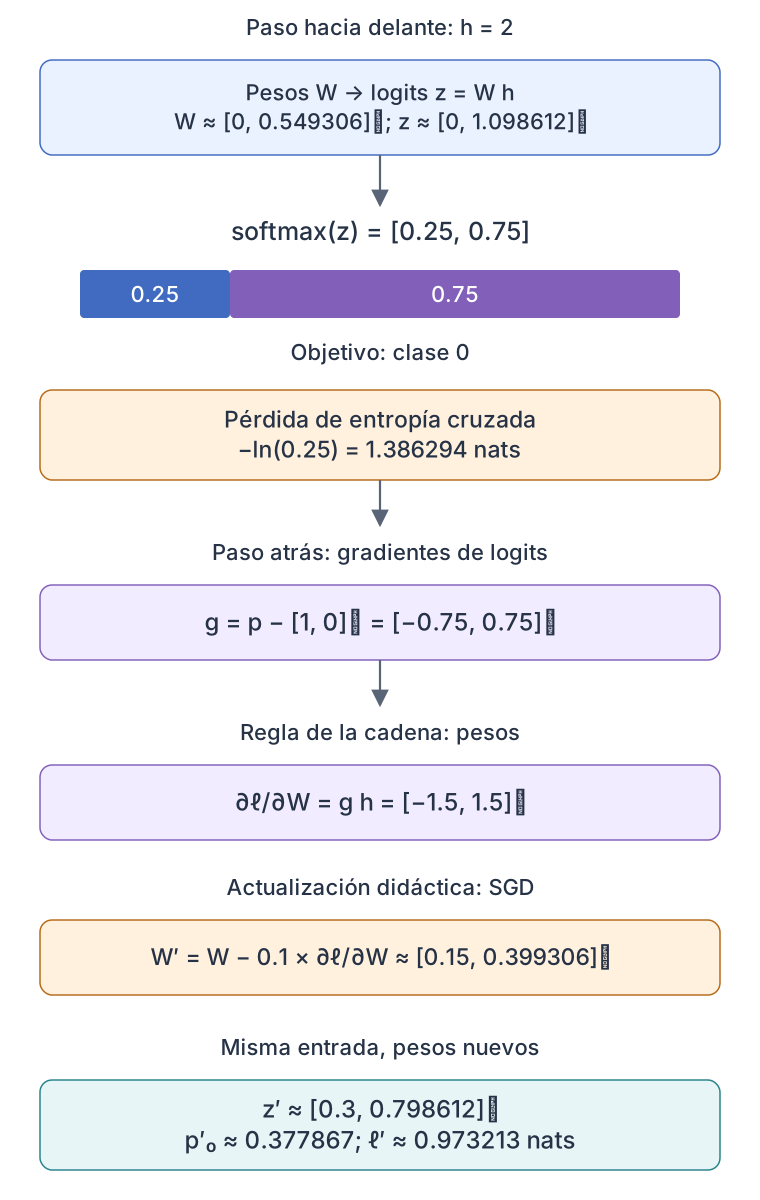
Con teacher forcing, cada posición ve bytes previos reales. Aplanamos logits [B,T,V] a [BT,V] y objetivos a [BT], y pasamos logits crudos a cross_entropy. No apliques softmax antes. Una probabilidad correcta de 0,25 aporta −
Cada paso borra gradientes anteriores, calcula pérdida, retropropaga, recorta la norma global a 1 y ejecuta AdamW. Sus momentos de primer y segundo orden adaptan las actualizaciones; el decaimiento desacoplado contrae pesos aparte. Aquí se aplica a todos los parámetros; excluir sesgos y normalización es otra decisión experimental válida.
La tasa máxima nominal es 0,002; un calentamiento de 20 pasos se multiplica por un factor coseno que se aproxima al 10% al final. Guardamos pesos, momentos, configuración, paso y estados aleatorios. Verificamos la recarga, pero no hay comando de reanudación: implementarlo exige restaurar también calendario y orden de datos.
La derivada respecto al logit es pᵢ−1[
Aísla la capa de salida: h es una columna normalizada [D,1], W son pesos [V,D] y
Implementar una actualización y repetir
En cada paso toma un nuevo lote, fija la tasa y borra gradientes. loss() convierte 16×32 posiciones en 512 ejemplos con 256 clases. backward() acumula en parameter.grad y opt.step() actualiza pesos; debes borrar gradientes salvo que acumular sea intencional. Los 300 pasos procesan 153.600 posiciones muestreadas con repeticiones, no bytes únicos ni épocas.
Fragmento de implementación · ejecuta el proyecto completo
def loss(model, x, y):
    logits=model(x)
return F.cross_entropy(logits.reshape(-1, CFG['vocab']), y.reshape(-1))opt=torch.optim.AdamW(model.parameters(),lr=.002,weight_decay=.01)
before=heldout_loss(model,val)
for step in range(args.steps):
model.train();x,y=batch(train,generator)
lr=.002*min((step+1)/20,1)*(.1+.9*.5*(1+math.cos(math.pi*step/args.steps)))
for group in opt.param_groups:group['lr']=lr
opt.zero_grad(set_to_none=True);value=loss(model,x,y)
if not torch.isfinite(value):raise RuntimeError('nonfinite loss')
value.backward();nn.utils.clip_grad_norm_(model.parameters(),1.0);opt.step()El calendario multiplica warmup y coseno; el coseno avanza durante warmup, de modo que el máximo real queda ligeramente por debajo de 0,002. Guarda parámetros y estado del optimizador por separado. Los gradientes no son el modelo entrenado. Se conservan estados para una futura reanudación, pero la generación solo recarga pesos y no implementa continuidad exacta del entrenamiento.
Del error de predicción a los pesos
En pantallas pequeñas, desplaza horizontalmente o abre el diagrama completo. Ver diagrama completo
7. Del checkpoint al texto generado
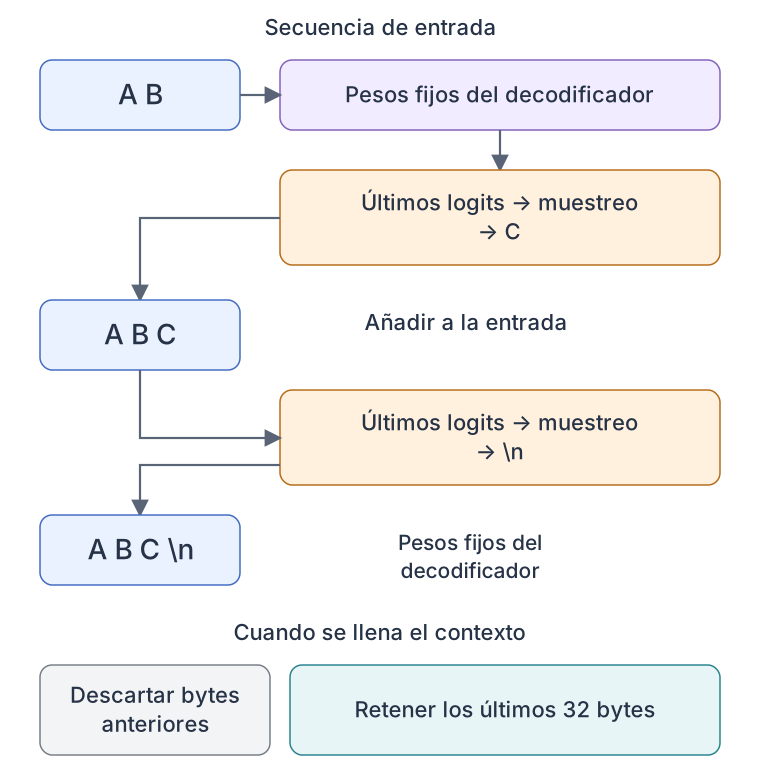
Codificamos un prompt no vacío, retenemos sus últimos 32 bytes y usamos los logits de la última posición. Dividimos por temperatura positiva, conservamos top-k, normalizamos y muestreamos un byte. Repetimos hasta un número fijo de bytes, sin EOS. Menor temperatura concentra la distribución; no garantiza veracidad.
Cada recorte reinicia posiciones aprendidas 0…31 y olvida el pasado lejano. Recalcular la ventana es sencillo pero costoso. Una caché KV necesita posiciones coherentes e invalidación: no puede añadirse mientras se reinician posiciones esperando equivalencia automática.
La decodificación UTF-8 reemplaza secuencias incompletas; el corpus ASCII reduce este problema. Un asistente útil exige datos legales más amplios, capacidad, entrenamiento de instrucciones, infraestructura y seguridad. Este modelo tampoco puede controlar de forma fiable el Agent complementario, que ofrece un adaptador para otro modelo local de instrucciones.
Cargar el checkpoint en otro proceso
Crea generate.py junto a tiny_lm.py para importar TinyLM sin iniciar entrenamiento gracias al guard main. Carga en CPU, reconstruye desde config, carga model y activa eval. Reinicia la semilla después de construir: inicializar pesos también consume aleatoriedad. Así separas el artefacto entrenado de la entrada de inferencia y puedes comparar ejecuciones en el mismo entorno.
Fragmento de implementación · ejecuta el proyecto completo
"""Generate from a trusted checkpoint without retraining."""
import argparse,torch
from tiny_lm import TinyLM
p=argparse.ArgumentParser();p.add_argument('checkpoint');p.add_argument('--prompt',default='node 10');p.add_argument('--seed',type=int,default=42)
a=p.parse_args();torch.set_num_threads(1);torch.manual_seed(a.seed)
s=torch.load(a.checkpoint,map_location='cpu',weights_only=True)
m=TinyLM(s['config']);m.load_state_dict(s['model']);m.eval()
torch.manual_seed(a.seed)
print(m.generate(a.prompt))
Ejecuta python generate.py tiny.pt --prompt "node 10" después del entrenamiento. Devuelve el prompt y 80 bytes nuevos. Es una interfaz CLI, no una API HTTP, y no tiene ajuste de instrucciones ni protocolo Agent. Un servidor con límites y cola sería una extensión futura. Usa checkpoints confiables: weights_only no demuestra su procedencia.
Generación autorregresiva byte a byte
En pantallas pequeñas, desplaza horizontalmente o abre el diagrama completo. Ver diagrama completo
8. Práctica, verificación y entrevistas
El programa comprueba formas, causalidad, límites, una derivada por diferencias finitas y logits tras recarga. Para comparar, fija corpus, particiones, semillas, pasos y protocolo: bigramas, uno/dos bloques y pesos aleatorios/entrenados. Separa pérdida y exactitud de paridad; repite tres semillas. Quitar la máscara demuestra fuga, no un competidor válido. Revisa licencias y particiones antes de --text y no sobreajustes la validación.
Implementación completa y comandos
python tiny_lm.py --steps 300 --output tiny.pt
python generate.py tiny.pt --prompt 'node 10'
# Optional: your own licensed UTF-8 text, after data preparation
# python tiny_lm.py --text corpus.txt --steps 300 --output own.pttiny_lm.py
"""Original Token Lab byte-level causal LM. Python 3.12 / torch 2.5.1 CPU.
Run: python tiny_lm.py --steps 300 --output tiny.pt
No pretrained weights, downloads, model API or third-party dataset.
"""
import argparse
import math
from pathlib import Path
import torch
from torch import nn
from torch.nn import functional as F
CFG = dict(vocab=256, context=32, width=64, heads=4, layers=2)
class Attention(nn.Module):
def __init__(self, width, heads, context):
super().__init__()
assert width % heads == 0
self.heads, self.dim = heads, width // heads
self.qkv = nn.Linear(width, 3 * width)
self.out = nn.Linear(width, width)
self.register_buffer('mask', torch.ones(context, context, dtype=torch.bool).tril())
def forward(self, x):
b, t, c = x.shape
q, k, v = self.qkv(x).chunk(3, dim=-1)
q, k, v = [a.view(b, t, self.heads, self.dim).transpose(1, 2) for a in (q, k, v)]
scores = q @ k.transpose(-2, -1) / math.sqrt(self.dim)
scores = scores.masked_fill(~self.mask[:t, :t], float('-inf'))
mixed = scores.softmax(dim=-1) @ v
return self.out(mixed.transpose(1, 2).contiguous().view(b, t, c))
class Block(nn.Module):
def __init__(self, c):
super().__init__()
d=c['width']
self.n1, self.n2 = nn.LayerNorm(d), nn.LayerNorm(d)
self.attn = Attention(d, c['heads'], c['context'])
self.ff = nn.Sequential(nn.Linear(d, 4*d), nn.GELU(), nn.Linear(4*d, d))
def forward(self, x):
x = x + self.attn(self.n1(x))
return x + self.ff(self.n2(x))
class TinyLM(nn.Module):
def __init__(self, cfg=CFG):
super().__init__()
self.cfg = cfg
self.tokens = nn.Embedding(cfg['vocab'], cfg['width'])
self.positions = nn.Embedding(cfg['context'], cfg['width'])
self.blocks = nn.Sequential(*[Block(cfg) for _ in range(cfg['layers'])])
self.norm = nn.LayerNorm(cfg['width'])
self.head = nn.Linear(cfg['width'], cfg['vocab'], bias=False)
self.apply(self.init)
@staticmethod
def init(m):
if isinstance(m, (nn.Linear, nn.Embedding)):
nn.init.normal_(m.weight, std=.02)
if getattr(m, 'bias', None) is not None: nn.init.zeros_(m.bias)
def forward(self, ids):
if ids.ndim != 2 or not 0 < ids.shape[1] <= self.cfg['context']:
raise ValueError('Expected [batch, time], 1 <= time <= context')
x = self.tokens(ids) + self.positions(torch.arange(ids.shape[1], device=ids.device))
return self.head(self.norm(self.blocks(x)))
@torch.no_grad()
def generate(self, prompt, count=80, temperature=.8, top_k=20):
if not prompt or temperature <= 0 or not 1 <= top_k <= self.cfg['vocab']:
raise ValueError('Nonempty prompt, positive temperature, valid top_k required')
self.eval()
ids = torch.tensor([list(prompt.encode('utf-8'))], dtype=torch.long)
for _ in range(count):
logits = self(ids[:, -self.cfg['context']:])[:, -1, :] / temperature
threshold = logits.topk(top_k).values[:, -1:]
logits = logits.masked_fill(logits < threshold, float('-inf'))
ids = torch.cat((ids, torch.multinomial(logits.softmax(-1), 1)), dim=1)
return bytes(ids[0].tolist()).decode('utf-8', errors='replace')
def corpus():
# Original synthetic sentences. Split document IDs BEFORE window extraction.
docs = [f'node {i:03d}: status is {"ready" if i % 2 == 0 else "busy"}.\n' for i in range(120)]
return ''.join(docs[:100]).encode(), ''.join(docs[100:]).encode()
def batch(raw, generator, size=16):
data=torch.tensor(list(raw), dtype=torch.long)
t=CFG['context']
starts=torch.randint(len(data)-t, (size,), generator=generator)
return torch.stack([data[i:i+t] for i in starts]), torch.stack([data[i+1:i+t+1] for i in starts])
def loss(model, x, y):
logits=model(x)
return F.cross_entropy(logits.reshape(-1, CFG['vocab']), y.reshape(-1))
@torch.no_grad()
def heldout_loss(model, raw):
model.eval()
data=torch.tensor(list(raw),dtype=torch.long)
total, count=0.,0
for i in range(0,len(data)-1,CFG['context']):
t=min(CFG['context'],len(data)-1-i)
x,y=data[i:i+t][None,:],data[i+1:i+t+1][None,:]
total += loss(model,x,y).item()*t
count += t
return total/count
def checks(model):
model.eval()
x=torch.arange(12)[None,:]
changed=x.clone();changed[:,7:]=200
with torch.no_grad():
a,b=model(x),model(changed)
assert a.shape == (1,12,256)
assert torch.allclose(a[:,:7],b[:,:7],atol=1e-6), 'future leak'
try:model(torch.zeros(1,33,dtype=torch.long))
except ValueError:pass
else:raise AssertionError('context overflow accepted')
# One coordinate of the readout gradient, central finite difference.
target=torch.arange(1,13)[None,:]
model.zero_grad(set_to_none=True)
loss(model,x,target).backward()
analytical=model.head.weight.grad[1,0].item()
original=model.head.weight[1,0].item();eps=.01
with torch.no_grad():
model.head.weight[1,0]=original+eps;plus=loss(model,x,target).item()
model.head.weight[1,0]=original-eps;minus=loss(model,x,target).item()
model.head.weight[1,0]=original
assert abs(analytical-(plus-minus)/(2*eps))<.002, 'gradient mismatch'
def main():
p=argparse.ArgumentParser();p.add_argument('--steps',type=int,default=300)
p.add_argument('--output',default='tiny.pt');p.add_argument('--text',help='Optional owned UTF-8 corpus; chronological 90/10 split')
args=p.parse_args()
if args.steps<1:raise ValueError('steps must be positive')
torch.set_num_threads(1);torch.manual_seed(42);torch.use_deterministic_algorithms(True)
generator=torch.Generator().manual_seed(123)
train,val=corpus()
if args.text:
raw=Path(args.text).read_text(encoding='utf-8').encode();cut=int(.9*len(raw));train,val=raw[:cut],raw[cut:]
if min(len(train),len(val))<=CFG['context']:raise ValueError('each split must exceed context')
model=TinyLM();checks(model)
opt=torch.optim.AdamW(model.parameters(),lr=.002,weight_decay=.01)
    before=heldout_loss(model,val)
    for step in range(args.steps):
        model.train();x,y=batch(train,generator)
        lr=.002*min((step+1)/20,1)*(.1+.9*.5*(1+math.cos(math.pi*step/args.steps)))
        for group in opt.param_groups:group['lr']=lr
        opt.zero_grad(set_to_none=True);value=loss(model,x,y)
        if not torch.isfinite(value):raise RuntimeError('nonfinite loss')
        value.backward();nn.utils.clip_grad_norm_(model.parameters(),1.0);opt.step()
after=heldout_loss(model,val)
torch.save({'config':CFG,'model':model.state_dict(),'optimizer':opt.state_dict(),
'step':args.steps,'rng':torch.get_rng_state(),'batch_rng':generator.get_state()},args.output)
saved=torch.load(args.output,weights_only=True);restored=TinyLM(saved['config']);restored.load_state_dict(saved['model']);restored.eval();model.eval()
probe=torch.tensor([[1,2,3]])
assert torch.equal(model(probe),restored(probe)), 'checkpoint mismatch'
checks(model)
print(f'parameters={sum(p.numel() for p in model.parameters())}')
print(f'validation_nats_per_byte: {before:.6f} -> {after:.6f}')
print(f'validation_perplexity_per_byte={math.exp(after):.6f}')
print('checks: shapes, causal mask, context bound, gradient, checkpoint passed')
if not args.text and args.steps>=300:assert after<before, 'synthetic learning failed'
torch.manual_seed(42);print('sample='+repr(model.generate('node 10')))
if __name__=='__main__':main()
generate.py
"""Generate from a trusted checkpoint without retraining."""
import argparse,torch
from tiny_lm import TinyLM
p=argparse.ArgumentParser();p.add_argument('checkpoint');p.add_argument('--prompt',default='node 10');p.add_argument('--seed',type=int,default=42)
a=p.parse_args();torch.set_num_threads(1);torch.manual_seed(a.seed)
s=torch.load(a.checkpoint,map_location='cpu',weights_only=True)
m=TinyLM(s['config']);m.load_state_dict(s['model']);m.eval()
torch.manual_seed(a.seed)
print(m.generate(a.prompt))
Resultados observados y límites
Ejecutado con Python 3.12, PyTorch 2.5.1+cpu, un hilo, semilla 42 e índice de lotes con semilla 123, durante 300 pasos. La pérdida pasó de 5,575623 a 0,546086 nats/byte; perplejidad 1,726483. Es corpus sintético, no lenguaje natural. El nodo 046 generado aparece busy pese a ser par: pérdida baja no prueba aprender la regla. Validamos reiniciando contexto cada 32 bytes y ponderando por tokens; puede variar ligeramente según plataforma.
parameters=134912
validation_nats_per_byte: 5.575623 -> 0.546086
validation_perplexity_per_byte=1.726483
checks: shapes, causal mask, context bound, gradient, checkpoint passed
sample='node 107: status is busy.\nnode 046: status is busy.\nnode 096: status is ready.\nnode 081'
Diagnóstico tras la primera ejecución
| Síntoma | Significado | Acción siguiente |
|---|---|---|
| ModuleNotFoundError: torch | Python no encuentra la dependencia. | Activa .venv; compara python -m pip --version con sys.executable e instala con el mismo intérprete. |
| Checkpoint ausente o incompatible | Entrenamiento incompleto, ruta errónea o configuración distinta. | Usa la ruta --output y config guardada; no ignores errores de forma. Reentrena si cambias la arquitectura. |
| Pérdida baja, estado incorrecto | Predecir bytes no equivale a dominar la regla. | Mide por separado la regla par/impar; fija entrenamiento y prompts en la comparación. |
Ejercicios originales, no entrevistas reales de empresas
Puntúa 1–5: 1 nombra; 2 define; 3 recorre el ejemplo; 4 explica un fallo y mitigación; 5 propone una comparación justa y límites de evidencia. Código sin explicación no obtiene la máxima nota.
1. ¿Por qué quitar la máscara puede parecer mejorar el modelo?
Pista
Busca el objetivo desplazado.
Respuesta y análisis
El siguiente byte aparece en el futuro de la entrada. Leerlo es fuga; generación no dispone de él. Cambiar el futuro no debe cambiar logits anteriores.
2. ¿Por qué perplejidad 1,73 no demuestra utilidad general?
Pista
Examina corpus, unidad y error.
Respuesta y análisis
Es perplejidad por byte sobre sintaxis repetida, no exactitud. El nodo 046 viola la regla. Evalúa tareas independientes e informa tokenización y partición.
3. ¿Bastan iguales pasos para comparar anchos 64 y 128?
Pista
Distingue datos y cómputo.
Respuesta y análisis
Iguales pasos controlan datos, no FLOPs. Proyecciones crecen aproximadamente con D². Reporta comparación por datos y por presupuesto medido, con varias semillas.
4. ¿Por qué guardar pesos no basta para reanudar exactamente?
Pista
Sigue todo el estado de actualización.
Respuesta y análisis
Momentos, calendario, RNG y posición de datos afectan el paso. El ejemplo guarda estado pero solo recarga; compara ejecución continua y reanudada al añadir resume.
Fundamentos explicados
Repasa el razonamiento que sostiene el método y utiliza las comprobaciones para detectar lagunas.
Una red neuronal es una composición de funciones. En X de forma [B,d], B cuenta ejemplos y d sus características. Al multiplicar por W de forma [d,h] obtenemos h sumas ponderadas por ejemplo; el sesgo [h] se añade a cada fila.
Debes calcular una entrada y justificar las dimensiones internas. Una activación introduce no linealidad: apilar únicamente capas afines sigue produciendo una transformación afín.
Aquí los ejemplos son filas. La convención posterior de un ejemplo como columna usa pesos [h,d], la transpuesta de esta matriz; ambas describen el mismo mapa.
Razona antes de abrir la solución
Una derivada mide sensibilidad local. La regla de la cadena conecta la sensibilidad de la pérdida a la predicción con la de la predicción al peso. Con
Solución paso a paso
La predicción vale 2 y la pérdida 0.5. Las dos derivadas son −1 y 2; su producto da dL/
Conexión con la práctica
XOR traslada este cálculo a una representación oculta. (0,0) y (1,1) tienen etiqueta 0; (0,1) y (1,0), etiqueta 1. Ninguna recta separa las clases. Una capa no lineal puede transformarlas para que un clasificador lineal final las separe. Es una ilustración del aprendizaje de características, no una demostración de capacidades de un gran modelo.
Cómo demostrar comprensión
Anota las formas del cálculo y verifica un gradiente con diferencias centrales en un punto suave. Varía el paso para detectar errores de redondeo. Compara modelos lineal y no lineal con iguales datos y presupuesto. Memorizar las cuatro filas XOR no demuestra generalización: para estudiarla necesitas una tarea o partición reservada.
Ejemplo Python completo
Python 3.10+ · solo biblioteca estándar · determinista, sin semilla aleatoria · sin red. Guarda el archivo y ejecuta el comando. Son comprobaciones didácticas, no benchmarks.
Descargar Python · neural.pypython3 neural.py# Python 3.10+; standard library; deterministic; no network.
from math import isclose
def loss(w):
return (w * 2.0 - 3.0) ** 2 / 2
w, learning_rate = 1.0, 0.1
gradient = (w * 2.0 - 3.0) * 2.0
h = 1e-5
numeric = (loss(w + h) - loss(w - h)) / (2 * h)
assert isclose(gradient, numeric, abs_tol=1e-8)
w_new = w - learning_rate * gradient
assert isclose(w_new, 1.2)
assert isclose(loss(w_new), 0.18)
assert loss(w_new) < loss(w)
print("gradient=-2.0; weight=1.2; loss=0.18")
Salida esperada
gradient=-2.0; weight=1.2; loss=0.18
Fundamento revisado:
Tutoriales, artículos y referencias adicionales
Referencias comprobadas el 10 de noviembre de 2026. Código, ejemplos y diagramas son material didáctico original. Los enlaces complementan el aprendizaje; no implican aval ni reproducción de sus modelos. Las fechas de artículos son independientes.
Nano AI · Build a language modelhttps://nano-ai.tech/articles/
Ruta china por módulos, de inferencia a entrenamiento.
Nano AI · GPT from scratchhttps://nano-ai.tech/articles/llm-from-scratch/
Compara inferencia GPT-2 con nuestro entrenamiento desde pesos aleatorios.
Andrej Karpathy · Neural Networks: Zero to Herohttps://karpathy.ai/zero-to-hero.html
Retropropagación y modelos progresivos para entender gradientes.
Sebastian Raschka · LLMs from scratchhttps://github.com/rasbt/LLMs-from-scratch
Implementaciones de un libro para ampliar arquitectura y entrenamiento.
Andrej Karpathy · nanoGPThttps://github.com/karpathy/nanoGPT
Repositorio práctico con requisitos distintos de hardware y datos.
Attention Is All You Needhttps://arxiv.org/abs/1706.03762
Transformer original frente a nuestra simplificación causal. Primera versión: 2017-06-12; v7: 2023-08-02.
OpenAI · Language Models are Unsupervised Multitask Learners (2019)https://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf
Informe histórico GPT-2; no atribuye sus capacidades al ejemplo.
PyTorch · cross_entropyhttps://docs.pytorch.org/docs/main/generated/torch.nn.functional.cross_entropy.html
Referencia de API en main; el proyecto está fijado y probado con PyTorch 2.5.1+cpu.
PyTorch · AdamWhttps://docs.pytorch.org/docs/main/generated/torch.optim.AdamW.html
Referencia de API en main; el proyecto está fijado y probado con PyTorch 2.5.1+cpu.