Empieza aquí: un asistente local de evidencias
Construye tu primer asistente de evidencias: una base local completa
Convierte documentos en un sistema determinista con fuentes. Implementa búsqueda y abstención y establece una referencia antes de incorporar un modelo o agente.
Fuentes y versiones
En este artículo
1. El problema y el compromiso
Imagina a un ingeniero buscando “timeout retry” en un manual. Antes del agente conversacional, devuelve un pasaje público con su ID o abstente si no hay evidencia léxica. El sistema devuelve texto literal: es una base de recuperación, no un LLM, buscador semántico ni servicio seguro de producción.
Entregarás un archivo Python y pruebas separadas. Explicarás el contrato, calcularás una clasificación, reproducirás un fallo y localizarás dónde añadir inferencia. Reserva una o dos sesiones; es una estimación de planificación.
2. Requisitos explicados
Una función transforma entradas; un diccionario nombra campos. Un conjunto elimina repeticiones: repetir palabras no aumenta el peso. El ID es una referencia estable, a diferencia de la posición. Una dataclass congelada evita reasignaciones accidentales, pero no autentica documentos ni impide sustituir la colección.
Una referencia es un comparador sencillo y fijo. Abstenerse significa no superar una regla, no demostrar que no existe respuesta. La traza registra el orden de candidatos. Una respuesta fluida puede ocultar mala recuperación y una puntuación alta puede seleccionar texto irrelevante.
3. Arquitectura y contratos
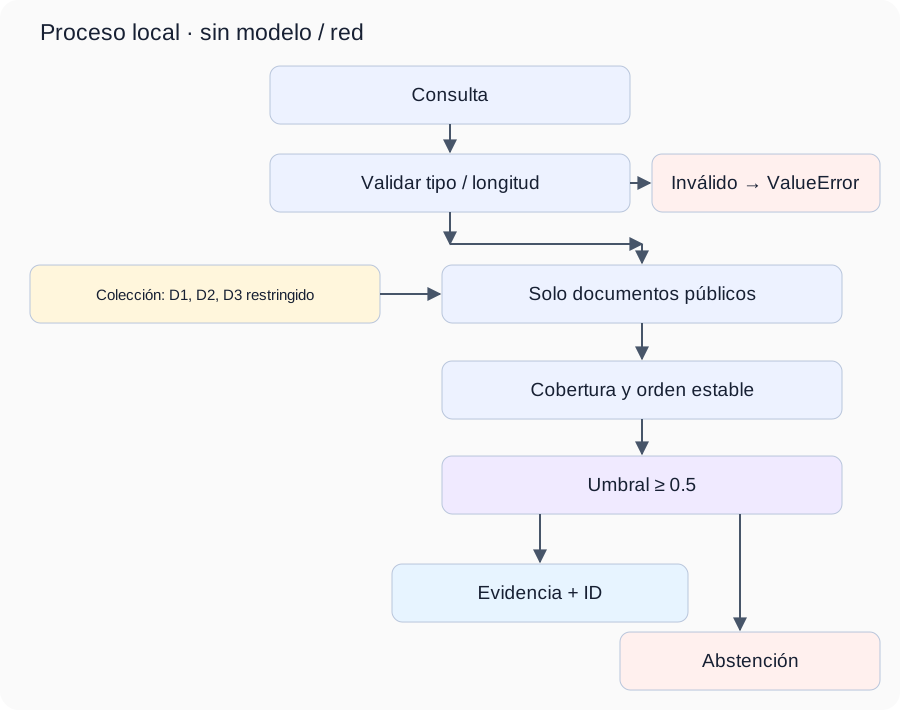
La colección tiene D1 sobre reintentos, D2 sobre claves y D3 restringido. La CLI llama a answer(), que valida tipo y longitud antes de tokenizar. El filtro público precede a puntuación y trazas para no filtrar IDs privados. Es una política didáctica, no autorización por identidad: no hay login ni tenants.
La salida incluye status, text, source y trace. abstain pone text y source en null. La puntuación no tiene unidades; source es un ID. Los errores generan ValueError. No hay red, persistencia ni efectos laterales. Al añadir HTTP necesitarás autenticación, cuotas, plazos y redacción en esa frontera.
4. Derivar y calcular la puntuación
Q es el conjunto de términos de consulta y D el del documento. La puntuación es cobertura de Q, asimétrica: no penaliza palabras extra. “timeout retry” da 2/2=1 para D1 y 0/2=0 para D2. D3 se elimina, no recibe cero. El umbral 0.5 incluye la igualdad.
“timeout missing” devuelve D1 con 1/2 aunque parte de la consulta no está respaldada. “connection stalled” obtiene cero pese a su relación semántica. Son límites del método. Bajar el umbral aumenta retornos y coincidencias débiles; subirlo no resuelve sinónimos. Cobertura no es confianza ni corrección.
| ID | Q ∩ D | s(Q,D) |
|---|---|---|
| D1 | timeout, retry | 2/2 = 1 |
| D2 | ∅ | 0/2 = 0 |
5. Decisiones y límites
terms() usa minúsculas y letras ASCII y dígitos. No es un tokenizer de modelo ni segmenta chino o japonés, normaliza Unicode o elimina palabras vacías. Las cinco traducciones comparten datos ingleses para reproducir salidas. Un sistema multilingüe requiere análisis y evaluación específicos.
Con N documentos de longitud media L, se analizan N×L caracteres y se ordenan N puntuaciones en O(N log N). Sirve para tres documentos. Precalcula términos y después añade índice invertido, versionado con el texto. Un índice obsoleto puede apuntar a evidencia eliminada. Desempatar por ID estabiliza el resultado.
6. Ampliar después de comprender
BM25 añade frecuencia, rareza y longitud; la búsqueda densa añade similitud de representaciones. Ninguna prueba suficiencia. Al añadir un generador, usa solo texto permitido y conserva IDs estructurados. Las instrucciones documentales son datos no confiables; verifica citas. RAG completo requiere ingesta, actualización, acceso y suficiencia.
No añadas todos los frameworks. Usa la revisión RAG para elegir una mejora, el tutorial SDE para entender la llamada al modelo y SRE cuando necesites acciones con estado. Compara versiones con la misma tarea reservada para no confundir cambios de datos con mejoras.
7. Práctica y verificación
Crea una carpeta y guarda assistant.py y test_assistant.py. Usa Python 3.11 o posterior, sin dependencias, descargas ni claves. No hay aleatoriedad: no se necesita semilla. Ejecuta desde esa carpeta. Se incluye todo el código sin helpers ni datos remotos.
assistant.py
Descargar assistant.py"""Offline, deterministic retrieval baseline. Python 3.11+, standard library only."""
import json
import re
import sys
from dataclasses import dataclass
@dataclass(frozen=True)
class Document:
id: str
text: str
audience: str = "public"
DOCS = (
Document("D1", "Retry timeout requests with backoff."),
Document("D2", "Rotate access keys every month."),
Document("D3", "Private incident recovery password.", "restricted"),
)
def terms(text):
return set(re.findall(r"[a-z0-9]+", text.lower()))
def answer(query, docs=DOCS, threshold=0.5):
if not isinstance(query, str) or len(query) > 2000:
raise ValueError("query must be a string of at most 2000 characters")
if not 0 < threshold <= 1:
raise ValueError("threshold must be in (0, 1]")
if len({d.id for d in docs}) != len(docs):
raise ValueError("duplicate document ID")
q = terms(query)
candidates = []
for doc in docs:
if doc.audience != "public":
continue # Filter before ranking or constructing the trace.
score = len(q & terms(doc.text)) / len(q) if q else 0.0
candidates.append((score, doc.id, doc.text))
candidates.sort(key=lambda row: (-row[0], row[1]))
trace = [{"id": d, "score": s} for s, d, _ in candidates]
if not candidates or candidates[0][0] < threshold:
return {"status": "abstain", "text": None, "source": None, "trace": trace}
_, doc_id, text = candidates[0]
return {"status": "evidence", "text": text, "source": doc_id, "trace": trace}
if __name__ == "__main__":
query = " ".join(sys.argv[1:]) or "timeout retry"
print(json.dumps(answer(query), indent=2))
test_assistant.py
Descargar test_assistant.pyimport unittest
from assistant import answer, Document
class ContractTests(unittest.TestCase):
def test_known(self):
r = answer("timeout retry")
self.assertEqual((r["status"], r["source"]), ("evidence", "D1"))
self.assertEqual(r["trace"][0]["score"], 1.0)
def test_unknown_and_empty(self):
for query in ("", "quasar orbit", "日本語"):
self.assertEqual(answer(query)["status"], "abstain")
def test_no_private_trace(self):
r = answer("private incident recovery password")
self.assertEqual(r["status"], "abstain")
self.assertNotIn("D3", str(r))
def test_stable_tie(self):
docs = (Document("B", "retry"), Document("A", "retry"))
self.assertEqual(answer("retry", docs)["source"], "A")
def test_boundaries(self):
self.assertEqual(answer("timeout missing")["status"], "evidence")
self.assertEqual(answer("timeout missing extra")["status"], "abstain")
self.assertEqual(answer("retry", ())["status"], "abstain")
def test_invalid(self):
for query in (None, "x" * 2001):
with self.assertRaises(ValueError): answer(query)
with self.assertRaises(ValueError): answer("retry", threshold=0)
with self.assertRaises(ValueError): answer("retry", (Document("A", "x"), Document("A", "y")))
def test_lexical_failure_is_visible(self):
# Semantically similar wording is intentionally NOT solved by this baseline.
self.assertEqual(answer("connection stalled")["status"], "abstain")
if __name__ == "__main__":
unittest.main()
python3 assistant.py "timeout retry"
python3 assistant.py "quasar orbit"
python3 -m unittest -v test_assistant.py
Resultado: evidence, D1, puntuaciones
Mantén corpus, consultas y permisos. Cambia solo 0.5 a 0.75; después revierte y precalcula términos. Lo primero cambia conducta; lo segundo debería preservarla. Separa evidencia, retornos insuficientes y abstenciones. Ajusta en desarrollo y reporta en datos intactos: estas pruebas no prueban calidad de despliegue.
Ejercicios originales, no preguntas de empresas
¿Por qué 1 no prueba una respuesta?
Pista: cobertura frente a significado. “do not retry timeout requests” contiene los términos pero niega la acción. El método ignora negación e implicación; añade ese contraejemplo y comprueba respaldo.
¿Por qué filtrar antes de la traza?
Pista: el diagnóstico también sale del sistema. Ocultar texto no basta si se filtran IDs o scores. Filtrar antes los elimina de todos los canales, pero no implementa autorización autenticada.
¿Cómo acelerar sin cambiar respuestas?
Pista: trabajo repetido. Guarda conjuntos por versión inmutable y verifica puntuaciones y desempates idénticos. Invalida al cambiar documento o analizador. Mide después de demostrar equivalencia.
Rúbrica: 1 define; 2 calcula; 3 ejecuta y explica pruebas; 4 añade un fallo y comparación justa; 5 implementa una extensión independiente, conserva contrato y explica límites. No es certificación profesional.