Llamadas de IA para SDE: de HTTP a tokens
Siga una petición por tokenización, prefill, decode, KV, streaming y herramientas, con límites, presupuestos y código local.
Fuentes y versiones
En este artículo
Una llamada de IA es un programa distribuido
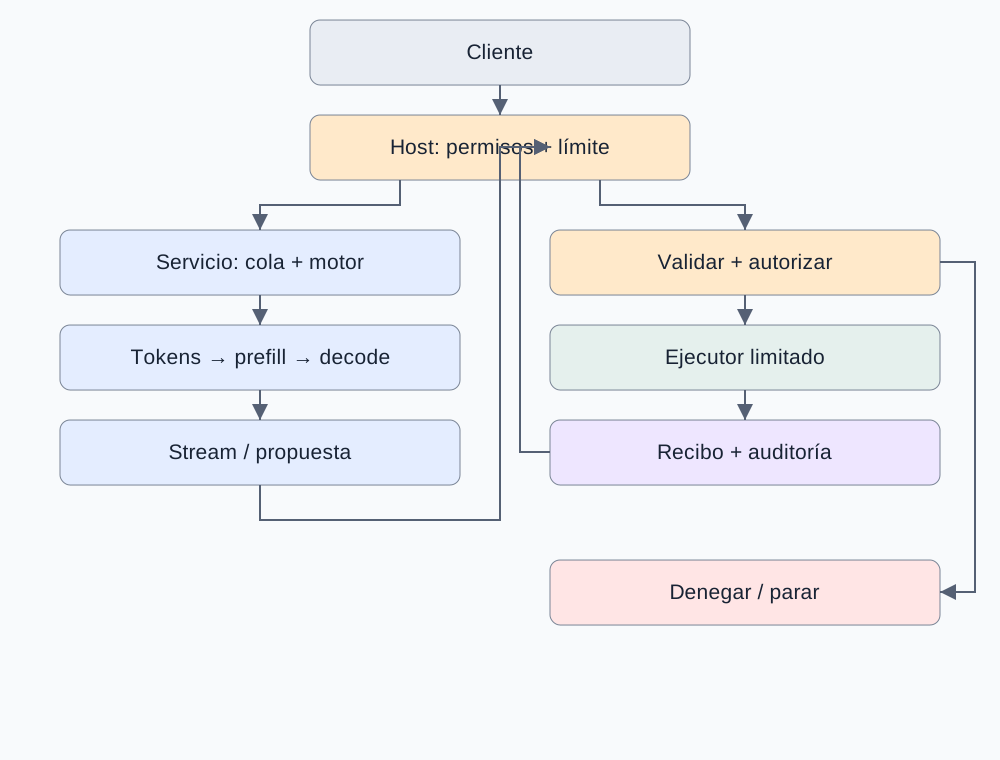
Un asistente SRE recibe una pregunta sobre un despliegue Pending. La aplicación obtiene una instantánea de Kubernetes y un runbook, envía evidencia al modelo y muestra el diagnóstico. Reparar exige un ejecutor autorizado aparte. Seguimos esa petición de extremo a extremo; es un diseño de referencia, no infraestructura privada de un proveedor.
Se necesitan conceptos backend: HTTP, TLS, autenticación, colas y tiempos de espera. Un timeout es una observación local. Añada tokens como IDs de vocabulario, pesos como parámetros aprendidos e inferencia como cálculo de una distribución condicional. Entrenar cambia pesos; la inferencia habitual no.
Distinga transporte completo, respuesta del modelo completa y tarea aceptada. Un diagnóstico convincente sin evidencia puede cumplir los dos primeros y fallar el tercero. Use el modelo para lenguaje y síntesis; código determinista para permisos, aritmética e invariantes.
En el límite del modelo se calcula pθ(y₁…yₙ | x), producto de probabilidades condicionales. θ son pesos fijos y x solo el contexto enviado. La salida es una decisión de decodificación, no una consulta transaccional a la verdad. Adjunte ID, fecha y evento exacto a la conclusión de GPU insuficiente.
La aplicación posee identidad, conversación y estado de tarea; el motor posee KV temporal; el ejecutor posee resultados duraderos. Perder KV no borra historial y perder una respuesta no revierte una acción. Recupere consultando al propietario del estado.
Del SDK a la admisión
El SDK serializa mensajes y opciones, autentica, envía HTTPS y convierte eventos en objetos. Normalmente no ejecuta el gran modelo localmente. Una ruta de referencia incluye ingreso, cuotas, router, admisión y cola; el orden varía. La clave del proveedor permanece en el backend.
Asigne ID lógico, deadline, límite de salida y configuración; cada intento lleva otro ID. Un semáforo acota concurrencia. Rechace trabajos que no puedan cumplir el plazo. Límites por peticiones y por tokens son distintos: pocos prompts largos pueden agotar tokens primero.
Un objeto de conversación puede almacenar historial; el transformer procesa el contexto ensamblado para esa inferencia. No suponga memoria de hechos omitidos ni inclusión automática de archivos. Conserve historial canónico, versiones de evidencia y versión de modelo cuando esté disponible.
Un pool reutiliza conexiones y evita parte de DNS/TCP/TLS. HTTP/2 multiplexa, pero no elimina cola ni cuota. Separe conexión, inactividad y plazo total; use reloj monótono y pase solo el presupuesto restante a cada salto.
Tres intentos del SDK y tres del worker pueden generar nueve llamadas. Coordine un dueño de reintentos y contabilice todos. De20s tras gastar8 quedan12 para espera y próximo intento. Un POST idéntico no es automáticamente seguro. [12]
| Capa | Entrada → salida | Responsabilidad |
|---|---|---|
| Aplicación | Pregunta + evidencia → petición | Identidad, privacidad, presupuesto |
| Inferencia | IDs → puntuaciones → IDs | Cola, memoria, generación |
| Transporte | Bytes → items completos | Framing, parcial, cancelación |
| Ejecutor | Acción autorizada → recibo | Permisos, idempotencia, auditoría |
De mensajes a tokens y tensores
Una plantilla añade delimitadores de rol y tokens especiales; el tokenizador produce IDs con vocabulario específico. Token no equivale a palabra, carácter o paquete. Cuente la entrada realmente templada; instrucciones del servicio y medios pueden añadir uso. [1]
En un decoder didáctico, IDs [B,T] consultan E [V,d] y producen X [B,T,d]. B es batch, T longitud, V vocabulario y d ancho. No es búsqueda web: son vectores aprendidos. Posición, atención, normalización, residuales y bloques feed-forward transforman esos vectores.
Los medios se decodifican y convierten en patches, características o tokens específicos, no en lectura del Base64 como prosa. Base64 aumenta bytes aproximadamente 4/3, pero eso no define facturación visual. Valide tipo, dimensiones, duración y límites aparte.
Un BPE didáctico convierte a,b,a,b en [ab,ab] si (a,b)→ab tiene prioridad. Otro vocabulario puede producir cuatro IDs. Los encoders reales tienen prioridades y reglas propias: un ID solo significa algo con su vocabulario y versión.
Con B2,T4,d8 hay64 elementos; V1000 implica8000 parámetros de tabla. Solo se seleccionan filas. Marcadores de chat, inicio duplicado o marcador assistant omitido cambian la secuencia aunque el texto visible sea igual. Enmascare padding.
Prefill: procesar antes de generar
Una cabeza causal genera Q,K,V [T,d_h]. QKᵀ es [T,T]; la máscara oculta el futuro. Dividir por √d_h controla la varianza bajo una aproximación de componentes independientes. Softmax por claves y multiplicación por V devuelve [T,d_h]. Las arquitecturas modernas varían. [2]
Prefill procesa posiciones conocidas en paralelo por capa con máscara causal. La última posición produce logits del primer token nuevo. La atención densa crece cuadráticamente con T, además de proyecciones y MLP. Kernels eficientes evitan almacenar toda la matriz sin eliminar toda la aritmética cuadrática.
Seleccione intervalo, eventos del scheduler y párrafos citados en lugar de enviar 100.000 líneas. RAG no amplía la ventana real. Un ejemplo sintético de 16.000 menos 2.000 instrucciones, 4.000 diálogo y 2.000 salida deja 8.000 tokens de evidencia.
Con
Proyecciones escalan aproximadamente T d² y productos de atención T² d; MLP añade ancho intermedio. Cuadrático no basta para predecir latencia. Tiling reutiliza memoria rápida y fusión evita escrituras intermedias; shapes, precisión, hardware y batch determinan velocidad.
Decode, muestreo y caché KV
Decode calcula, elige y añade un token repetidamente. La caché KV conserva claves/valores previos: el token nuevo calcula sus Q/K/V y consulta el pasado. Es estado numérico, no memoria factual. Depende de modelo, prefijo, posiciones y configuración. [3]
Una caché de atención completa ocupa aproximadamente 2 L B T H_kv d_h s bytes. Con32 capas,1 secuencia,8192 posiciones,8 cabezas KV,128 dimensiones y2 bytes, resulta1 GiB; excluye pesos, activaciones y sobrecostes. Longitudes variables exigen sumar posiciones; otras arquitecturas cambian la fórmula.
Logits son puntuaciones; temperatura escala antes de softmax y top-p retiene un núcleo y renormaliza. No controlan verdad. [2,1,0] a temperatura1 produce aproximadamente [0.6652,0.2447,0.0900]. Greedy no garantiza corrección ni reproducibilidad entre equipos. Un JSON truncado no es éxito.
En paso t: q_t[1,d_h], K/V[t,d_h], scores[1,t]. Añadir un token evita recalcular claves antiguas pero todavía lee el historial visible. La atención por paso crece con contexto; caching no elimina dependencia histórica. [13]
Con bloques de16 tokens, posición35 es bloque lógico2, offset3. Tabla[7,2,9] la sitúa en bloque físico9. Es ejemplo de direcciones, no layout fijo de vLLM. Prefijos compartidos requieren referencias y protección de escritura/tenant.
GPU: rendimiento y latencia no son lo mismo
El motor agrupa trabajo para amortizar lecturas de pesos. Continuous batching incorpora y retira secuencias entre iteraciones. Prompts y salidas largas compiten por cómputo y KV. Más tokens/s agregados puede empeorar la latencia individual. Limite tokens y memoria, no solo peticiones.
PagedAttention mapea bloques KV lógicos a físicos y reduce fragmentación. Prefix caching reutiliza estados compatibles y ahorra prefill repetido, no la generación de una respuesta nueva. No es caché de respuestas. Claves, expulsión, aislamiento y compatibilidad siguen importando. [4] [5]
A batch pequeño pueden dominar lecturas de pesos/KV; al crecer puede dominar cómputo. Paralelismo tensorial añade comunicación; separar prefill/decode transfiere KV. Cuantizar intercambia tamaño, kernels y calidad. Speculative decoding depende de aceptación y coste de verificación. No hay aceleración universal.
Un límite inferior es max(FLOPs/cómputo alcanzable,bytes/ancho de banda).8.000 millones de pesos×2
Cada iteración asigna tokens/KV, lanza kernels, recoge IDs y retira secuencias. Un prefill grande retrasa decode; fragmentarlo permite intercalar con costes. Autoscaling debe mirar espera, tokens activos y latencia, no solo utilización. Cargar pesos y calentar tarda.
Streaming es un protocolo sobre bytes
El stream contiene eventos sobre bytes. Lecturas TCP, chunks HTTP, eventos SSE, deltas JSON y tokens son fronteras distintas. Una lectura puede cortar UTF-8. Decodifique incrementalmente y analice eventos completos. EventSource no sustituye un POST JSON autenticado general; use fetch streaming o SDK. [6]
Use estados esperando, streaming, completo, fallido o cancelado. Puede haber error después de HTTP200. Cierre de socket sin señal de finalización no prueba éxito. Mantenga parcial como parcial. No ejecute argumentos JSON hasta completar, analizar y autorizar el item. Los nombres dependen del proveedor. [7]
Un proxy puede acumular la salida y ocultar streaming. Un lector lento exige backpressure o búfer acotado. Propague cancelación cuando sea posible; desconectar no prueba que cómputo o cobro terminaron. Separe límite de bytes, timeout de inactividad y deadline total.
Hay tres buffers: UTF-8 parcial, línea parcial y campos data del evento. CRLF cuenta una vez aunque se divida. Línea vacía despacha; varios data se unen con salto, después se analiza JSON. Acumule deltas por ID de item.
TCP no limita listas ilimitadas en la aplicación. Acote bytes en cola y respuesta total, defina política de consumidor lento y pause/cancele. El parser didáctico limita eventos; producción también limita respuesta y vida total.
Las herramientas crean el bucle del agente
En herramientas del cliente, el modelo propone nombre/argumentos; el host valida, ejecuta y devuelve observación. Herramientas alojadas por el proveedor tienen otra frontera. “He reiniciado” no prueba ejecución: vincule recibo, revisión y auditoría. El código o el modelo pueden determinar el siguiente paso. [8]
read_snapshot y search_runbook son lecturas autorizadas por tenant; restart_deployment exige capacidad y aprobación específicas. Un runbook es dato, no permiso. Un esquema garantiza forma, no verdad ni seguridad. Rechace herramientas desconocidas; no recurra a shell generado.
Acote rondas, herramientas, tiempo y gasto. Si una escritura expira, consulte estado duradero antes de reintentar. La idempotencia exige fingerprint y detección de conflicto, no solo UUID. Un retry HTTP no garantiza exactamente una mutación Kubernetes.
Use estados propuesto, validado, autorizado, ejecutando y éxito/fallo/desconocido. Permiso vincula identidad, namespace, recurso, acción y revisión. Revalide antes de escribir; cambios de recurso invalidan la decisión antigua.
Guarde intención antes del efecto, sin llamarlo transacción atómica con Kubernetes. Puede caer entre mutación y recibo. Recuperar exige ID y observación externa/deduplicación. Outbox local asegura entrega, no efectos exactly-once remotos.
Latencia, coste y responsabilidad
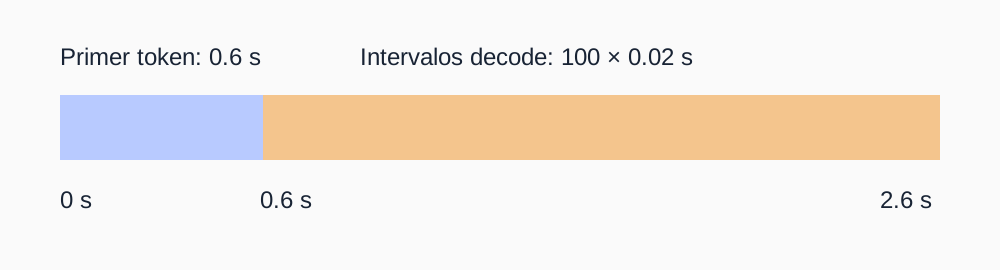
Mida TTFT, intervalo de tokens, duración total y éxito aceptado. TTFT incluye conexión, cola, prefill y entrega. Con N tokens e intervalo constante Δ:
Use un libro de costes. Precios hipotéticos de $2/$8 por millón para2.000 entrada/500 salida dan$0,008 sin herramientas/reintentos. No es una tarifa comercial. Razonamiento o medios pueden contabilizarse distinto. Divida coste total de intentos por tareas aceptadas.
Ante429 siga indicaciones y backoff acotado con jitter. Un esquema inválido exige corrección;5xx/desconexión solo se reintentan dentro de presupuesto/plazo. Registre IDs, modelo, uso, tiempos, motivo y recibos redactados. No guarde prompts ni claves por defecto. Separe cola/prefill, búfer y errores factuales.
En régimen estable
Trace tarea→intento→operación. Si no observa cola, registre TTFT cliente sin inventar tiempos internos. Compare percentiles en cohortes equivalentes de longitudes, modelo y caché. Respuestas cortas o más rechazos no prueban optimización.
Alcance y límites
Se explica generación textual autoregresiva. Embeddings devuelven vectores, rerankers puntuaciones y difusión/voz pueden seguir otras semánticas. Compatibilidad de interfaz no garantiza tokenizer, herramientas, aislamiento o motivos de parada iguales.
La frontera combina scheduling justo, movimiento/compresión KV, verificación especulativa y calidad con menor precisión. Persisten fiabilidad a largo plazo, frescura, prompt injection y evaluación reproducible ante cambios. Tokens baratos no resuelven autorización.
API gestionada delega operación pero oculta detalles; autohospedar transfiere capacidad, parches y seguridad al equipo. Decida por datos, carga, capacidad operativa y coste aceptado. Un adaptador no debe borrar semántica de rechazo o incompleto.
La meta es diagnosticar: qué dueño del estado sabe, qué medición discrimina hipótesis y qué es seguro repetir. Preserve incertidumbre. Las pruebas finales son invariantes pequeños, no evidencia suficiente de fiabilidad productiva.
Práctica y verificación
Ejecute el laboratorio local
Guarde lab.py y ejecute python3 lab.py con Python3.11+, solo biblioteca estándar. Sin azar ni semilla. Es un laboratorio de protocolo y aritmética, no red neuronal ni librería SSE de producción. Prueba todos los tamaños de fragmentos UTF-8 y tres saltos de línea; rechaza truncamiento y errores. delta/done/error son propios.
Descargar laboratorio Python"""Original teaching protocol, not a provider SDK. Python 3.11+, stdlib only.
No network, keys, GPU, or randomness. Feed arbitrary byte fragments.
Supports LF, CRLF and CR lines, UTF-8 BOM, comments and multiline data.
Does not implement EventSource reconnect, retry or Last-Event-ID semantics.
"""
import codecs
import json
import math
class Stream:
def __init__(self, max_event=65536):
self.decoder = codecs.getincrementaldecoder('utf-8-sig')('strict')
self.line = ''
self.data = []
self.event = ''
self.cr = False
self.size = 0
self.max_event = max_event
self.text = ''
self.state = 'waiting'
def feed(self, chunk):
self.consume(self.decoder.decode(chunk))
def consume(self, text):
for c in text:
if c == '\n' and self.cr:
self.cr = False
continue
self.cr = False
if c in '\r\n':
self.on_line(self.line)
self.line = ''
self.cr = c == '\r'
else:
self.line += c
if len(self.line.encode('utf-8')) > self.max_event:
raise ValueError('line too large')
def on_line(self, line):
if not line:
self.dispatch()
self.data, self.event, self.size = [], '', 0
return
if line.startswith(':'):
return
field, _, value = line.partition(':')
if value.startswith(' '):
value = value[1:]
if field == 'event':
self.event = value
elif field == 'data':
self.size += len(value.encode('utf-8')) + 1
if self.size > self.max_event:
raise ValueError('event too large')
self.data.append(value)
def dispatch(self):
if not self.data:
return
if self.state in {'completed', 'failed'}:
raise ValueError('data after terminal state')
payload = json.loads('\n'.join(self.data))
if not isinstance(payload, dict):
raise ValueError('payload must be object')
if self.event == 'delta':
if not isinstance(payload.get('text'), str):
raise ValueError('delta.text must be string')
self.text += payload['text']
self.state = 'streaming'
elif self.event == 'done':
if payload.get('reason') != 'stop':
raise ValueError('not an accepted completion')
self.state = 'completed'
elif self.event == 'error':
self.state = 'failed'
else:
raise ValueError('unknown teaching event')
def finish(self):
self.consume(self.decoder.decode(b'', final=True))
if self.line or self.data or self.event:
raise ValueError('unfinished event')
if self.state != 'completed':
raise ValueError('no successful completion')
return self.text
def softmax(logits):
if not logits or not all(math.isfinite(x) for x in logits):
raise ValueError('finite nonempty logits required')
m = max(logits)
values = [math.exp(x - m) for x in logits]
return [v / sum(values) for v in values]
def decode(raw, width):
s = Stream()
for start in range(0, len(raw), width):
s.feed(raw[start:start+width])
return s.finish()
def must_fail(raw):
try:
decode(raw, 1)
except (ValueError, UnicodeDecodeError):
return
raise AssertionError('invalid stream accepted')
if __name__ == '__main__':
text = 'Pending:GPU 不足'
wire = (': heartbeat\n\nevent: delta\ndata: ' +
json.dumps({'text': text}, ensure_ascii=False) +
'\n\nevent: done\ndata: {"reason":"stop"}\n\n')
raw = wire.encode()
for newline in ['\n', '\r\n', '\r']:
variant = b'\xef\xbb\xbf' + wire.replace('\n', newline).encode()
for width in range(1, len(variant)+1):
assert decode(variant, width) == text
must_fail(raw.split(b'event: done')[0])
must_fail(raw[:-1])
must_fail(b'event: error\ndata: {"error":"overloaded"}\n\n')
must_fail(b'event: delta\ndata: {bad}\n\n')
must_fail(b'event: delta\ndata: {"text":3}\n\n')
must_fail(b'\xff')
must_fail(raw + b'event: delta\ndata: {"text":"late"}\n\n')
try:
Stream(max_event=4).feed(b'data: oversized')
except ValueError:
pass
else:
raise AssertionError('size limit failed')
p = softmax([2,1,0])
assert abs(sum(p)-1) < 1e-12
assert all(abs(a-b)<1e-12 for a,b in zip(p,softmax([1002,1001,1000])))
kv = 2*32*1*8192*8*128*2
assert kv == 1024**3
cost = (2000*2+500*8)/1e6
assert abs(cost-0.008) < 1e-12
print(text)
print('softmax:', ', '.join(f'{x:.4f}' for x in p))
print(f'KV: {kv/1024**3:.1f} GiB; hypothetical cost: ${cost:.3f}')
print('PASS: byte fragmentation, newline variants, truncation, errors, bounds and arithmetic')
python3 lab.py
# Pending:GPU 不足
# softmax: 0.6652, 0.2447, 0.0900
# KV: 1.0 GiB; hypothetical cost: $0.008
# PASS: byte fragmentation, newline variants, truncation, errors, bounds and arithmetic
Mantenga los bytes y varíe solo fragmentación. Un parser JSON por lectura fallará sin cambiar el modelo. Sume una constante a logits: softmax debe ser igual. Quite done: texto parcial no es éxito. Son pruebas de protocolo/números, no calidad factual.
Preguntas originales y rúbrica
1. ¿Por qué HTTP200 no prueba éxito?
Pista: tres contratos. Admisión, finalización y aceptación son distintos. Detecte error/fin y valide evidencia.
2. ¿Por qué más contexto reduce capacidad?
Pista: KV y prefill. Calcule memoria por petición y reserve pesos/activaciones. Duplicar T duplica KV simple, no necesariamente latencia total.
3. ¿Puede reintentar un reinicio expirado?
Pista: efectos inciertos. Consulte registro, fingerprint y revisión; reproduzca resultado o rechace conflicto. Reconcilie antes de mutar otra vez.
4. ¿Caché de prefijo elimina decode?
Pista: tres cachés. KV es estado, prefijo reutiliza prefill y respuesta devuelve salida previa. Solo la última evita generar en un hit; requiere aislamiento y frescura.
Puntúe1–5: nombrar; definir contrato; explicar mecanismo; tratar fallo/contraejemplo; diseñar validación justa y observable con límites. No son preguntas reales atribuidas a empresas.
Referencias y continuación
- Chat templates — Hugging Face Transformers (main documentation, checked 2026-11-11)https://huggingface.co/docs/transformers/main/en/chat_templating
- Attention Is All You Need — Vaswani et al., first submitted 2017-06-12; arXiv v7 2023-08-02https://arxiv.org/abs/1706.03762v7
- KV cache strategies — Hugging Face Transformers (main documentation)https://huggingface.co/docs/transformers/main/en/kv_cache
- PagedAttention — Kwon et al., arXiv v1 2023-09-12https://arxiv.org/abs/2309.06180v1
- Automatic prefix caching — vLLM documentationhttps://docs.vllm.ai/en/latest/features/automatic_prefix_caching/
- Server-sent events — WHATWG HTML standardhttps://html.spec.whatwg.org/multipage/server-sent-events.html
- Streaming messages — Claude Platform documentationhttps://platform.claude.com/docs/en/build-with-claude/streaming
- Building effective agents — Anthropic, 2024-12-19https://www.anthropic.com/research/building-effective-agents
- Attention Is All You Need — PDF v7https://arxiv.org/pdf/1706.03762v7
- PagedAttention — PDF v1https://arxiv.org/pdf/2309.06180v1
- vLLM — source codehttps://github.com/vllm-project/vllm
- HTTP Semantics — RFC 9110, June 2022https://www.rfc-editor.org/rfc/rfc9110.html
- Caching — Hugging Face Transformers (main documentation)https://huggingface.co/docs/transformers/main/en/cache_explanation