前沿研究与工程实验
面向本科高年级至硕士:连接推理扩展、选择性状态空间和扩散语言模型。先解释机制,再设计能够推翻自己假设的实验。
本辑选择 2023–2026 年的代表性论文作为前沿方向的基础,不是截至今天的完整最新榜单。算例为原创教学计算,实验方案需自行实现。
Robot recovery: when retrying helps, and when it hides failure
Read Backtrack, DexPort and ViT-H through a practical lens: frozen policies, action labels, executable motion and bounded recovery. Includes a local state-machine experiment.
Self-improving agents: reward gains are not capability gains →
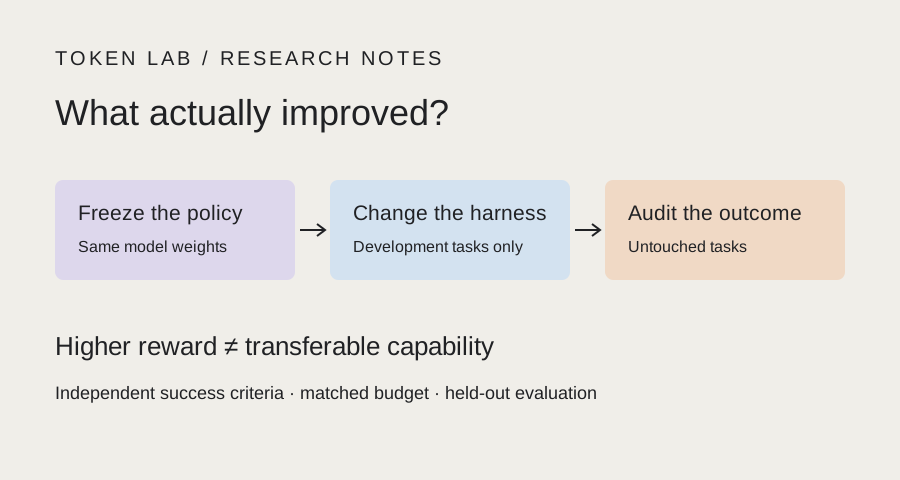
A research reading guide and local experiment on adaptive harnesses, reward collapse, frozen-policy comparisons and held-out evaluation.
From LLM Calls to Agent Harnesses →
英文阅读摘要与原创实验:上下文、工具权限、预算、检查点与重试。附七项浏览器本地验证。
测试时计算:搜索、验证与预算 →
先修:概率、评测与推理成本。理解增加尝试何时有效,以及验证器何时成为瓶颈。
选择性状态空间:Mamba 与序列记忆 →
先修:线性代数、递推与注意力。比较压缩状态和显式 token 检索。
扩散语言模型:掩码与迭代解码 →
先修:交叉熵、Transformer 与生成建模。理解 LLaDA 式掩码生成,不把并行性直接当作速度。
相关论文精读
支撑当前工程与研究方向的代表性论文,不按发表时间排名。
DeepSeek-R1:奖励、推理与证据边界 →
分开研究 R1-Zero 和 R1,再设计推理提升的受控检验。本文固定解读 arXiv v1。
LLM-as-a-judge:先评估评审者 →
区分答案偏好与正确性,观察顺序效应如何改变胜率。
DPO:通过相对对数概率学习偏好 →
推导成对偏好 margin,并观察 β 对单个偏好样本的影响。
FlashAttention:除了 FLOPs,还要算数据搬运 →
理解不保存注意力矩阵为何重要,并逐块重建 softmax。
统一实验报告规范
记录论文版本、模型与数据版本、种子、硬件、预算、基线、消融和置信区间。分开报告论文主张、自己的测量与仍未验证的猜想。先固定假设与停止规则,再开始调参。