Comprender los agentes de IA: del bucle de control a la infraestructura
Siga un incidente de latencia tras un despliegue: delimitar la tarea, reunir evidencia, controlar herramientas, tratar fallos y entregar conclusiones antes de calcular los costes del agente.
Fuentes y versiones
En este artículo
1. 14:02: definir el resultado esperado
Escenario sintético original, no datos reales: a las 14:00 el tenant A despliega checkout r17 en un 10% de instancias. A las 14:02 el p95 de cinco minutos pasa de 120 a 420 ms con volumen total aproximadamente estable. El operador pregunta si la versión causó el problema y si debe revertirla. Confirmar anomalía, atribuir causa y autorizar una operación son tareas diferentes. El agente promete un informe con pruebas, no reparación automática.
Un agente elige acciones a partir de observaciones, objetivos y restricciones, y utiliza sus resultados para decidir el siguiente paso. El modelo propone decisiones; el harness construye contexto, adapta herramientas, impone restricciones y coordina verificación y corrección. El entorno contiene archivos, servicios y estado empresarial. Compartir un proceso no elimina estas fronteras. Un informe predecible suele necesitar un flujo determinista, no autonomía.
Se necesitan conocimientos concretos: un timeout HTTP no demuestra que el servidor no ejecutó nada; JSON schema valida estructura, no permisos; memoria de proceso, registro persistente y estado externo son distintos. Conviene entender medias, percentiles y presupuestos. El modelo puede tratarse inicialmente como componente probabilístico; para la caché se necesita además comprender claves y valores de attention.
Cadena de evidencia del incidente sintético
| Pregunta | Evidencia necesaria | Conclusión permitida |
|---|---|---|
| ¿Empeoró la latencia? | Percentiles, ventana y volumen comparables | Confirmar antes de atribuir |
| ¿Se relaciona con r17? | Métricas por revisión y despliegue | Hipótesis asociada a la versión |
| ¿Es el pool? | Configuración activa y esperas | Candidato, no exclusión de alternativas |
| ¿Puede revertir? | Permisos y aprobación | Recomendar y transferir |
2. Primera decisión: convertir la pregunta en investigación
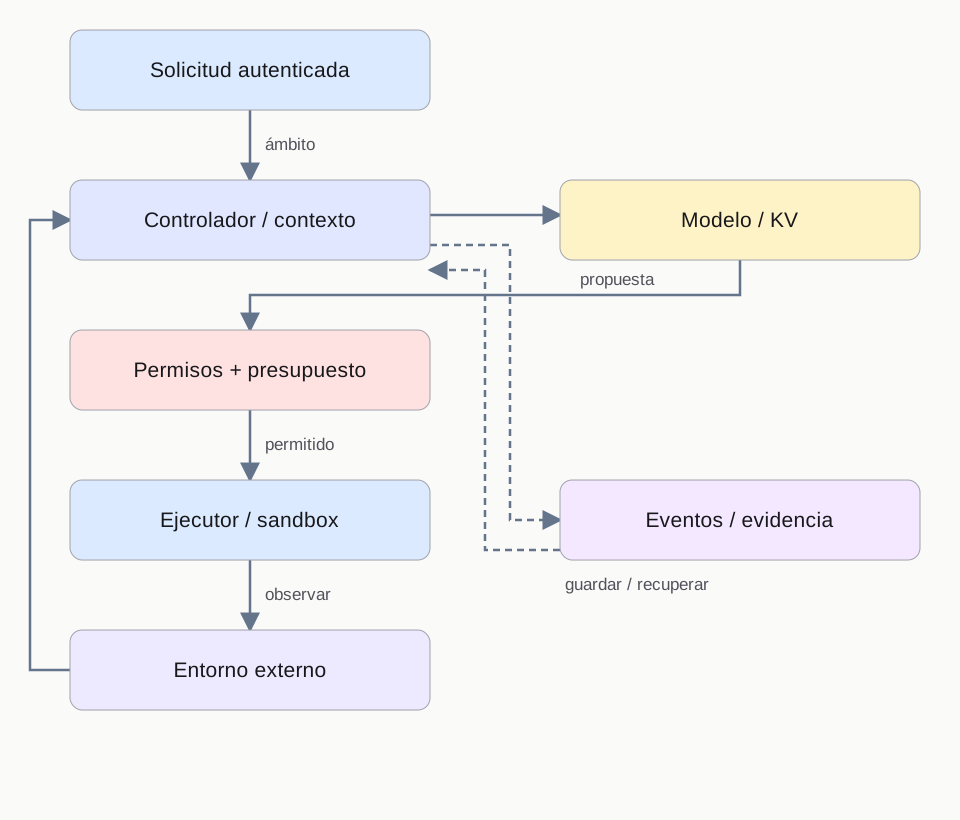
El controlador crea incident-017 para tenant A, checkout, 13:55–14:02 y permisos de lectura. El p95 global no identifica instancias afectadas. Propone dos lecturas independientes: latencia por revisión e historial de despliegue. La salida es una propuesta, todavía no evidencia; primero debe validarse su ejecución.
La entrada obtiene tenant, servicio e intervalo desde la identidad autenticada y asigna task_id. El controlador recupera pasos terminados y combina políticas, definiciones de herramientas, pregunta, estado y evidencia. El modelo propone get_metrics o get_changes, o responde cuando dispone de pruebas. No puede concederse permisos ni convertir instrucciones de un documento en política del sistema.
Antes de ejecutar se verifican herramienta permitida, tipos, ámbito, presupuesto, plazo y aprobación. El resultado registra estado, ID de llamada, fecha de los datos, fuente y truncamiento; alimenta la siguiente decisión. Un timeout significa ausencia de evidencia, no métricas normales. Al agotar presupuesto o no poder avanzar, el resultado debe declarar que está incompleto.
Use flujos para pasos conocidos y decisiones del modelo para bifurcaciones dependientes de observaciones. Identidad, aprobación y archivo permanecen deterministas. Defina estados, contratos, parada y recuperación antes del framework: una biblioteca no resuelve una semántica ambigua.
Elegir la orquestación
| Patrón | Cuándo usarlo | Coste o límite |
|---|---|---|
| Flujo fijo | Pasos conocidos | Predecible; necesita fallback explícito |
| Un agente | La evidencia decide el siguiente paso | Limitar rondas, herramientas y parada |
| Varios agentes | Evidencia separable | Coordinar estado; duplicación no implica independencia |
3. Antes de ejecutar: comprobar autoridad
Ante read_metrics(
La descripción enseña a proponer una llamada; la política decide si el usuario puede ejecutarla. MCP normaliza descubrimiento e invocación, pero no garantiza aislamiento, mínimo privilegio, restricciones de red o aprobación vinculada. Con muchas herramientas, recupere un catálogo y cargue pocas schemas relevantes; todas pasan por la misma puerta de ejecución.
Separe read_metrics, read_changes y restart_service. Incluso las lecturas pueden filtrar logs sensibles: limite recursos, campos, tiempo, tamaño y destinos. Una aprobación de escritura debe vincular objetivo, acción, hash de argumentos, caducidad y operation_id. Cambiar argumentos invalida la aprobación.
Prompt injection intenta transformar datos no fiables en instrucciones. Un manual malicioso puede pedir credenciales. Advertir al modelo no basta: el ejecutor rechaza capacidades no permitidas, el sandbox limita archivos y red, y los secretos no entran al contexto. Los detectores aportan señales; código independiente impone reglas y guarda evidencia. Las escrituras requieren intervención humana y recuperación definidas.
4. Primeras pruebas: documentos frente a hechos
E1 sintética muestra p95 de 420 ms en r17 y 125 ms en r16 en la misma ventana. E2 identifica un cambio del pool de conexiones. Un manual antiguo indica límite 50; la configuración activa E3 indica 10. El manual orienta, la configuración aporta un hecho y la comparación aporta asociación. Falta observar espera de adquisición de conexiones antes de concluir el mecanismo.
Separe eventos de la tarea, memoria entre sesiones y documentos citables. Tienen políticas diferentes de acceso, retención y actualización. Un documento con timeout por defecto de 30 segundos puede estar obsoleto; la configuración activa es evidencia directa. Recordar que un usuario suele permitir reinicios no autoriza el actual.
La ingesta RAG preserva versión, procedencia, fecha y ACL. Aplique permisos antes de recuperar y reordenar fragmentos. Mantenga identificadores y vincule afirmaciones verificables a pruebas. Relevancia no implica suficiencia: el manual enumera causas posibles y las métricas muestran si corresponden al incidente. Sin esa conexión, declare una hipótesis.
Registre quién aportó cada recuerdo, cuándo, sobre quién y qué dato anterior reemplaza. Los hechos estructurados permiten cambios parciales; las narraciones conservan contexto pero duplican información. Vectorizarlo todo no resuelve identidad ni vigencia. El borrado debe alcanzar índices derivados y cachés.
5. Continuar: conservar lo importante
En la tercera ronda hay demasiados registros. El estado compacto conserva ventana y grupos de E1, cambio E2, configuración E3 y la ausencia explícita de datos de espera. Separe hechos de hipótesis y mantenga IDs originales. El resumen permite elegir la próxima consulta, no crea evidencia. Introducimos un fallo precisamente en esa consulta pendiente.
Cada llamada recibe una vista limitada. El prefijo estable contiene rol, políticas y schemas; el sufijo cambia con observaciones, hipótesis descartadas y presupuesto restante. Volcar todos los logs aumenta cómputo y oculta señales. Filtre de forma determinista servicio y tiempo, y devuelva agregados, muestras y referencias a registros originales.
La compresión conserva objetivo, restricciones, IDs de evidencia, intervalos, fallos y alcance de aprobaciones. Un resumen pierde información: mantenga los eventos originales y vuelva a consultar estado actual antes de acciones importantes. Un manual explica recomendaciones, pero no concede permiso del usuario.
Un prefijo estable favorece la caché, pero políticas y contratos nuevos deben actualizarse aunque reduzcan aciertos. La reutilización depende de tokens y posiciones exactos, modelo/adaptador y aislamiento del servidor, no de similitud semántica. Modificar el inicio del historial puede invalidar estados posteriores; contexto e infraestructura están conectados.
6. Timeout: avanzar sin inventar evidencia
La lectura op-w1 termina en timeout: ausencia no significa cero ni normalidad. Una lectura puede reintentarse dentro del plazo y presupuesto, con operación lógica e intento separados. En la continuación sintética E4 muestra más espera en r17, no en r16. Si también falla, entregue asociación con la versión y mecanismo no confirmado. El código local demuestra la rama incomplete; no implementa consultas reales de monitorización.
Persista task_id, operation_id lógico y attempt_id por separado. Propuestas repetidas, mensajes duplicados y reintentos no son el mismo evento. Reutilice resultados guardados. Si una acción remota terminó antes de un fallo local, consulte el destino en vez de asumir que no ocurrió.
El diseño restaura el controlador desde eventos y usa claves de idempotencia admitidas por el destino. Un resultado ambiguo permanece unknown hasta reconciliación o revisión. Una transacción local no puede confirmar atómicamente una API externa. Defina respuestas tardías, cancelación, leases y timeouts: dejar de esperar no detiene necesariamente la acción remota.
Snapshots de archivos, procesos, conversaciones y KV son checkpoints diferentes. Restaurar un repositorio no revierte una actualización de base de datos; reconstruir conversación no garantiza la misma decisión. Separe error de respuesta, fallo ambiental y denegación de permisos para no atribuir todo al modelo.
7. Seis rondas: calcular el trabajo de inferencia
Pausemos para calcular: seis llamadas con 4000 tokens de entrada y 300 de salida esconden mucho más trabajo que el informe final. Mantener E1–E4 y schemas estables ayuda al contexto y caché. Conservar una configuración E3 obsoleta para conseguir aciertos sería incorrecto. Los cálculos siguientes explican la optimización después de asegurar evidencia válida.
Una llamada incluye cola, prefill y decode token a token. Prefill procesa entrada y crea estado; decode lo amplía. Un agente repite llamadas y añade resultados, por lo que la longitud de la respuesta final no representa el trabajo total. Durante una espera de herramienta, la GPU puede atender otros clientes mientras memoria del entorno y KV siguen ocupados.
Para un Transformer de atención completa, multiplique capas L, secuencias B, longitud T, cabezas KV H_kv, dimensión d_h y bytes b, por dos para K y V.
Seis llamadas con 4000 tokens de entrada y 300 de salida suman 24000 y 1800. Si las últimas cinco reutilizan exactamente 3000 tokens de prefijo, pueden evitar recomputar 15000 tokens. La entrada lógica no disminuye y la facturación depende del proveedor. Es un ejemplo sintético, no una medición de aceleración ni una reducción proporcional de latencia total.
I_r y O_r cuentan tokens de entrada/salida de la ronda r; R es el número de llamadas. I y O son totales lógicos antes de descuentos por caché.
8. Muchas alertas: encontrar el límite de capacidad
Con dos investigaciones admitidas por segundo y entornos residentes 30 segundos, esperar no elimina memoria. Añadir CPU puede no reducir la cola. Planifique cómputo activo, estado residente, concurrencia del modelo y cuotas externas conjuntamente: throughput del modelo no equivale al de la plataforma.
El controlador conecta dos rutas: modelos sobre aceleradores y herramientas sobre CPU, memoria, archivos y cuotas externas. Cada ruta puede esperar a la otra. El objetivo es completar tareas correctas dentro de plazos, no maximizar aisladamente utilización de GPU.
Ejemplo original: dos tareas por segundo, entornos de 30 segundos y 0,5 GiB por entorno implican 60 entornos y 30 GiB de media en régimen estable. Tres CPU-segundos por tarea equivalen a seis núcleos ocupados. Una máquina de ocho núcleos y 16 GiB sigue siendo insuficiente: sin sobrecostes aloja 32 entornos, unos 1,07 trabajos por segundo. Con llegadas de dos, la cola no puede ser estable.
Crear entornos bajo demanda, liberar recursos reconstruibles, usar pools calientes y limitar admisión tienen compromisos. Los pools reducen arranque pero consumen memoria; descargar KV libera GPU pero añade transferencias; batching aumenta throughput pero puede perjudicar interacción. En lotes dependientes importan ruta crítica y makespan. Priorizar cadenas largas requiere envejecimiento o cuotas para evitar inanición.
λ son llegadas admitidas por segundo; T es residencia en segundos y N entornos residentes medios. M(t) se mide en GiB y su integral en GiB·s. Little requiere estabilidad a largo plazo; no demuestra estabilidad bajo sobrecarga.
9. Entregar, cerrar y después mejorar
El informe cita E1–E4, propone el cambio del pool como candidato, declara diferencias de tráfico y dependencias todavía no descartadas, y solicita evaluación humana del rollback según el proceso de cambios. El agente de lectura termina. Supongamos que un humano revierte y el p95 comparable vuelve a 130 ms: refuerza asociación, no prueba causalidad sin factores de confusión. Archive pruebas y acciones humanas; solo los fallos identificados justifican múltiples agentes o aprendizaje.
Varios agentes ayudan si el trabajo se divide, las pruebas se obtienen independientemente y la integración tiene coste limitado. Métricas e historial de cambios pueden analizarse en paralelo y contrastarse después. En tareas sencillas, más roles añaden llamadas y conflictos. Dos agentes que citan el mismo documento incorrecto no son evidencia independiente.
Distinga actualización de conocimiento, cambios de prompts/herramientas, código y entrenamiento. Adaptarse en contexto no cambia parámetros; guardar trazas exitosas no demuestra mejora general. Versione candidatos, presupuestos, tareas y rollback. No incluya respuestas reservadas en entrenamiento. Un modelo que crea y juzga sus soluciones produce un bucle sesgado; hacen falta resultados independientes y revisión humana.
Empiece con baseline determinista y después decisiones acotadas. Problemas abiertos: asignación de crédito a largo plazo, recuperación de acciones irreversibles, generalización entre entornos, errores acumulados de memoria y autonomía útil bajo presupuesto. Una afirmación de auto-mejora debe identificar la capa modificada, ganancias en tareas reservadas y costes o riesgos añadidos.
10. Práctica y verificación
Implemente primero este harness determinista. Las respuestas sintéticas prueban ámbito, replay, presupuesto y evidencia incompleta. Python 3.11+, solo biblioteca estándar, sin dependencias ni aleatoriedad; no se necesita semilla. Descargue y ejecute localmente.
agent-book-harness.pypython3 agent-book-harness.pyscope=passed replay=passed budget=passed timeout=incomplete
kv_gib=1.0 environments=60 memory_gib=30.0Python · agent-book-harness.py
"""Python 3.11+, standard library only; deterministic harness, NOT an LLM.
No network, secrets, shell, production writes or random sampling.
Run: python3 agent-book-harness.py
"""
from dataclasses import dataclass, field

@dataclass
class Harness:
    tenant: str = 'A'
    service: str = 'checkout'
    remaining: int = 4
    events: list = field(default_factory=list)
    results: dict = field(default_factory=dict)

    def call(self, operation_id, tool, tenant, service, *, timeout=False):
        # Authorization precedes result lookup: cached data is not public.
        if tenant != self.tenant or service != self.service:
            raise PermissionError('scope')
        if tool not in {'metrics', 'changes'}:
            raise PermissionError('capability')
        identity = (tool, tenant, service)
        if operation_id in self.results:
            previous_identity, result = self.results[operation_id]
            if previous_identity != identity:
                raise ValueError('operation ID reused for different arguments')
            return result
        if self.remaining == 0:
            raise RuntimeError('budget')
        self.remaining -= 1
        if timeout:
            result = {'status': 'timeout', 'evidence': None}
        else:
            result = {'status': 'ok', 'evidence':
                      {'id': 'metric-1', 'p95_ms': 420} if tool == 'metrics'
                      else {'id': 'change-1', 'revision': 'r17'}}
        self.events.append((operation_id, identity, result))
        self.results[operation_id] = (identity, result)
        return result


def scripted_investigation(h, timeout=False):
    # A model adapter would propose these actions; the gate must stay outside it.
    metrics = h.call('op-m', 'metrics', 'A', 'checkout', timeout=timeout)
    changes = h.call('op-c', 'changes', 'A', 'checkout')
    if any(x['status'] != 'ok' for x in (metrics, changes)):
        return {'status': 'incomplete', 'evidence': []}
    return {'status': 'observed', 'evidence': [metrics['evidence'], changes['evidence']],
            'conclusion': 'Revision and latency observed; causation not established.'}


def raises(error, action):
    try:
        action()
    except error:
        return
    raise AssertionError(f'expected {error.__name__}')


def main():
    h = Harness()
    answer = scripted_investigation(h)
    assert answer['status'] == 'observed' and len(h.events) == 2
    # Replay returns recorded result without consuming another budget unit.
    h.call('op-m', 'metrics', 'A', 'checkout')
    assert h.remaining == 2 and len(h.events) == 2
    raises(PermissionError, lambda: h.call('op-m', 'metrics', 'B', 'checkout'))
    raises(PermissionError, lambda: h.call('op-write', 'restart', 'A', 'checkout'))
    raises(ValueError, lambda: h.call('op-m', 'changes', 'A', 'checkout'))
    raises(RuntimeError, lambda: Harness(remaining=0).call('x', 'metrics', 'A', 'checkout'))
    assert scripted_investigation(Harness(), timeout=True)['status'] == 'incomplete'
    kv = 2 * 32 * 1 * 8192 * 8 * 128 * 2
    assert kv == 1024**3
    environments = 2 * 30
    memory_gib = environments * 0.5
    assert environments == 60 and memory_gib == 30
    assert 6 * 4000 - 5 * 3000 == 9000
    print('scope=passed replay=passed budget=passed timeout=incomplete')
    print(f'kv_gib={kv / 1024**3:.1f} environments={environments} memory_gib={memory_gib:.1f}')
    print('Synthetic control checks only; no model-quality or sandbox benchmark.')

if __name__ == '__main__':
    main()
Es una implementación de control, no un agente SRE desplegado ni una simulación de inteligencia. El registro en memoria no sobrevive a fallos; timeout es un resultado inyectado, no un plazo que termine procesos. No hay sandbox real ni escrituras. Producción necesita persistencia, identidad autenticada, plazos reales, concurrencia, idempotencia del destino y adaptador de modelo separado.
Comparación justa: mismos modelo, tareas, pruebas, permisos y presupuesto total de tokens/tiempo. Compare flujo fijo y agente acotado, después varios agentes si el trabajo se divide. Informe éxito, afirmaciones sin apoyo, denegaciones, latencia p50/p95 y coste total por éxito, incluyendo intentos fallidos. Repita en tareas reservadas e indique tamaño de muestra. Las aserciones locales no miden inteligencia.
Preguntas originales, no entrevistas reales de empresas
¿Por qué un timeout duplica un reinicio?
Pista
Separe ejecución remota y confirmación.
Respuesta y análisis
La acción puede haber terminado. Consulte estado y use idempotencia del destino; unknown no significa no ejecutado.
¿Por qué comprimir contexto puede aumentar latencia?
Pista
Localice el primer token cambiado.
Respuesta y análisis
Puede invalidar el prefijo y repetir prefill. Compare ahorro, reutilización perdida, coste de compresión y conservación de evidencia.
¿Por qué 30 GiB pero solo seis núcleos?
Pista
Separe residencia y tiempo activo.
Respuesta y análisis
2×30=60 entornos; 60×0,5=30 GiB. CPU: 2×3=6 core-segundos por segundo. La espera conserva estado.
¿Dos agentes de acuerdo prueban corrección?
Pista
Compruebe independencia de las fuentes.
Respuesta y análisis
Pueden compartir errores. Verifique resultados y evidencia independiente, con baseline de un agente al mismo presupuesto.
Puntuación 1–5: conceptos; flujo normal; unidades y cálculos; fallos de ámbito, timeout y replay; comparación justa con recuperación y compromisos medibles.
Predecir, comprobar y conservar evidencia
Antes de revelar la respuesta, predice un resultado. Después registra diferencias y una prueba de transferencia. Se guarda localmente y se comparte entre idiomas.
Abrir cuaderno / exportar / borrar →El alcance de revisión matemática se registra por lección. No certifica reproducción empírica del artículo; anota posibles errores. Alcance de revisión
11. Atribución, versiones y lecturas
Síntesis original de Token Lab basada en los libros de Bojie Li Understanding AI Infra: Quantitative Analysis and System Design y Understanding AI Agent: Design Principles and Engineering Practice. El enlace proporcionado corresponde a Infra. Ambos repositorios declaran Apache-2.0. Se enlazan versiones fijadas. Escenario SRE, figura, cifras y Python son originales; no es traducción íntegra, edición oficial ni aval del autor.
- Repositorio AI Infrahttps://github.com/bojieli/ai-infra-book
- Repositorio AI Agenthttps://github.com/bojieli/ai-agent-book
- Infra: capítulos 3, 8 y 11https://github.com/bojieli/ai-infra-book/tree/3bdcb4fcab73010eeaccf31cc10a8242a895d82e/manuscripts
- Agent: capítulos 1–4, 7, 9 y 10https://github.com/bojieli/ai-agent-book/tree/dbc046eb896ac4e39aa19c7774c8bf49583b89a6/book
- Leer AI Infrahttps://bojieli.github.io/ai-infra-book/
- Leer AI Agenthttps://bojieli.github.io/ai-agent-book/
AI Infra §3https://github.com/bojieli/ai-infra-book/blob/3bdcb4fcab73010eeaccf31cc10a8242a895d82e/manuscripts/03-%E6%8E%A8%E7%90%86%E4%B8%8E%E8%AE%AD%E7%BB%83%E8%B4%9F%E8%BD%BD.md · AI Infra §8https://github.com/bojieli/ai-infra-book/blob/3bdcb4fcab73010eeaccf31cc10a8242a895d82e/manuscripts/08-%E6%8E%A8%E7%90%86%E4%BC%98%E5%8C%96.md · AI Infra §11https://github.com/bojieli/ai-infra-book/blob/3bdcb4fcab73010eeaccf31cc10a8242a895d82e/manuscripts/11-%E8%B5%84%E6%BA%90%E8%B0%83%E5%BA%A6%E4%B8%8E%E8%BF%90%E8%A1%8C%E7%8E%AF%E5%A2%83.md · AI Agent §1https://github.com/bojieli/ai-agent-book/blob/dbc046eb896ac4e39aa19c7774c8bf49583b89a6/book/chapter1.md · AI Agent §2https://github.com/bojieli/ai-agent-book/blob/dbc046eb896ac4e39aa19c7774c8bf49583b89a6/book/chapter2.md · AI Agent §3https://github.com/bojieli/ai-agent-book/blob/dbc046eb896ac4e39aa19c7774c8bf49583b89a6/book/chapter3.md · AI Agent §4https://github.com/bojieli/ai-agent-book/blob/dbc046eb896ac4e39aa19c7774c8bf49583b89a6/book/chapter4.md · AI Agent §7https://github.com/bojieli/ai-agent-book/blob/dbc046eb896ac4e39aa19c7774c8bf49583b89a6/book/chapter7.md · AI Agent §9https://github.com/bojieli/ai-agent-book/blob/dbc046eb896ac4e39aa19c7774c8bf49583b89a6/book/chapter9.md · AI Agent §10https://github.com/bojieli/ai-agent-book/blob/dbc046eb896ac4e39aa19c7774c8bf49583b89a6/book/chapter10.md
AI Infra · Apache-2.0https://github.com/bojieli/ai-infra-book/blob/3bdcb4fcab73010eeaccf31cc10a8242a895d82e/LICENSE · AI Agent · Apache-2.0https://github.com/bojieli/ai-agent-book/blob/dbc046eb896ac4e39aa19c7774c8bf49583b89a6/LICENSE
