Aprender IA desde cero: una ruta de 52 semanas, de cursos a proyectos
Una ruta práctica de Python, matemáticas, aprendizaje automático, modelos de lenguaje, aprendizaje por refuerzo y agentes, con tareas y criterios de dominio.
Fuentes y versiones
En este artículo
Cómo encajan los conocimientos
Una lista indica qué existe; una ruta explica qué estudiar después, qué conocimientos presupone y qué podrá construir el estudiante. Este plan independiente de Token Lab combina materiales de Stanford, MIT, Berkeley, Harvard y Cornell con educadores independientes y cursos abiertos de ingeniería. No constituye un título universitario ni implica el respaldo de esas instituciones.
Reserve 10–15 horas semanales durante 52 semanas: unas 520–780 horas. Ese presupuesto cubre clases centrales seleccionadas y proyectos acotados, no todos los cursos y tareas del catálogo. Un principiante absoluto puede necesitar 18–24 meses. Un SDE experimentado puede acortar Python, pero no debe omitir probabilidad, razonamiento numérico ni diseño experimental. La profundidad investigadora requiere más tiempo.
Material público no significa matrícula, corrección, certificados o cómputo gratuitos. Algunas grabaciones actuales de Stanford requieren matrícula, aunque hay ediciones oficiales anteriores abiertas. Code in Place funciona por convocatorias. Coursera puede cobrar por acceso o certificados; GPU y API externas pueden generar costes. Token Lab no realiza llamadas de pago para esta ruta.
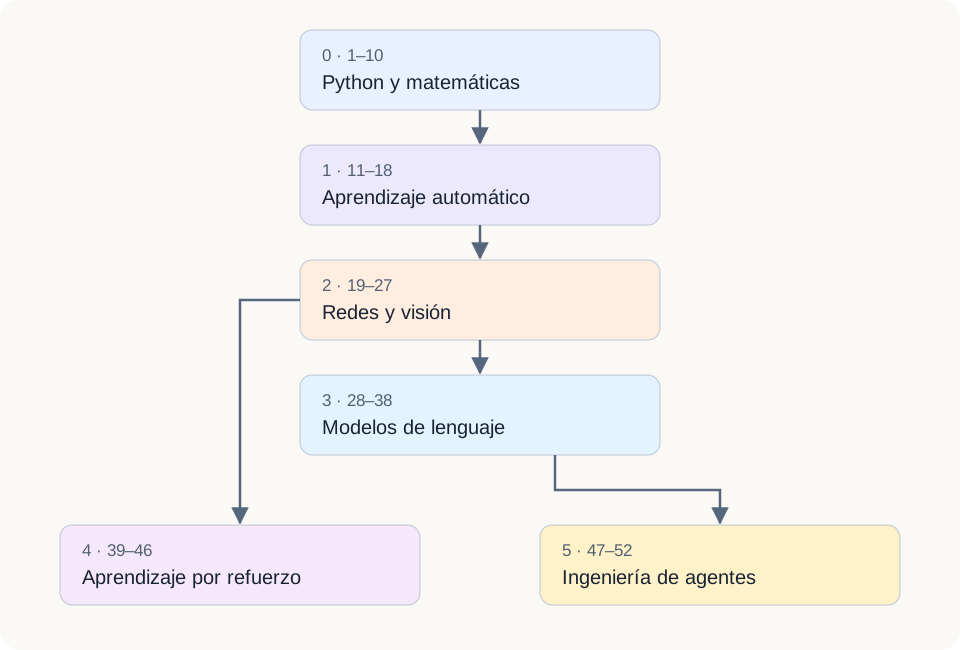
Un año realista y una rutina semanal
Elija un curso principal por materia. Las alternativas ayudan con una carencia concreta: intuición, derivaciones más lentas, implementación o especialización. Ver tres introducciones solapadas suele retrasar la primera implementación independiente. Mantenga los recursos adicionales en reserva hasta poder identificar la necesidad.
En una semana de 12 horas, dedique 3 a clases y notas, 2 a reconstruir derivaciones, 5 a implementar y depurar y 2 a un informe técnico. Pause antes de una demostración y prediga el siguiente paso. Registre la suposición equivocada, el contraejemplo mínimo y la modificación; revise ese registro tras una semana y un mes.
Semanas 1–10: fundamentos; 11–18: ML; 19–27: redes; 28–38: lenguaje; 39–46: RL; 47–52: agentes. Es un presupuesto, no un plazo obligatorio. Si falta terminar un proyecto, reduzca optativas antes de eliminar práctica. Respete el código de honor y no publique soluciones de tareas activas cuando esté prohibido.
Etapa 0 · Python y lenguaje matemático
Python permite expresar cálculos reutilizables, lotes de datos y pruebas. Use CS50P para autoestudio o Code in Place cuando haya una convocatoria adecuada. Añada archivos, excepciones, entornos virtuales, Git y comandos reproducibles; después, broadcasting de NumPy y tensores de PyTorch. Saber sintaxis no equivale a dominar computación numérica.
Visualice matrices como transformaciones con 3Blue1Brown y estudie en MIT 18.06 sistemas lineales, espacio generado, rango, proyecciones, autovectores y valores singulares. ENGR108 es una alternativa aplicada basada en Boyd–Vandenberghe, pero el curso actual usa Julia. Traduzca las ideas matemáticas: no espere cuadernos Python ni un temario idéntico solo por la continuidad del número de curso.
La probabilidad describe incertidumbre; el cálculo describe sensibilidad a parámetros. CS109 o Stat 110 aportan probabilidad condicional, Bayes, esperanza, varianza y muestreo. Las animaciones de cálculo dan intuición, pero también hay que derivar parciales y la regla de la cadena. La entropía cruzada procede de probabilidades y la retropropagación aplica esa regla a un grafo de cálculo.
Si X tiene n filas y d características, w tiene d pesos y y tiene n objetivos, Xw produce n predicciones. El gradiente del error cuadrático medio con factor 1/2 es Xᵀ(Xw−y)/n, de dimensión d. Con
Entender el mecanismo
Un vector es una colección ordenada de coordenadas; una matriz representa una operación lineal entre espacios. El rango cuenta direcciones independientes: si dos características siempre cambian juntas, los datos no identifican por separado sus efectos sin más supuestos. La derivada mide sensibilidad local y el gradiente reúne derivadas parciales. Un paso suficientemente pequeño en sentido opuesto al gradiente reduce localmente el objetivo. La probabilidad representa incertidumbre mediante distribuciones, no adjetivos de confianza.
Una decisión y un cálculo concretos
Si el 1% de tickets es urgente, un detector encuentra el 90% de ellos y alerta sobre el 5% de los no urgentes, en 10,000 tickets esperamos 90 alertas verdaderas y 495 falsas. Solo 90/585≈15.4% de alertas corresponde a urgencias. Es un ejemplo sintético de Bayes, no una medición de producto: la tasa base importa tanto en ML como en seguridad de agentes.
Secuencia semanal sugerida
Semanas 1–3: funciones, colecciones, archivos, excepciones y entorno Python reproducible. 4–7: vectores, productos, proyecciones y mínimos cuadrados con MIT y apoyo visual. 8–10: probabilidad condicional, esperanza y derivadas conectadas a regresión. Programe mientras estudia matemáticas.
X∈ℝⁿˣᵈ, w∈ℝᵈ, y∈ℝⁿ; n>0. El gradiente tiene la forma de w. La primera columna constante incorpora el sesgo.
Recursos oficiales de esta etapaEtapa 1 · Aprender de los datos, sin filtraciones
CS229 proporciona la estructura matemática; las clases públicas de 2018 son una entrada estable. Parte del material actual puede estar restringida: fije una edición. La especialización de Andrew Ng puede servir como puente opcional y CS4780 como explicación alternativa; ninguna sustituye las derivaciones y una implementación propia.
El aprendizaje supervisado estima una relación con etiquetas; el no supervisado busca estructura sin ellas. Regresión lineal predice valores reales, regresión logística probabilidades binarias y k-means alterna asignaciones y centroides. Explique el objetivo antes de elegir el algoritmo. La distancia euclídea depende de la escala: una unidad numérica grande puede dominar el resultado.
Caso conductor: priorizar tickets de incidentes usando datos públicos o sintéticos. Separe por tiempo o cliente antes de ajustar el preprocesamiento. Duplicados entre entrenamiento y prueba pueden producir una puntuación engañosa. La exactitud oculta casos urgentes raros; omitir una urgencia y pedir una revisión innecesaria tienen costes distintos.
La regularización equilibra ajuste y estabilidad. Ridge añade λ‖w‖²/2 y, por tanto, λw al gradiente. Más λ no siempre ayuda: selecciónelo con entrenamiento/validación y conserve la prueba final intacta. Mantenga una referencia constante o lineal y guarde preprocesamiento, particiones y modelo juntos.
Entender el mecanismo
Un estimador obtiene parámetros de datos; un predictor los aplica a entradas nuevas. La pérdida de entrenamiento y la generalización no son equivalentes. Error de optimización, error de estimación y cambio de distribución son problemas diferentes; más pasos de entrenamiento solo pueden resolver algunos. Identifique el problema antes de ajustar hiperparámetros.
Una decisión y un cálculo concretos
La regresión logística produce
Secuencia semanal sugerida
Semanas 11–13: regresión, máxima verosimilitud y gradientes. 14–16: regularización, validación, escala y k-means. 17–18: proyecto de referencia en datos con licencia. Después de CS229, cierre los apuntes, derive un objetivo e impleméntelo; use Cornell solo para lagunas concretas.
λ≥0 controla la penalización; su escala depende de la normalización y la convención de pérdida.
Recursos oficiales de esta etapaEtapa 2 · Redes neuronales y representación visual
Comience Zero to Hero con micrograd y la acumulación inversa de derivadas. Aprenda después por qué las matrices por lotes son eficientes y cómo el broadcasting puede dar un gradiente incorrecto sin error de ejecución. CS231n añade pérdidas, optimización, convoluciones y práctica; Michigan es una alternativa, no otra obligación completa.
La capa oculta aprende representaciones. Sin no linealidad, apilar transformaciones lineales sigue siendo lineal y no resuelve XOR. Retropropagación calcula derivadas; Adam o SGD actualizan parámetros. Pérdida de entrenamiento baja no demuestra generalización. La augmentación modifica la distribución y debe preservar el significado de la etiqueta.
Una convolución comparte filtros locales; un ViT relaciona parches mediante atención. Sus supuestos y costes difieren. En un primer proyecto pequeño, compare un codificador preentrenado congelado y su ajuste fino con la misma partición. Entrenar un ViT desde cero suele ser innecesariamente costoso. Registre licencia, resolución, parámetros entrenables y hardware.
Después elija optativas: fast.ai para una entrada práctica de arriba abajo, MIT 6.S191 para una visión compacta y CS230 para otra perspectiva de entrenamiento. CS236 amplía modelado probabilístico; MIT 6.S184 desarrolla flujo y difusión con ODE/SDE. No incluya todas las ramas en nueve semanas.
Entender el mecanismo
La diferenciación automática combina reglas locales en un grafo. Si un valor alimenta dos operaciones, su gradiente suma ambas rutas. Reiniciar y acumular gradientes son distintos. Un paso hace forward, pérdida, reinicio, backward y actualización. Evaluar también cambia dropout y normalización y evita registrar grafos innecesarios; no consiste solo en quitar la actualización.
Una decisión y un cálculo concretos
Una capa de 32 entradas y 64 unidades tiene 32×64+64=2,112 parámetros; una salida de 10 clases añade 650, total 2,762. La memoria también incluye activaciones, gradientes y estado del optimizador. Adam suele guardar dos momentos por parámetro entrenado; bytes exactos dependen de dtype, pesos maestros e implementación. Haga ese inventario antes de alquilar más GPU.
Secuencia semanal sugerida
Semanas 19–21: micrograd y redes pequeñas. 22–24: vectorización, inicialización, optimizadores y convoluciones. 25–27: tareas de visión y comparación congelación/ajuste. Mantenga generación como optativa y diagnostique datos/gradientes antes de cambiar arquitectura.
X:[n,d], W₁:[d,h], b₁:[h], W₂:[h,c], b₂:[c]; estados [n,h], salidas [n,c]. σ es no lineal elemento a elemento y el sesgo se difunde por filas.
Recursos oficiales de esta etapaEtapa 3 · Del texto a un modelo de lenguaje entrenado
CS224N conecta tareas lingüísticas, embeddings, secuencias y atención. Use las grabaciones oficiales públicas de 2024 y compruebe su correspondencia con materiales. Un embedding convierte un ID en un vector aprendido; proximidad estadística no implica verdad, autorización ni procedencia.
El tokenizador convierte texto o bytes en IDs. BPE aprende fusiones frecuentes y cambia longitudes y vocabulario. Un Transformer decodificador predice el siguiente token con máscara causal. Q,K de forma [T,dₖ] producen QKᵀ de forma [T,T]; atención normalizada por V de forma [T,dᵥ] devuelve [T,dᵥ]. La máscara excluye posiciones futuras.
La entropía cruzada promedia el logaritmo negativo de la probabilidad del token correcto; 0.25 aporta aproximadamente 1.386 nats. Compare pérdidas solo con tokenización, datos y agregación compatibles. La predicción lingüística no certifica veracidad ni uso seguro de herramientas. Máscaras de padding, desplazamiento de etiquetas y contaminación importan matemáticamente.
El objetivo principal es la tarea 1 de CS336: tokenizador, modelo, optimizador y entrenamiento en un corpus pequeño. El curso completo exige Python/PyTorch y sistemas sólidos; no cabe entero en esta etapa para todos. Comience con una muestra diminuta, guarde configuración y checkpoints y amplíe solo tras verificar corrección. Tokens, contexto y batch determinan memoria y presupuesto.
CME295 ofrece panorama arquitectónico y distingue ediciones 2025/2026. Hugging Face aporta práctica de ecosistema. CS25 es un seminario de investigación; CMU avanzado ayuda cuando ya existe una pregunta concreta. Distinga preentrenamiento, ajuste supervisado, recuperación e inferencia: cambian pesos, contexto o ejecución de formas distintas.
Entender el mecanismo
De IDs [4,7,9,2] se obtienen entradas [4,7,9] y objetivos [7,9,2]. Con batch B, longitud T y vocabulario V, logits es [B,T,V]. La entropía cruzada selecciona objetivos y promedia posiciones válidas. Un reshape legal puede alinear mal etiquetas. Aprender fusiones BPE y aprender pesos del Transformer son procesos separados.
Una decisión y un cálculo concretos
Con
Secuencia semanal sugerida
Semanas 28–30: lenguaje, embeddings y causalidad. 31–33: bytes, BPE y un bloque decoder. 34–36: entrenamiento pequeño, checkpoint y generación con la tarea 1 de CS336. 37–38: comportamiento reservado y fichas de modelo/datos. Después elija sistemas, multilingüismo, RAG o postentrenamiento.
Softmax por filas;
Etapa 4 · Aprender mediante decisiones y recompensas
RL estudia acciones con efectos posteriores. Un MDP incluye estado suficiente para la transición, acciones, recompensas escalares y descuento γ. Para predecir etiquetas fijas, el aprendizaje supervisado suele ser más sencillo. Una llamada a una herramienta no constituye por sí misma aprendizaje por refuerzo.
CS234 construye valores, Bellman y evaluación de políticas; Sutton–Barto y David Silver ayudan a entenderlos. Seleccione después CS285 sobre aproximación, gradientes de política y actor–critic. DQN usa replay y redes objetivo para estabilizar valores de acciones discretas. PPO limita actualizaciones mediante un objetivo recortado; no ofrece una garantía universal de seguridad.
El objetivo r+γ maxₐ Q(s′,a) usa una estimación futura. Con
El postentrenamiento de LLM es una rama posterior. CS224R y CS329H conectan políticas y preferencias; no prometemos vídeos públicos de CS329H. GRPO requiere recompensas válidas, grupos de muestras, control KL y tareas reservadas; una mejora puede explotar la recompensa. Spinning Up sigue siendo didáctico, pero su código antiguo puede requerir adaptar dependencias para Gymnasium.
Entender el mecanismo
Una política elige acciones y un valor estima retorno; el entorno produce observaciones y recompensas. On-policy usa datos de la política actualizada; off-policy reutiliza otros comportamientos gestionando el desajuste. Replay no es una mejora universal sin supuestos. Con observación parcial, la observación actual puede no ser un estado suficiente.
Una decisión y un cálculo concretos
Recompensas [1,0,2] con
Secuencia semanal sugerida
Semanas 39–41: MDP, Bellman y métodos tabulares. 42–44: aproximación, DQN y gradientes de política. 45–46: comparación acotada DQN/PPO y análisis de fallos. Antes de LLM-RL, explique el origen del premio, la política de las trayectorias y el presupuesto de interacciones.
Etapa 5 · Un agente acotado y observable
Un agente selecciona acciones repetidamente a partir de observaciones y un objetivo. Un workflow fija el orden; un agente delega algunas elecciones al modelo. Empiece con autonomía mínima: recuperar runbooks públicos, citar evidencia y proponer un comando sin modificar producción.
CS329Z enseña componentes antes de abstracciones. El 14 de noviembre de 2026 su calendario enlaza vídeos de las primeras cinco sesiones; no toda la asignatura. Sus dos tareas cubren harness y evaluación. Use instrucciones y costes del repositorio oficial, no una promesa fija de gasto API tomada de redes sociales.
Berkeley Fall 2024 ofrece el panorama; Spring 2025 profundiza en razonamiento y tareas verificables; Fall 2025 Agentic AI añade perspectivas de sistemas. Son archivos: sus antiguos plazos de certificados no son convocatorias actuales. Seleccione charlas según carencias del proyecto. Hugging Face es práctico; CS329A y CS222 amplían investigación y lectura.
Un harness mantiene mensajes, esquemas, parsing, autorización, ejecución, normalización y parada. El modelo propone; código confiable valida herramienta, argumentos y permiso actual. La salida de una herramienta es dato no confiable, no instrucción del sistema. Defina persistencia, idempotencia, timeout y aprobación humana antes de acciones irreversibles. Pedir prudencia en el prompt no impone permisos.
Limite pasos, tiempo y tokens. Ocho llamadas de hasta 2,000 tokens de entrada y 300 de salida suman como máximo 18,400, sin reintentos ni llamadas auxiliares, que necesitan presupuesto propio. Un stub local permite probar control sin pagar un modelo. Aun así, ejecutar correctamente una herramienta no demuestra lograr el objetivo del usuario.
Entender el mecanismo
Separe adaptador de modelo, harness y ejecutor. Registre eventos tipados model_proposal, tool_denied, tool_started y tool_result. Una máquina de estados puede pasar ready→proposed→authorized→executing→observed con salidas denied, timed_out y stopped. Una excepción no debe convertirse en éxito. Reproducir un registro no autoriza repetir efectos externos.
Una decisión y un cálculo concretos
Empiece con search_runbooks(query), get_service_metrics(service,window) y fetch_recent_changes(service), todos de lectura. Valide el servicio contra el ámbito permitido al usuario. Distinga métricas observadas, recomendaciones recuperadas e inferencias. Ante timeout, indique evidencia incompleta; no invente valores sanos. restart_service requiere otra decisión de permisos y aprobación.
Secuencia semanal sugerida
Semanas 47–48: recuperación determinista y adaptador falso. 49–50: herramientas acotadas, estado persistente, rechazo y timeout con componentes de CS329Z. 51–52: tareas reservadas, trazas y demostración reproducible. Berkeley responde a dudas concretas. Seis semanas no prometen todas las tareas oficiales completas.
Cota sintética de tokens de entrada/salida. Cada llamada debe respetar su límite; excluye reintentos, jueces y embeddings.
Recursos oficiales de esta etapaElegir una especialización
Ingeniería de aplicaciones: priorice inferencia, fiabilidad, recuperación, seguridad y observabilidad. Investigación: profundice en probabilidad, optimización y experimentos controlados. Robótica: añada estimación, control, dinámica y transferencia simulación-real; esta ruta no equivale a formación completa en robótica.
Un portfolio coherente contiene una referencia clásica, un modelo visual, un pequeño LM, un informe RL y un agente acotado. Explique entradas, aprendizaje, ejecución, medición e incógnitas. Completar cursos no garantiza experiencia ni empleo; la evidencia es mejor indicador que el porcentaje de vídeos vistos.
Práctica, proyectos y evidencias
La verificación práctica se reúne aquí, después de los conceptos. Son ejercicios originales, no soluciones oficiales. Fije la edición y respete el código de honor. Ejecute tareas externas en su entorno, sin subir tickets privados ni credenciales.
Fundamentos
Evidencia del proyecto. Construya CSV→características y reproduzca el ejemplo de regresión. Incluya comando desde entorno limpio, comprobación de formas y gradiente por diferencias finitas.
Fallo / comparación justa. Desordene objetivos sin características: explique por qué formas válidas no garantizan datos correctos.
Orden de implementación
- Cree src/, tests/, data/ y README; registre Python y paquetes en un entorno virtual. Preserve IDs al cargar CSV e implemente ejemplos antes de estimadores de biblioteca.
- Documente un comando desde checkout limpio. Cambie una entrada, prediga el efecto y explique cualquier discrepancia, no solo haga pasar pruebas.
ML clásico
Evidencia del proyecto. Implemente regresión lineal/logística y k-means con NumPy. En datos públicos con licencia, incluya referencia constante, partición temporal/por entidad, transformaciones ajustadas solo al entrenamiento y prueba final intacta.
Fallo / comparación justa. Compare regularización con la misma partición; examine recall minoritario y filtraciones sin elegir reiteradamente por prueba.
Orden de implementación
- Defina decisión, etiquetas y particiones antes de mirar resultados. Separe fit/transform y añada referencias constante, regresión y clustering; k-means no necesita etiquetas de clase.
- Fije roles train/validation/test. Registre experimentos, seleccione con validación y evalúe test al final. Incluya un grupo raro o periodo posterior.
Redes
Evidencia del proyecto. Complete tareas seleccionadas de CS231n o Michigan y compare codificador congelado y ajuste fino. Registre semilla, checkpoint, transformaciones, tasa y hardware.
Fallo / comparación justa. Sobreajuste primero una muestra diminuta para depurar; revise etiquetas y use transformaciones de validación deterministas.
Orden de implementación
- Separe loader, modelo, pérdida, optimizador y entrenamiento. Registre tasa, pérdidas y normas de gradiente; guarde un batch conocido.
- Entrene una red pequeña antes de usar un checkpoint licenciado. Compare congelación/ajuste con particiones y recursos comparables; atribuya ventajas de datos preentrenados correctamente.
Lenguaje
Evidencia del proyecto. Complete el alcance de la tarea 1 de CS336: reglas del tokenizador, configuración, hashes, estado del optimizador, muestreo, curva y formas.
Fallo / comparación justa. Compruebe ida/vuelta del tokenizador, causalidad y recarga; compare con unigramas en datos reservados, sin comparar perplejidades de tokenizadores incompatibles.
Orden de implementación
- Implemente encode/decode, pares desplazados, embeddings, atención causal, bloques feed-forward, proyección, pérdida, optimizador y muestreo.
- Para continuación exacta guarde modelo, optimizador, scheduler, paso, configuración y RNG. Compare reanudación con entrenamiento continuo bajo determinismo; registre hashes y límites restantes.
RL
Evidencia del proyecto. Implemente DQN y PPO en pequeños entornos Gymnasium. Reporte varias semillas, versión, pasos, política de evaluación y distribución de resultados.
Fallo / comparación justa. Distinga terminal/truncated; iguale interacciones y reporte diferencias de cómputo. Incluya fallos y diagnóstico.
Orden de implementación
- Use tareas pequeñas apropiadas para DQN discreto y PPO. Explicite wrappers, límites y transformaciones; separe exploración y evaluación.
- Fije semillas y presupuestos antes. Grafique pasos y tiempo por separado. Introduzca y diagnostique un error de recompensa o terminación, restáurelo y documente.
Agentes
Evidencia del proyecto. Siga HW1/HW2 de CS329Z y cree un asistente local de incidentes de solo lectura: modelo guionizado, trazas, allowlist, estado persistente y parada.
Fallo / comparación justa. Inyecte resultados malformados, prompt injection, timeout y duplicados. Separe pruebas deterministas de calidad y use tareas reservadas; un juez no calibrado no es verdad absoluta.
Orden de implementación
- Implemente adaptador y tres herramientas de lectura, schema, permisos actuales, límites, trazas y eventos persistentes. Primero use modelo guionizado.
- Después integre un modelo local real. Separe resultado, apoyo documental, denegaciones, latencia y recursos. Entregue repositorio, instrucciones, trazas y límites sin credenciales.
El archivo para Python 3.11+ usa solo la biblioteca estándar, sin red, aleatoriedad ni API. Reproduce los ejemplos y verifica un gradiente con diferencias centrales. Es un ejercicio inicial, no los seis proyectos completos; para estos consulte los repositorios y tutoriales desde cero.
Descargar códigopython3 roadmap-foundations.py"""Python 3.11+, standard library only; deterministic synthetic examples."""
import math
X = [[1.0, 0.0], [1.0, 1.0]]
y = [1.0, 3.0]
w = [0.0, 0.0]
def loss(weights):
errors = [sum(a * b for a, b in zip(row, weights)) - target
for row, target in zip(X, y)]
return sum(e * e for e in errors) / (2 * len(y))
def gradient(weights):
errors = [sum(a * b for a, b in zip(row, weights)) - target
for row, target in zip(X, y)]
return [sum(row[j] * e for row, e in zip(X, errors)) / len(y)
for j in range(len(weights))]
def softmax(logits):
if not logits or not all(math.isfinite(v) for v in logits):
raise ValueError("finite, nonempty logits required")
maximum = max(logits)
values = [math.exp(v - maximum) for v in logits]
return [v / sum(values) for v in values]
def td_target(reward, gamma, next_values, terminated):
return reward if terminated else reward + gamma * max(next_values)
g = gradient(w)
eps = 1e-6
for j, analytic in enumerate(g):
plus, minus = w.copy(), w.copy()
plus[j] += eps
minus[j] -= eps
numeric = (loss(plus) - loss(minus)) / (2 * eps)
assert math.isclose(analytic, numeric, abs_tol=1e-8)
updated = [a - 0.1 * b for a, b in zip(w, g)]
assert loss(updated) < loss(w)
p = softmax([1000.0, 1000.0])
assert p == [0.5, 0.5]
assert math.isclose(sum(softmax([1.0, 2.0, 3.0])), 1.0)
try:
softmax([])
except ValueError:
pass
else:
raise AssertionError("empty inputs must fail")
assert td_target(1, 0.9, [2, 4], True) == 1
assert math.isclose(td_target(1, 0.9, [2, 4], False), 4.6)
print(f"gradient={g}")
print(f"weights={[round(v, 2) for v in updated]}")
print(f"loss={loss(updated):.6f}")
print(f"cross_entropy={-math.log(0.25):.6f}")
print(f"td_target={td_target(1, 0.9, [2, 4], False):.1f}")
# Additional synthetic decision/resource examples in the expanded tutorial.
base_rate, sensitivity, false_positive_rate = 0.01, 0.90, 0.05
true_alerts = 10_000 * base_rate * sensitivity
false_alerts = 10_000 * (1 - base_rate) * false_positive_rate
precision = true_alerts / (true_alerts + false_alerts)
assert true_alerts == 90 and false_alerts == 495
assert math.isclose(precision, 90 / 585)
miss_cost, false_alert_cost = 20, 1
threshold = false_alert_cost / (miss_cost + false_alert_cost)
assert math.isclose(threshold, 1 / 21)
for probability in (0.01, 0.05, 0.9):
flag = probability > threshold
assert flag == ((1 - probability) * false_alert_cost < probability * miss_cost)
assert 32 * 64 + 64 + 64 * 10 + 10 == 2762
assert 4 * 128 * 1024 * 4 == 2 * 1024**2
assert math.ceil(100_000 / (4 * 128)) == 196
assert math.isclose(sum(0.9**i * reward for i, reward in enumerate([1, 0, 2])), 2.62)
print("checks=passed")
Salida prevista:
Preguntas originales y puntuación
¿Por qué una puntuación alta no basta?
Pista
Revise particiones y preprocesamiento.
Respuesta y análisis
Duplicados, información futura o ajuste repetido a prueba invalidan la evidencia. Separe por entidad/tiempo, ajuste transformaciones solo al entrenamiento y reporte referencia e incertidumbre.
¿Cómo puede el entrenamiento paralelo ser autorregresivo?
Pista
Distinga cálculo paralelo de flujo de información.
Respuesta y análisis
La máscara causal excluye el futuro y las etiquetas se desplazan. Cambiar entradas futuras no debe alterar salidas anteriores en evaluación, salvo tolerancia numérica.
¿Necesita RL un agente?
Pista
Separe selección de acciones y actualización de políticas.
Respuesta y análisis
No: un modelo preentrenado con harness acotado puede elegir herramientas sin actualizar pesos. RL añade exigencias de recompensa y evaluación.
¿Cuándo añadir un framework?
Pista
Identifique el mecanismo repetitivo que reemplaza.
Respuesta y análisis
Después de comprender transiciones, parsing, ejecución y errores. Reducir código repetido no demuestra permisos, durabilidad ni éxito.
Puntuación 1–5: 1 repite términos; 2 explica mecanismos y supuestos; 3 reproduce referencia y cálculos; 4 diagnostica fallos y compara alternativas con presupuesto equivalente; 5 defiende decisiones, incertidumbre, límites y transferencia. Exija al menos 3 en corrección, reproducibilidad y explicación antes de avanzar.
Cómo avanzar cuando aparece una dificultad
Reduzca una fórmula a un escalar o dos filas; aísle una función para inspeccionar formas y estado; vuelva a una referencia pequeña si el entrenamiento falla; separe afirmación, supuestos, evidencia y límites de un artículo.
Use IA como tutor: pida pistas, contraejemplos o revisión antes de una solución completa. Cierre la respuesta y reconstruya el código. Explique componentes prestados, licencias y pruebas: que el código generado funcione no demuestra que pueda mantenerlo.
Predecir, comprobar y conservar evidencia
Antes de revelar la respuesta, predice un resultado. Después registra diferencias y una prueba de transferencia. Se guarda localmente y se comparte entre idiomas.
Abrir cuaderno / exportar / borrar →El alcance de revisión matemática se registra por lección. No certifica reproducción empírica del artículo; anota posibles errores. Alcance de revisión
Cursos oficiales, vídeos y lecturas
Enlaces a proveedores originales, no garantía de gratuidad de cada clase, tarea, certificado o recurso. Si no se verificó una lista estable, use los vídeos del programa oficial. Ediciones y dependencias pueden diferir. Revisión: 14 de noviembre de 2026.
Etapa 0 · Python y lenguaje matemático
CS50Phttps://cs50.harvard.edu/python/
Selección central; clases y tareas en el programa.
Stanford Code in Placehttps://codeinplace.stanford.edu/
Por convocatorias; CS50P es la alternativa autónoma.
3Blue1Brown · Linear algebrahttps://www.3blue1brown.com/topics/linear-algebra
Intuición visual antes de derivar; no sustituye ejercicios ni es un curso universitario.
Curso / materialeshttps://www.3blue1brown.com/topics/linear-algebra
MIT 18.06 · Gilbert Strang · 2010https://ocw.mit.edu/courses/18-06-linear-algebra-spring-2010/
Selección central; clases y tareas en el programa.
Curso / materialeshttps://ocw.mit.edu/courses/18-06-linear-algebra-spring-2010/ · Vídeo / material complementariohttps://ocw.mit.edu/courses/18-06-linear-algebra-spring-2010/video_galleries/video-lectures/
Stanford ENGR108https://web.stanford.edu/class/engr108/
Álgebra aplicada; actualmente usa Julia.
Stanford CS109https://web.stanford.edu/class/cs109/
Probabilidad para programadores; libro enlazado, grabaciones actuales pueden exigir matrícula.
Curso / materialeshttps://web.stanford.edu/class/cs109/ · Vídeo / material complementariohttps://probabilitycoders.stanford.edu/
Harvard Stat 110https://stat110.hsites.harvard.edu/
Alternativa; no duplique por defecto otro curso completo.
3Blue1Brown · Calculushttps://www.3blue1brown.com/topics/calculus
Intuición visual antes de derivar; no sustituye ejercicios ni es un curso universitario.
Curso / materialeshttps://www.3blue1brown.com/topics/calculus
Etapa 1 · Aprender de los datos, sin filtraciones
Stanford CS229 · 2018 lectureshttps://cs229.stanford.edu/
Entrada a clases de 2018; parte del material actual está restringido.
Curso / materialeshttps://cs229.stanford.edu/ · Vídeo / material complementariohttps://www.youtube.com/watch?v=jGwO_UgTS7I
Machine Learning Specialization · Andrew Nghttps://www.coursera.org/specializations/machine-learning-introduction
Puente opcional; no asuma gratuidad total ni del certificado.
Curso / materialeshttps://www.coursera.org/specializations/machine-learning-introduction
Cornell CS4780 · 2018https://www.cs.cornell.edu/courses/cs4780/2018fa/
Alternativa; no duplique por defecto otro curso completo.
Curso / materialeshttps://www.cs.cornell.edu/courses/cs4780/2018fa/ · Vídeo / material complementariohttps://www.youtube.com/playlist?list=PLl8OlHZGYOQ7bkVbuRthEsaLr7bONzbXS
Etapa 2 · Redes neuronales y representación visual
Karpathy · Neural Networks: Zero to Herohttps://karpathy.ai/zero-to-hero.html
Selección central; clases y tareas en el programa.
Stanford CS231nhttps://cs231n.stanford.edu/
Lista pública oficial; grabaciones de primavera 2026 para matriculados.
Curso / materialeshttps://cs231n.stanford.edu/ · Vídeo / material complementariohttps://www.youtube.com/playlist?list=PLoROMvodv4rOmsNzYBMe0gJY2XS8AQg16
UMich EECS498/598 · 2019 assignment archivehttps://web.eecs.umich.edu/~justincj/teaching/eecs498/FA2019/assignment2.html
Archivo de tareas 2019 accesible; la portada antigua devolvió 404. No se verificó un paquete de vídeos completo.
Curso / materialeshttps://web.eecs.umich.edu/~justincj/teaching/eecs498/FA2019/assignment2.html
3Blue1Brown · Neural networkshttps://www.3blue1brown.com/topics/neural-networks
Intuición visual antes de derivar; no sustituye ejercicios ni es un curso universitario.
Curso / materialeshttps://www.3blue1brown.com/topics/neural-networks
fast.ai · Practical Deep Learninghttps://course.fast.ai/
Alternativa; no duplique por defecto otro curso completo.
MIT 6.S191https://introtodeeplearning.com/
Panorama opcional; distinga edición actual y archivos.
Stanford CS230https://cs230.stanford.edu/
Complemento especializado tras el núcleo; elija según carencias.
Stanford CS236 · Deep Generative Modelshttps://deepgenerativemodels.github.io/
Rama generativa; probabilidad y cálculo previos. El complemento puede ser PDF, no vídeo.
MIT 6.S184 · 2026https://diffusion.csail.mit.edu/2026/index.html
Rama generativa; probabilidad y cálculo previos. El complemento puede ser PDF, no vídeo.
Curso / materialeshttps://diffusion.csail.mit.edu/2026/index.html · Vídeo / material complementariohttps://diffusion.csail.mit.edu/2026/docs/lecture_notes.pdf
Etapa 3 · Del texto a un modelo de lenguaje entrenado
Stanford CS224Nhttps://web.stanford.edu/class/cs224n/
Lista pública 2024; acceso distinto a grabaciones actuales y materiales.
Curso / materialeshttps://web.stanford.edu/class/cs224n/ · Vídeo / material complementariohttps://www.youtube.com/playlist?list=PLoROMvodv4rOaMFbaqxPDoLWjDaRAdP9D
Stanford CS336 · Spring 2026https://cs336.stanford.edu/
Vídeos/tareas 2026; prerrequisitos fuertes. Acote primero a la tarea 1.
Curso / materialeshttps://cs336.stanford.edu/ · Vídeo / material complementariohttps://www.youtube.com/playlist?list=PLoROMvodv4rMqXOcazWaTUHhq-yembLCV
Stanford CME295https://cme295.stanford.edu/syllabus/
Panorama opcional; distinga edición actual y archivos.
Stanford CS25https://web.stanford.edu/class/cs25/
Seminario: charlas seleccionadas después de implementar fundamentos.
CMU 11-711 · Advanced NLP · 2024https://phontron.com/class/anlp2024/
Complemento especializado tras el núcleo; elija según carencias.
Hugging Face LLM Coursehttps://huggingface.co/learn/llm-course/
Práctica de ecosistema; dependencias y cómputo externo aparte.
Etapa 4 · Aprender mediante decisiones y recompensas
Sutton & Barto · Reinforcement Learning, second editionhttp://incompleteideas.net/book/the-book-2nd.html
Libro del autor gratuito; no se pudo recuperar en esta revisión.
Curso / materialeshttp://incompleteideas.net/book/the-book-2nd.html
David Silver · RL · 2015https://davidstarsilver.wordpress.com/teaching/
Alternativa; no duplique por defecto otro curso completo.
Curso / materialeshttps://davidstarsilver.wordpress.com/teaching/
Stanford CS234https://web.stanford.edu/class/cs234/
Selección central; clases y tareas en el programa.
Berkeley CS285 · 2023 lectureshttps://rail.eecs.berkeley.edu/deeprlcourse/
Lista oficial 2023; use tareas correspondientes, sin mezclar ediciones.
Curso / materialeshttps://rail.eecs.berkeley.edu/deeprlcourse/ · Vídeo / material complementariohttps://www.youtube.com/playlist?list=PL_iWQOsE6TfVYGEGiAOMaOzzv41Jfm_Ps
Stanford CS224Rhttps://cs224r.stanford.edu/
Complemento especializado tras el núcleo; elija según carencias.
OpenAI Spinning Uphttps://spinningup.openai.com/en/latest/
Algoritmos e implementaciones antiguas; revise compatibilidad.
Hugging Face Deep RL Coursehttps://huggingface.co/learn/deep-rl-course/en/unit0/introduction
Práctica de ecosistema; dependencias y cómputo externo aparte.
Curso / materialeshttps://huggingface.co/learn/deep-rl-course/en/unit0/introduction
Stanford CS329H · Autumn 2026https://web.stanford.edu/class/cs329h/
Material 2026 de preferencias; vídeos públicos no verificados.
Stanford CS221https://stanford-cs221.github.io/autumn2025/
Seleccione MDP/juegos. Página 2025: grabaciones Canvas, diapositivas/código públicos.
Curso / materialeshttps://stanford-cs221.github.io/autumn2025/
Etapa 5 · Un agente acotado y observable
Stanford CS329Z · Autumn 2026https://cs329z.stanford.edu/
Curso 2026; cinco enlaces de vídeo comprobados. HW1 harness, HW2 evaluación.
Curso / materialeshttps://cs329z.stanford.edu/ · Vídeo / material complementariohttps://youtu.be/DGI4vucR71w
Berkeley LLM Agents · Fall 2024https://llmagents-learning.org/f24
Primera serie: fundamentos. Fechas antiguas de certificados no son ofertas actuales.
Berkeley Advanced LLM Agents · Spring 2025https://llmagents-learning.org/sp25
Segunda serie: razonamiento avanzado y tareas verificables.
Berkeley Agentic AI · Fall 2025https://agenticai-learning.org/f25
Tercera serie: Agentic AI. Seleccione charlas; no haga obligatorias las tres.
Stanford CS329A · Self-Improving AI Agentshttps://cs329a.stanford.edu/
Rama investigadora de automejora; exige evaluación y análisis de fallos.
Stanford CS222 · Fall 2024https://joonspk-research.github.io/cs222-fall24/
Lecturas/proyectos 2024; serie pública completa de vídeo no verificada.
Curso / materialeshttps://joonspk-research.github.io/cs222-fall24/
Hugging Face Agents Coursehttps://huggingface.co/learn/agents-course/en/unit0/introduction
Práctica de ecosistema; dependencias y cómputo externo aparte.
Curso / materialeshttps://huggingface.co/learn/agents-course/en/unit0/introduction
- CS336 · Assignment 1https://github.com/stanford-cs336/assignment1-basics
- CS329Z · HW1https://github.com/cs329z/assignment1-harness
- CS329Z · HW2https://github.com/cs329z/assignment2-evals