Makespan de agentes: coordinar inferencia, cachés y herramientas
Un tutorial de sistemas para terminar antes un lote de agentes: separar admisión y capacidad de ejecución, conservar estado reutilizable y entender cuándo conviene adelantar cadenas largas.
Fuentes y versiones
En este artículo
Un lote lento pese a llamadas rápidas
Imagine una evaluación nocturna de 500 agentes de programación. Cada agente consulta al modelo, espera un comando del entorno aislado, lee la observación y vuelve a consultar. La entrega espera a que terminen todas las trayectorias. Al final, muchas GPU pueden estar inactivas mientras un solo agente alterna comandos lentos e inferencia. Acelerar la decodificación no elimina dependencias ni colas en otro servicio.
Una trayectoria comprende todos los pasos de un agente. El makespan es el tiempo desde el inicio del lote hasta la última terminación, incluidos los fallos terminales. No equivale al tiempo medio de finalización, TTFT, TPOT ni al intervalo del último 5%. Este tutorial trata lotes finitos de evaluación, datos sintéticos y rollouts. Un asistente interactivo necesita restricciones explícitas de latencia y equidad; no se debe sustituir su objetivo por el de un lote.
El objetivo es localizar cuellos de botella, separar controles de capacidad, estimar residencia de caché, interpretar ablaciones y programar un experimento. Debe entender colas, concurrencia y dependencias: esperar no es ejecutar; una trayectoria que espera una herramienta conserva contexto; la siguiente inferencia necesita su observación. Estas relaciones importan más que memorizar nombres de planificadores.
Ruta crítica y límites de recursos
Sea
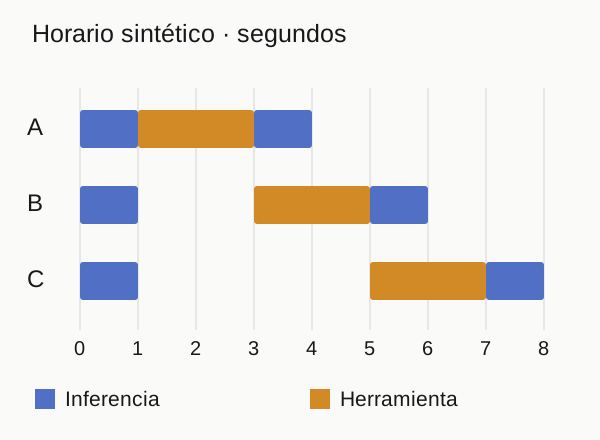
Tres tareas iguales ejecutan inferencia de 1 s, herramienta de 2 s e inferencia final de 1 s. Admitir una sola tarea cada vez requiere 12 s. Admitir las tres manteniendo una ranura de herramientas permite solapar las primeras inferencias entre 0–1 s. Las herramientas ocupan 1–3, 3–5 y 5–7 s; las tareas terminan en 4, 6 y 8 s. El makespan pasa a 8 s sin acelerar ninguna operación, y la media pasa de 8 a 6 s. Es un ejemplo original con paralelismo de inferencia ilimitado, no una medición de GPU.
La cota por herramientas es 6 s y la ruta individual más larga dura 4 s: la cota general es 6 s. Los 8 s reales incluyen la liberación inicial y la última inferencia. Por eso un panel de utilización no demuestra optimalidad. En servidores reales, aumentar concurrencia puede alargar llamadas individuales y aun así acortar el lote.
Arquitectura de referencia con dos controles
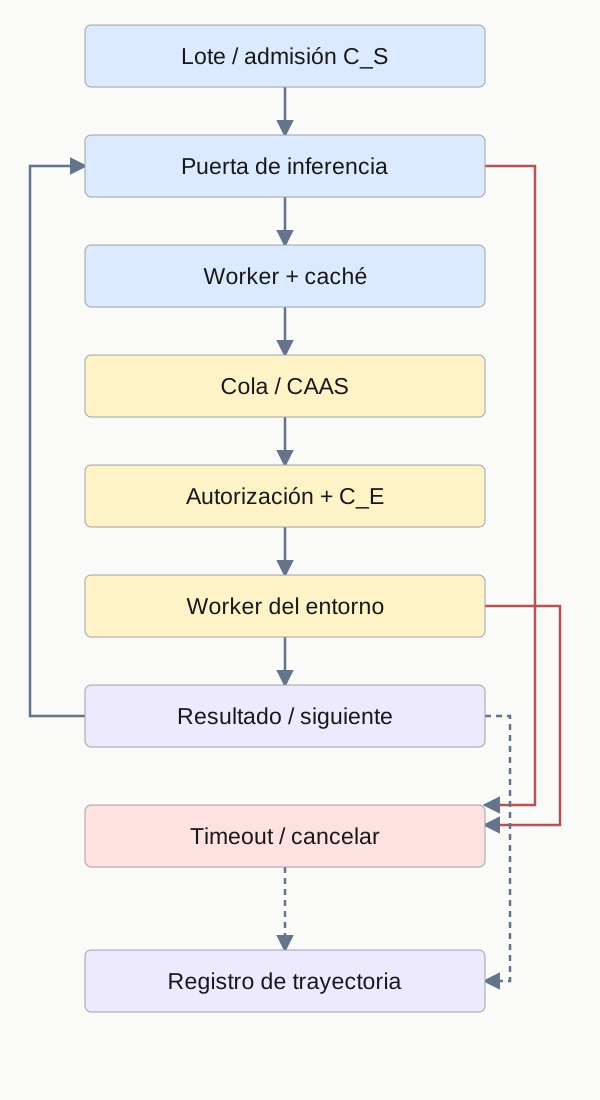
El controlador de admisión conserva una ranura
La etiqueta de trayectoria indica afinidad, nunca autorización. Antes de ejecutar, compruebe inquilino, capacidades, argumentos, plazo y cancelación. Una observación habilita el siguiente paso dependiente, pero no concede permisos. Separe claves de caché por ámbito de intercambio autorizado y configuración de modelo y tokenizador. Compartir entre inquilinos necesita una decisión de seguridad adicional.
Limite la cola y aplique contrapresión. Ante un timeout, registre un resultado incierto o fallido. Si pudo producirse un efecto externo, reconcilie el identificador de operación antes de repetir; liberar un semáforo no revierte el negocio. Propague cancelaciones, establezca presupuestos y espera progresiva para reintentos, y guarde el checkpoint antes de habilitar el siguiente paso. Son requisitos de ingeniería propuestos aquí, no resultados comprobados en el artículo.
Dos grupos de memoria que deben encajar
En atención convencional, las claves y valores crecen con la longitud del contexto. Un modelo híbrido también puede guardar un resumen recurrente por trayectoria. Reutilizar un prefijo puede exigir ambos. Un grupo KV vacío no ayuda si el grupo recurrente no retiene las mismas trayectorias. El artículo elige una partición informada por la carga al desplegar; no la redimensiona durante el lote.
M es la memoria disponible tras pesos y reservas;
Ejemplo original: 12 GiB de caché, 1 GiB KV y 0.25 GiB recurrentes por trayectoria. Repartir 6/6 GiB permite min(6,24)=6; repartir 9.6/2.4 equilibra ambos en 9.6, con referencia entera 9. Esto no demuestra que
Afinidad no significa residencia garantizada
Mantener turnos en el mismo worker evita recalcular prefijos crecientes, pero puede sobrecargar una réplica. El hashing consistente con carga acotada del artículo empieza en un worker preferido y permite desvíos según solicitudes en vuelo. No predice futuros tokens. A veces sacrificar caché evita una cola mayor; el porcentaje de aciertos es una métrica intermedia.
Dentro del worker, routing-prefix usa etiquetas recientes para reducir búsquedas de prefijo dedicadas a calcular prioridad. Conservar una etiqueta no demuestra que siga su estado en GPU; eliminarla tampoco borra la caché. Mida afinidad, reutilización real, prefill no almacenado, espera y terminación por separado. Una afinidad alta puede ocultar recomputación.
En modelos de atención pura no hay partición recurrente, pero permanece el compromiso de enrutamiento. Las cachés compartidas añaden transferencia de red; el modelo de reutilización local del artículo no establece el óptimo para migrarlas. En workers heterogéneos, contar solicitudes representa mal cargas de distinto coste: ajuste por demanda y capacidad.
Adelantar cadenas sin conocer su futuro
Tras separar capacidades, el orden de herramientas decide qué trayectorias revelan el siguiente paso. CAAS agrupa llegadas en bandas de B segundos. Prioriza la banda más antigua, luego mayor número de turnos de inferencia completados, menor cubeta de duración media observada y finalmente orden FIFO. La profundidad incluye el turno que produjo la herramienta. La clave se fija al entrar; no lee longitud futura. En la tupla,
Con B=30 s y cubetas de 1 s, A llega a 61 s tras 4 turnos de media 2.2 s: (2,−4,3). B llega a 59 s tras 1 turno de 1 s: (1,−1,1); gana por banda anterior. C llega a 62 s tras 7 turnos de media 3.1 s: (2,−7,4), y precede a A en la misma banda. La profundidad solo manda después de comparar bandas.
La profundidad es una heurística, no un oráculo de trabajo restante. Una trayectoria profunda puede estar a punto de terminar; una nueva puede tener mucho por delante. B pequeño favorece llegada y B grande profundidad. Las bandas limitan adelantamientos repetidos, pero no garantizan equidad entre inquilinos, plazos ni espera acotada con operaciones atascadas. Añada cuotas, envejecimiento y reglas de SLO cuando sean necesarios.
Cómo interpretar los resultados publicados
El informe v1 del 12 de noviembre evalúa Ling-3.0-Flash y Ling-3.1-Flash en H20. La reducción anunciada de 10.4%–65.0% corresponde a configuraciones combinadas, no solo a CAAS. MCP-Atlas en vivo promedia tres ejecuciones de 500 tareas por configuración. La tabla reproduce hechos numéricos atribuidos; no son mediciones de Token Lab.
Para Ling-3.0, 466.1 → 168.2 min representa 63.9% por optimizaciones de inferencia y separación de admisión. Cambiar la política en esa configuración da 168.2 → 163.0 min, otro 3.1%. Frente al inicio, la mejora combinada es 65.0%. Sumar 63.9% y 3.1% es incorrecto: cambian denominadores. Las ejecuciones incluyen reintentos y fallos terminales, pero no establecen tolerancia a tormentas de reintentos ni carga adversarial multiinquilino.
El replay fija secuencias y duraciones del entorno, pero ejecuta inferencia real: mide eficiencia, no corrección semántica de acciones generadas. La ejecución real complementa el replay, con variación estocástica. El intervalo final del 5% puede crecer contra una base de admisión estrecha mientras termina antes el lote, porque cambian las tareas de la cola final. Compare tiempo absoluto y composición, no ese intervalo aislado.
| Modelo | Base | Opt-FCFS | Opt-CAAS |
|---|---|---|---|
| Ling-3.0 | 466.1 | 168.2 | 163.0 |
| Ling-3.1 | 333.5 | 140.5 | 128.5 |
arXiv:2611.16661v1 · Table 3https://arxiv.org/html/2611.16661v1#S5.T3
Integración y problemas abiertos
En una evaluación nocturna, optimice tiempo hasta un informe válido completo con presupuesto fijo. En RL importe también la versión de la política: recoger antes trayectorias obsoletas o sesgadas no garantiza aprender mejor. Para agentes interactivos, restrinja p95 y servicio por inquilino antes de optimizar throughput. Nunca elimine fallos del denominador.
Separe recursos: comandos limitados por CPU, APIs con cuotas y simuladores exclusivos. Un solo
Quedan adaptación de capacidad, carga heterogénea, economía de transferencia de caché, equidad y amplificación de reintentos. Despliegue desde una base instrumentada mediante cambios reversibles y expansión protegida, manteniendo el planificador anterior. Ninguna prioridad aprendida o heurística debe saltarse permisos, cancelaciones o plazos. Con estas fronteras claras, pasamos a la práctica.
Práctica y validación
Use Python 3.11+ sin paquetes, claves ni red. El primer caso verifica 12 frente a 8 s. El caso de 50 trayectorias con semilla fija compara FCFS y la regla CAAS publicada sobre trazas idénticas. Supone inferencia paralela ilimitada con demoras fijas, ranuras homogéneas no apropiativas y una herramienta pendiente por trayectoria. No implementa batching GPU, expulsión de caché, routing, herramientas reales, recuperación ni el sistema de los autores.
agent-batch-scheduler.pypython3 agent-batch-scheduler.pySalida esperada con semilla 17: 12.0/8.0 s en el ejemplo simple para ambas políticas. En el mixto, FCFS=427.0 s y CAAS=411.0 s; último 5%=28.0/2.0 s; media=221.30/220.58 s. Son resultados sintéticos, no predicciones de producción. Con tres tareas, el percentil 95 discreto coincide con la última: un intervalo cero no aporta información.
Python · agent-batch-scheduler.py
"""Token Lab synthetic scheduling lab. Python 3.11+, standard library only.
No model, API, tools, GPU or external environment is called.
Inference stages have fixed durations and unlimited parallel capacity.
This is an independently written teaching model, not the paper's evaluator.
"""
from dataclasses import dataclass
from heapq import heappush, heappop
from math import ceil, floor, isfinite

@dataclass(frozen=True)
class Trace:
    inference: tuple[float, ...]
    environment: tuple[float, ...]
    def __post_init__(self):
        assert len(self.inference) == len(self.environment) + 1
        assert all(isfinite(x) and x > 0 for x in self.inference + self.environment)


def run(traces, samples=4, environments=1, policy="fcfs", band=30.0, bucket=1.0):
    assert samples > 0 and environments > 0 and band > 0 and bucket > 0
    assert policy in {"fcfs", "caas"}
    events, pending, completed, spans = [], [], {}, []
    active = busy = next_task = serial = 0
    observed = [0.0] * len(traces)
    max_busy = 0
    def schedule(end, kind, task, turn):
        nonlocal serial
        serial += 1
        heappush(events, (end, serial, kind, task, turn))
    def admit(now):
        nonlocal active, next_task
        while active < samples and next_task < len(traces):
            task = next_task
            next_task += 1
            active += 1
            schedule(now + traces[task].inference[0], "inference", task, 0)
    admit(0.0)
    while events:
        now = events[0][0]
        # Process simultaneous completions before choosing the next environment job.
        while events and events[0][0] == now:
            _, _, kind, task, turn = heappop(events)
            trace = traces[task]
            if kind == "environment":
                busy -= 1
                schedule(now + trace.inference[turn + 1], "inference", task, turn + 1)
            else:
                observed[task] += trace.inference[turn]
                if turn == len(trace.environment):
                    completed[task] = now
                    active -= 1
                else:
                    serial += 1
                    key = (serial,) if policy == "fcfs" else (
                        floor(now / band), -(turn + 1),
                        ceil(observed[task] / (turn + 1) / bucket), serial)
                    heappush(pending, (key, task, turn, now))
        admit(now)
        while pending and busy < environments:
            _, task, turn, arrival = heappop(pending)
            end = now + traces[task].environment[turn]
            spans.append((task, turn, arrival, now, end))
            busy += 1
            max_busy = max(max_busy, busy)
            schedule(end, "environment", task, turn)
    assert len(completed) == len(traces) and not pending and busy == active == 0
    ordered = sorted(completed.values())
    t95 = ordered[ceil(.95 * len(ordered)) - 1] if ordered else 0
    end = ordered[-1] if ordered else 0
    return {"makespan": end, "tail5": end - t95,
            "mean_completion": sum(ordered) / len(ordered) if ordered else 0,
            "completed": completed, "spans": spans, "max_busy": max_busy}


def checks():
    short = Trace((1., 1.), (2.,))
    assert run([short], samples=1)["makespan"] == 4
    assert run([short] * 3, samples=1)["makespan"] == 12
    assert run([short] * 3, samples=3)["makespan"] == 8
    for policy in ["fcfs", "caas"]:
        r = run([short] * 3, samples=3, environments=2, policy=policy)
        assert r["max_busy"] <= 2 and r["makespan"] == 6
        assert sum(e-s for _, _, _, s, e in r["spans"]) == 6
    # Earlier arrival bands outrank later bands regardless of observed depth.
    assert (0, -1, 5, 1) < (1, -100, 1, 2)
    try:
        Trace((1.,), (2.,))
    except AssertionError:
        pass
    else:
        raise AssertionError("invalid dependency chain accepted")
    return short

if __name__ == "__main__":
    short = checks()
    print("checks=passed")
    for policy in ["fcfs", "caas"]:
        for capacity in [1, 3]:
            r = run([short] * 3, samples=capacity, policy=policy)
            print(f"{policy} C_S={capacity} C_E=1 makespan={r['makespan']:.1f}s")
    # A broader synthetic comparison, with identical traces for both policies.
    import random
    rng = random.Random(17)
    traces = []
    for _ in range(50):
        turns = rng.choice([1, 2, 8, 16])
        traces.append(Trace(tuple(float(rng.randint(1, 4)) for _ in range(turns+1)),
                            tuple(float(rng.randint(1, 6)) for _ in range(turns))))
    for policy in ["fcfs", "caas"]:
        r = run(traces, samples=20, environments=3, policy=policy)
        print(f"{policy} mixed makespan={r['makespan']:.1f}s tail5={r['tail5']:.1f}s "
              f"mean={r['mean_completion']:.2f}s")
Fije trazas, orden,
Ejercicios originales, no preguntas reales de empresas
¿Cómo puede empeorar TPOT y mejorar el makespan?
Pista
Competencia individual frente a solapamiento.
Respuesta y análisis
Más concurrencia puede ralentizar cada decode y mantener más etapas independientes activas. Optimice makespan sujeto a SLO, y publique ambas métricas.
¿El 65% mide solo CAAS?
Pista
Elija una comparación con un único cambio.
Respuesta y análisis
No: 168.2 frente a 163.0 min da 3.1% incremental en Ling-3.0 MCP-Atlas. 466.1 frente a 163.0 mide la combinación y usa otro denominador.
¿Y si queda la etiqueta pero se expulsa la caché?
Pista
Afinidad no es almacenamiento.
Respuesta y análisis
Se mantiene el routing, pero aumenta prefill. Mida tokens reutilizados y trabajo nuevo; reconstruya contexto autorizado, sin aceptar datos antiguos o ajenos por una etiqueta.
¿Repetir un pago tras timeout?
Pista
Separe semáforos y efectos externos.
Respuesta y análisis
No ciegamente. Registre incertidumbre, reconcilie el ID con pagos y respete idempotencia. Liberar capacidad no revierte el pago ni justifica duplicarlo.
Rúbrica: 1—nombra la métrica; 2—distingue cola, admisión y ejecución; 3—deriva el ejemplo y ejecuta el código; 4—diseña comparaciones y explica regresiones; 5—incluye fallos, inquilinos y despliegue justificado. Dominar exige capacidades, no solo tiempo de lectura.
Predecir, comprobar y conservar evidencia
Antes de revelar la respuesta, predice un resultado. Después registra diferencias y una prueba de transferencia. Se guarda localmente y se comparte entre idiomas.
Abrir cuaderno / exportar / borrar →El alcance de revisión matemática se registra por lección. No certifica reproducción empírica del artículo; anota posibles errores. Alcance de revisión
Referencias y aprendizaje adicional
Artículo de Wei Feng et al., Ling Team, Ant Group, v1 bajo CC BY 4.0. Fórmulas, métodos y tabla seleccionada son adaptaciones atribuidas. Diagramas, ejemplos y simulador son originales de Token Lab. No se verificó un repositorio de implementación del artículo; el simulador no es código de los autores.
- arXiv · abstract / v1https://arxiv.org/abs/2611.16661v1
- arXiv · PDF / v1https://arxiv.org/pdf/2611.16661v1
- arXiv · full HTML / v1https://arxiv.org/html/2611.16661v1
- CC BY 4.0https://creativecommons.org/licenses/by/4.0/
- SGLang · sourcehttps://github.com/sgl-project/sglang
- Stanford CS329Z · Engineering AI Agentshttps://cs329z.stanford.edu/