OCR e IA documental: principios, frameworks y panorama empresarial
Del píxel al registro verificable: OCR neuronal, estructura, tablas, VLM, evidencia, costes, herramientas abiertas y empresas de IA documental.
Fuentes y versiones
En este artículo
1. Una factura revela qué debe entregar el sistema
Un PDF de tres páginas contiene una factura digital, una modificación fotografiada y una tabla continuada. El usuario necesita Word editable, Excel verificable y campos para contabilidad. Leer caracteres solo resuelve una parte. Esta guía para desarrolladores y responsables de producto sigue el documento hasta un registro respaldado por evidencia; permite elegir componentes y ejecutar una validación local.
OCR reconoce caracteres. El análisis documental recupera párrafos, títulos, tablas y orden de lectura. La extracción asigna evidencia a un esquema; IDP añade clasificación, validación, revisión e integración. PDF es un contenedor, no una indicación de que haga falta OCR. Una página puede combinar texto y regiones escaneadas.
| Capa | Entrada → salida | Fallo típico |
|---|---|---|
| Reconocimiento | Píxeles → caracteres, posiciones, puntuaciones | Confundir 0/O, omitir líneas |
| Análisis | Regiones → bloques, celdas y relaciones | Mezclar columnas |
| Extracción | Evidencia + esquema → campos tipados | Confundir vencimiento y emisión |
| Flujo | Registro validado → acción controlada | Duplicados, pago incorrecto |
Fuentes oficiales comprobadas el 16 de noviembre de 2026. Las recomendaciones son juicio técnico, no un benchmark uniforme. El alcance incluye documentos impresos, escritura manual común y extracción; no todas las escrituras históricas ni la autenticidad documental.
2. Examinar el archivo antes de usar visión
Un PDF digital puede contener texto, fuentes y coordenadas aprovechables. Su orden de dibujo puede diferir del orden de lectura y sus mapas de caracteres pueden estar dañados. Un escaneo suele contener imágenes, quizá con OCR antiguo invisible. Tener capa de texto no demuestra que sea correcta. Contrastar cobertura y geometría con la página visible.
Limitar bytes, páginas y píxeles decodificados; tratar cifrado y archivos corruptos; decidir por página. Usar extracción nativa para contenido útil y renderizado/OCR para escaneos. PDF.js carga y representa PDF y permite acceder a objetos de texto; no es un modelo OCR.[S33] Aislar decodificadores ante archivos no confiables.
A4 a 300 DPI ocupa aproximadamente 2480×3508 píxeles, unos 33,2 MiB en RGBA. Diez páginas residentes superan 330 MiB antes de tensores y copias. El límite de subida no es un límite seguro de decodificación simultánea. Procesar por cola de páginas y liberar memoria. Más resolución conserva letra pequeña pero aumenta coste; ampliar no recupera de forma fiable detalles perdidos.
3. Cómo reconoce texto una cadena OCR
La cadena habitual corrige orientación o perspectiva, detecta regiones, recorta líneas, reconoce secuencias y posprocesa. Binarizar puede eliminar decimales; quitar ruido puede borrar trazos. Conservar el original y medir cada transformación.
Detectar localiza; reconocer transcribe. DB integra el aprendizaje del umbral en la detección por segmentación.[S3] Un reconocedor CTC representativo transforma una imagen H×W×3 en características T×d y puntuaciones T×(|V|+1), incluido blank. No todos los modelos usan esa arquitectura.
CTC suma rutas compatibles sin exigir alineación individual de caracteres. Primero agrupa repeticiones consecutivas y después elimina blank: h,h,blank,i → hi; l,blank,l → ll. El entrenamiento sí requiere imágenes y transcripciones correctas; la decodificación voraz no garantiza la cadena más probable.[S2]
x es la imagen de línea, y la secuencia objetivo, π una ruta con blank, B el colapso, T los pasos visuales y p_t la probabilidad de etiqueta. La pérdida es el logaritmo negativo de la probabilidad objetivo. Ejemplo original de dos pasos: A/blank tienen (0.6,0.4) y (0.5,0.5). AA, A blank y blank A dan A; suman 0.3+0.3+0.2=0.8. Dos blank tienen probabilidad 0.2.
Tesseract moderno incorpora reconocimiento neuronal LSTM.[S1] La diferencia actual no es simplemente “OCR sin IA” frente a “OCR con IA”, sino representación, estructura, generación y verificación.
4. Estructura, orden y tablas
Reconocer todas las letras no evita intercalar dos columnas o asociar 80.00 con la fila equivocada. La posición espacial y la relación semántica son necesarias. El análisis identifica regiones; el orden conecta bloques; las tablas requieren filas, columnas, celdas fusionadas y relaciones con encabezados.
Las líneas ayudan en tablas con bordes; las tablas sin bordes dependen de alineación y estructura visual. Para unir páginas, comprobar significado de columnas, unidades y encabezados repetidos. Markdown sirve para tablas simples; HTML o un grafo de celdas conserva spans complejos. Excel debe contener fechas y números tipados.
Una representación intermedia conserva página, bloque, tipo, texto original, coordenadas, orden, celdas y versión. Desde ella se generan Markdown, Word, Excel e índices. Edición cómoda y reproducción visual exacta son objetivos distintos. El texto fluido facilita editar; las cajas absolutas pueden reproducir el aspecto y dificultar cambios.
5. Cuatro formas de ayudar al OCR con IA
La primera corrige propuestas a partir de texto OCR, alternativas y recortes. El contexto lingüístico ayuda a la prosa, pero nombres y códigos raros pueden ser correctos. Fluidez no equivale a fidelidad. Separar texto original, valor normalizado y corrección propuesta.
La segunda combina texto, posición e imagen: LayoutLMv3 representa esta familia para clasificación y campos, sin eliminar necesariamente el OCR.[S4] La tercera genera secuencias desde la imagen: Donut elimina el componente OCR separado, pero conserva riesgos de omisión, alucinación y cambio de distribución.[S5]
La cuarta es híbrida: ruta económica para páginas comunes, relectura especializada o VLM para regiones difíciles, extracción y validación. Más pasadas añaden coste. Dos modelos pueden compartir sesgos; su acuerdo no prueba independencia. Un sistema agentic necesita límites de relectura y condiciones de parada.
6. VLM: lectura visual y riesgo de invención
Un modelo de visión y lenguaje codifica páginas o recortes en tokens visuales y genera texto, Markdown o JSON. Mosaicos y resolución dinámica equilibran letra pequeña y presupuesto. Los modelos generales abarcan muchas tareas; los documentales se concentran en texto, tablas y fórmulas. PaddleOCR distingue reconocimiento, análisis estructural y VLM documental.[S6][S7]
DeepSeek-OCR y OCR 2 investigan representaciones visuales y recuperación/compresión de texto.[S16][S17] Menos tokens visuales no demuestran menor coste total: contar renderizado, codificación, salida, reintentos y revisión. Una compresión excesiva perjudica números largos y símbolos raros.
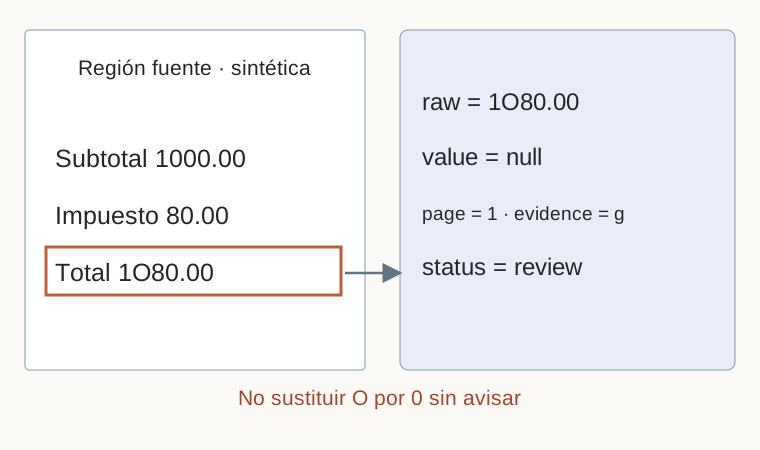
Para transcripción, permitir null o incertidumbre y prohibir completar lo ilegible. Guardar interpretación por separado. JSON válido garantiza forma, no veracidad. Un importe con formato impecable puede no estar respaldado por la página.
7. Campos con evidencia, tipos y reglas
Conservar texto original, valor, moneda, página, región, bloque, versiones y estado. Declarar origen, unidades y rotación de coordenadas, y transformar de vuelta a la página original.
| Campo | Ejemplo | Propósito |
|---|---|---|
| raw / value | 1O80.00 / null | Mantener ambigüedad |
| evidence_id / page | g / 1 | Volver a la fuente |
| bbox / coordinate_system | [0.6,0.8,0.9,0.84] / normalized_xyxy | Superposición de revisión |
| model_version / schema_version | Identificadores fijos | Reproducibilidad |
| status / reasons | review / ambiguous_digit | Explicar bloqueo |
Interpretar 1,234 y 1.234 según una convención regional declarada; no borrar puntuación para adivinar. Usar Decimal y reglas de impuestos, descuentos y redondeo. Que la suma coincida no prueba autenticidad. Un documento falso puede cuadrar; cambiar una cuenta exige verificación y autorización independientes.
Si el análisis omitió un valor, cambiar el esquema no lo recupera. Revisar página y parse antes de elegir nueva lectura o nuevo esquema.[S20]
8. Arquitectura de producto
El navegador selecciona, previsualiza, evalúa calidad y reconoce localmente. El servidor controla identidad, aislamiento, acceso pagado, trabajos por página, colas, modelos, evidencia, reglas y exportación. La ruta gratuita sin inferencia pagada requiere controles en el servidor.
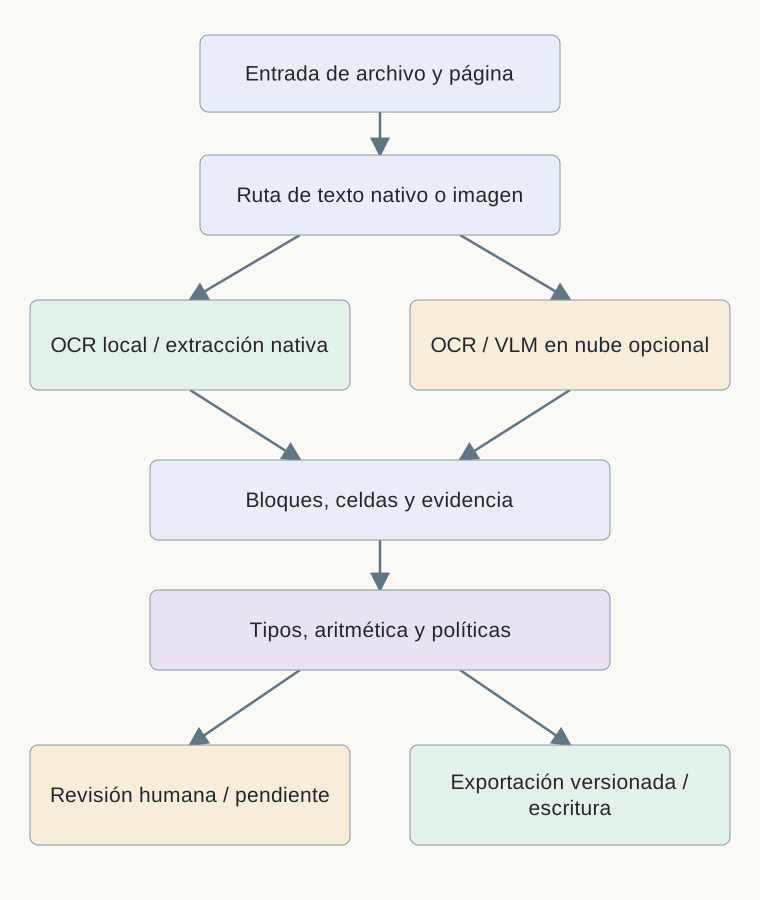
Registrar queued, processing, needs_review, completed y failed por página, además del conjunto esperado. La identidad del reintento liga organización, contenido, página y configuración. Reprocesar crea versión; un timeout requiere consultar el trabajo del proveedor antes de reenviarlo. Cancelar detiene lo pendiente y comunica el consumo ya ocurrido.
Explicar qué páginas o recortes salen del dispositivo. Definir cachés, registros, conservación del proveedor y borrado. No prometer trazabilidad permanente si se elimina toda evidencia. Las instrucciones dentro del documento son datos, no permisos para correo, red o pagos.
9. Frameworks que conviene evaluar
No existe un ganador universal. Esta lista orienta pruebas, no clasifica rendimiento. Framework, pesos, runtime y servicio son entregables diferentes.
| Candidato | Caso a evaluar | Límite o decisión |
|---|---|---|
| PaddleOCR: PP-OCR / PP-StructureV3 / VL | Texto multilingüe y estructura | Medir rutas por separado [S6][S7] |
| PaddleOCR.js | Detección/reconocimiento en navegador | No es toda la cadena de servidor [S8] |
| Tesseract / Tesseract.js | Impresión clara y WASM | JS requiere renderizar PDF primero [S1][S9] |
| RapidOCR | Despliegue CPU/ONNX y otros motores | Runtime, no flujo empresarial [S10] |
| Docling | Representación unificada multiformato | MIT para código; modelos aparte [S11] |
| MinerU | PDF científico, fórmulas y estructura | Verificar versión, backend y licencias [S12] |
| Marker + Surya | Markdown/JSON y procesamiento híbrido | Apache-2.0 código; pesos condicionados [S13][S14] |
| olmOCR | Texto de PDF para corpus | Objetivo distinto al contable [S15] |
| Unstructured | Partición y RAG | Añadir validación de campos [S26] |
| Donut / LayoutLMv3 / DeepSeek-OCR | Investigación y ajuste específico | No sustituyen todo el producto [S4][S5][S16] |
La documentación oficial de PaddleOCR.js no elimina las pruebas de assets, workers y compatibilidad.[S8] Funcionar en Python no prueba rendimiento en iPhone. Marker separa código y condiciones comerciales de pesos; los forks antiguos pueden describir licencias obsoletas.[S34] Fijar commit, modelos y dependencias.
10. Empresas y productos documentales
Se incluyen startups y empresas de crecimiento; no se clasifican independencia accionarial, ingresos o cuota. Las preguntas son propuestas de compra, no defectos demostrados.
| Empresa | Enfoque público | Qué comprobar |
|---|---|---|
| Reducto | OCR + VLM en varias pasadas [S18] | Mejora frente a coste y espera |
| Extend | Parse, extract, classify, split, workflows [S19] | Diagnóstico de omisiones anteriores |
| Datalab | API y ecosistema Marker/Surya [S32][S13] | API frente a autoalojamiento |
| LandingAI ADE | Análisis y grounding fino [S21] | Precisión de citas en importes |
| LlamaIndex / LlamaParse | Parse, Extract, Classify, Split, Index [S22] | Integración y versiones RAG |
| Nanonets | Extracción, aprobación y revisión [S23] | Tiempo manual realmente ahorrado |
| Mindee | Campos, coordenadas y confianza [S24] | Tipos y controles de revisión |
| Instabase | Aplicaciones y validación empresarial [S25] | Flujo organizativo y despliegue |
| Unstructured | ETL e ingestión para IA [S26] | Actualización, borrado y reindexación |
| Rossum | Automatización transaccional y reglas [S31] | Umbrales adecuados al riesgo |
Mistral Document AI es otro servicio especializado; Textract representa relaciones de tablas y Google Document AI ofrece rutas OCR y de estructura.[S27][S28][S29][S35] No todos son startups OCR. Casos públicos y rankings comerciales orientan, pero no sustituyen la aceptación propia.
11. Aplicaciones y valor comercial
El valor se desplaza de reconocer letras a cubrir documentos difíciles, conservar evidencia, revisar rápido e integrar sistemas. Nuestra interpretación: las API compiten en adopción y fiabilidad; plataformas, en excepciones y organización; productos verticales, en esquemas, distribución y resultados. Una página comercial no demuestra retención ni ventaja defensible.
Facturas: proveedor, impuestos y duplicados. Extractos: débito/crédito, continuidad y saldos. Seguros: separar expedientes y detectar faltantes. RAG: jerarquía, orden y borrado. Accesibilidad: lectura utilizable y lenguaje. Markdown útil para búsqueda puede ser insuficiente para contabilizar.
Casillas, tachados, revisiones y notas pueden cambiar significado. Detectar firma no la autentica. Prometer transacciones verificables o campos revisables, con controles profesionales en ámbitos sensibles, en lugar de comprensión universal.
12. Calidad y coste con denominadores correctos
CER divide sustituciones, borrados e inserciones por caracteres de referencia y puede superar 100%. Declarar normalización Unicode, espacios, puntuación y mayúsculas. Cambiar 1080.00 por 1O80.00 produce un error pero invalida el importe. CER bajo no garantiza campos fiables.
S/D/I cuentan sustituciones, borrados e inserciones; N_ref es longitud de referencia. N son documentos, r fracción de nube, h de revisión, c_b/c_a/c_h costes unitarios, F coste fijo y N_valid documentos aceptados.
Evaluar estructura y contenido de celdas, orden, campos, ausencias, citas y tipos. Medir cobertura de liberación automática y error entre lo liberado. Una puntuación OCR no es automáticamente una probabilidad calibrada del campo. Calibrar con datos reservados por idioma, calidad y clase. OmniDocBench ayuda a evaluar parsing, sin reemplazar pruebas del dominio.[S30]
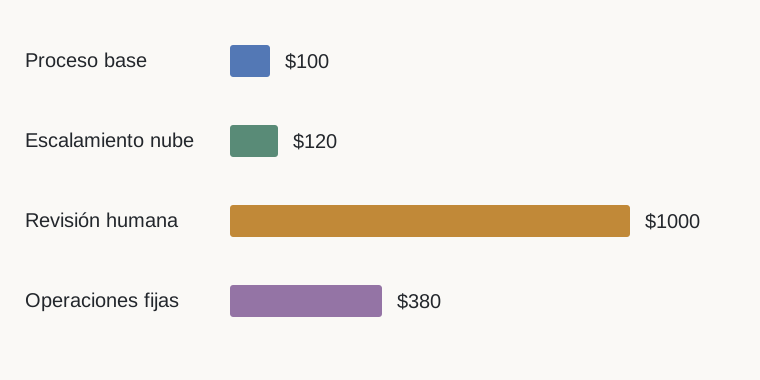
Ejemplo inventado: 10000 documentos de una página; $0.01 base; 15% nube a $0.08; 5% revisión a $2; $380 fijos. Total $100+$120+$1000+$380=$1600. Con 8000 validados son $0.20 cada uno. Nube y revisión pueden coincidir; los fallos siguen costando. El precio de inferencia puede ser minoritario. No son tarifas de proveedores.
13. Ruta práctica para un producto como PageOCR
Basic: extracción nativa cuando sirva, PaddleOCR.js/Tesseract.js comparados en dispositivos reales para escaneos, cola por página y cancelación. No escalar usuarios gratuitos a inferencia pagada sin control. Aún existen costes de descarga, alojamiento y dispositivo.
Pro: comparar PP-StructureV3, Docling, MinerU y Marker en tablas y diseños propios; mantener pocos candidatos complementarios. Plus: relectura VLM controlada, extracción y validación con costes explícitos. Alojar la web en el edge no implica que el modelo quepa en ese runtime.
Para extractos bancarios: evidencia por transacción, dirección débito/crédito, saldo inicial más variación igual a saldo final y exportación tipada. El valor es menos correcciones, verificación sencilla y exportaciones utilizables. Empezar por una familia de formatos; no hace falta entrenar un modelo fundacional.
14. Implementación mínima y aceptación
El experimento Python 3.11+ usa biblioteca estándar y OCR sintético; no ejecuta inferencia visual ni API. Implementa CER NFC, evidencia, coordenadas, Decimal y bloqueo de cambio de cuenta. Un registro limpio es validated_candidate, nunca permiso de pago.
También ejecutamos Tesseract 5.5.0 con datos ingleses sobre la imagen sintética de impresión clara. Recuperó las cuatro líneas con identificador e importes correctos; se conserva la línea vacía. Este smoke test no demuestra precisión en escaneos, escritura manual, otros idiomas o facturas reales.
ocr-invoice-smoke.png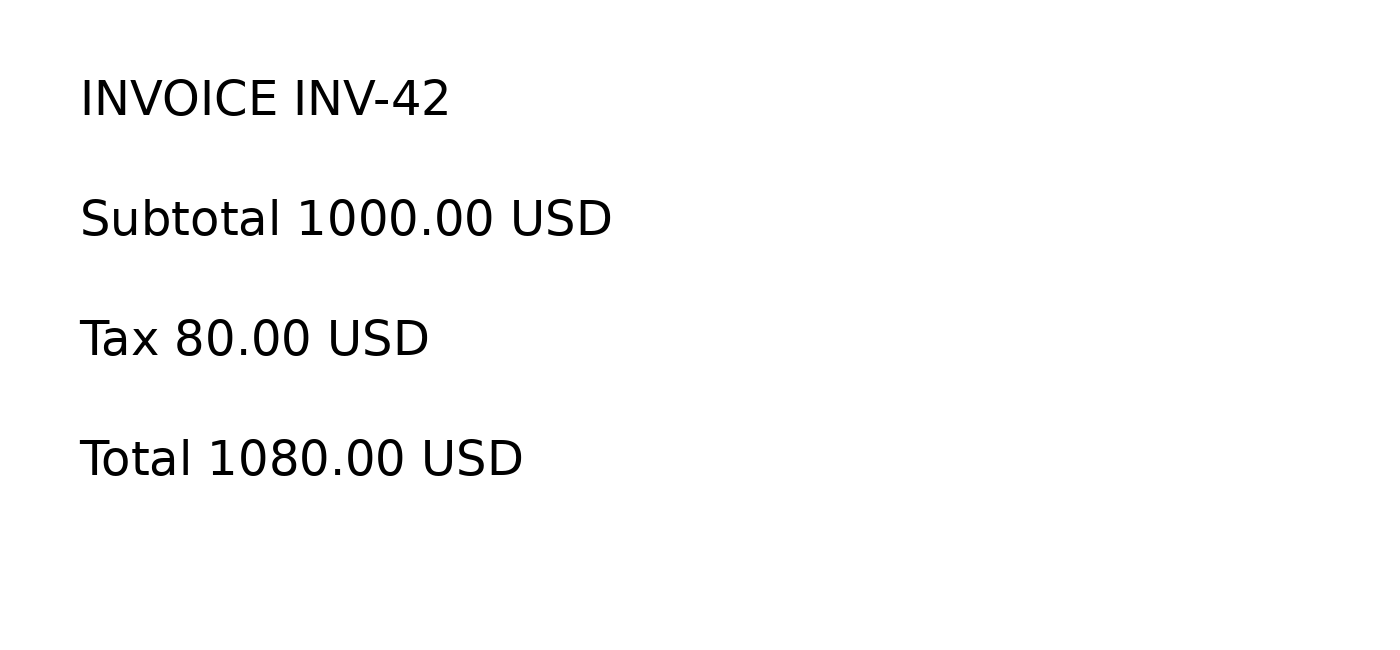
tesseract ocr-invoice-smoke.png stdout -l eng --psm 6INVOICE INV-42
Subtotal 1000.00 USD
Tax 80.00 USD
Total 1080.00 USDValidación local · Python 3.11+
ocr-evidence-gate.pypython3 ocr-evidence-gate.pySalida esperada
checks=11 clean=validated_candidate ambiguous=review cer=0.142857
synthetic_cost=1600.00 cost_per_validated_document=0.20
Python · ocr-evidence-gate.py
"""Python 3.11+, standard library. Synthetic OCR output, no image inference/API.
The gate checks provenance and arithmetic, not document authenticity.
"""
from decimal import Decimal, InvalidOperation
from copy import deepcopy
import unicodedata

def distance(a, b):
    row = list(range(len(b) + 1))
    for i, x in enumerate(a, 1):
        nxt = [i]
        for j, y in enumerate(b, 1):
            nxt.append(min(nxt[-1] + 1, row[j] + 1, row[j-1] + (x != y)))
        row = nxt
    return row[-1]

def cer(reference, prediction):
    # NFC Unicode code points; whitespace and case remain significant.
    a, b = (unicodedata.normalize('NFC', x) for x in (reference, prediction))
    if not a:
        raise ValueError('CER requires a nonempty reference')
    return distance(a, b) / len(a)

def validate(record, evidence):
    reasons = []
    values = {}
    for name in ('subtotal', 'tax', 'total'):
        field = record.get(name, {})
        source = evidence.get(field.get('evidence_id'))
        if not source or field.get('raw') != source.get('text'):
            reasons.append(name + ':missing_or_changed_evidence')
            continue
        bbox = source.get('bbox', [])
        if (source.get('page', 0) < 1 or len(bbox) != 4
            or not all(isinstance(x, (int, float)) and 0 <= x <= 1 for x in bbox)
            or not (bbox[0] < bbox[2] and bbox[1] < bbox[3])):
            reasons.append(name + ':invalid_source_region')
        # Fixed fixture convention: dot decimal, USD, no grouping separators.
        try:
            value = Decimal(field['raw'])
            if not value.is_finite() or value < 0 or value.as_tuple().exponent < -2:
                raise InvalidOperation
            values[name] = value
        except (InvalidOperation, ValueError, TypeError):
            reasons.append(name + ':unresolved_numeric_text')
    if record.get('currency') != 'USD':
        reasons.append('currency:unsupported')
    if record.get('account_changed'):
        reasons.append('account_change:independent_verification_required')
    if len(values) == 3 and values['subtotal'] + values['tax'] != values['total']:
        reasons.append('amounts:inconsistent')
    return ('review' if reasons else 'validated_candidate'), reasons

E = {k: {'text': v, 'page': 1, 'bbox': [0.6, y, 0.9, y + .04]}
     for k, v, y in [('s', '1000.00', .6), ('t', '80.00', .7), ('g', '1080.00', .8)]}
R = {'currency': 'USD', 'account_changed': False,
     **{n: {'raw': E[k]['text'], 'evidence_id': k}
        for n, k in [('subtotal', 's'), ('tax', 't'), ('total', 'g')]}}

def main():
    assert validate(R, E)[0] == 'validated_candidate'
    wrong = deepcopy(R); wrong['total']['raw'] = '1090.00'
    assert validate(wrong, E)[0] == 'review'  # invented correction has no evidence
    ambiguous = deepcopy(R); ambiguous['total']['raw'] = '1O80.00'
    ambiguous_e = deepcopy(E); ambiguous_e['g']['text'] = '1O80.00'
    assert validate(ambiguous, ambiguous_e)[0] == 'review'  # never guess O -> 0
    bad_sum_e = deepcopy(E); bad_sum_e['g']['text'] = '1090.00'
    bad_sum = deepcopy(R); bad_sum['total']['raw'] = '1090.00'
    assert validate(bad_sum, bad_sum_e)[0] == 'review'  # evidence exists, sum fails
    missing = deepcopy(R); missing['total']['evidence_id'] = 'not-found'
    assert validate(missing, E)[0] == 'review'
    changed = deepcopy(R); changed['account_changed'] = True
    assert validate(changed, E)[0] == 'review'
    bad_box = deepcopy(E); bad_box['g']['bbox'] = [.9, .8, .6, .7]
    assert validate(R, bad_box)[0] == 'review'
    nonfinite = deepcopy(R); nonfinite['total']['raw'] = 'NaN'
    nonfinite_e = deepcopy(E); nonfinite_e['g']['text'] = 'NaN'
    assert validate(nonfinite, nonfinite_e)[0] == 'review'
    assert cer('1080.00', '1O80.00') == 1 / 7
    assert cer('café', 'cafe\u0301') == 0
    print('checks=11 clean=validated_candidate ambiguous=review cer=0.142857')
    print('synthetic_cost=1600.00 cost_per_validated_document=0.20')
    assert Decimal(10000) * Decimal('.01') + Decimal(10000) * Decimal('.15') * Decimal('.08') + Decimal(10000) * Decimal('.05') * Decimal('2') + Decimal('380') == Decimal('1600')
    # A real deployment also needs authentication, anti-tamper checks, taxes/rounding
    # rules, independent payment authority and immutable source versioning.
if __name__ == '__main__':
    main()
Docling puede convertir un PDF local antes de adaptarlo al esquema de evidencia; el SDK del navegador recibe imágenes renderizadas. Los siguientes puntos de partida proceden de documentación, no de una ejecución con pesos descargados en esta revisión. Fijar versiones antes de producción.[S8][S11]
Ejemplos adaptados de documentación · no ejecutados aquí
from docling.document_converter import DocumentConverter

# Install docling in an isolated environment; pin the tested version.
converted = DocumentConverter().convert("sample.pdf")
markdown = converted.document.export_to_markdown()
# Adapt structured document items and provenance separately for field review.
import { PaddleOCR } from "@paddleocr/paddleocr-js";
// Pass a rendered page image (Blob), not raw PDF bytes.
const engine = await PaddleOCR.create({
lang: "ch", ocrVersion: "PP-OCRv5",
ortOptions: { backend: "wasm" }
});
try {
const [page] = await engine.predict(pageImageBlob);
console.log(page.items);
} finally {
engine.dispose();
}Separar evaluación por plantilla/proveedor, idioma, dispositivo y tiempo. Comparar extracción nativa, OCR, parsing, VLM e híbridos con originales y presupuesto iguales. Medir descarga, arranque, memoria máxima, p95, liberación errónea y coste. Empezar con cientos de páginas que cubran fallos y ampliar según riesgo; ningún número universal garantiza fiabilidad.
Probar páginas vacías, decimales tenues, rotación, columnas, tablas continuadas, idiomas mezclados, escritura superpuesta, capa textual errónea, duplicados, fallo parcial, evidencia falsa, cambio de cuenta e instrucciones maliciosas. Ejercicios: explicar por qué 99% de caracteres no valida importes; diseñar reintentos por página; comparar todo-VLM con escalamiento selectivo al mismo coste; elegir umbral y reportar cobertura/error. El mejor framework se decide con documentos propios.
Predecir, comprobar y conservar evidencia
Antes de revelar la respuesta, predice un resultado. Después registra diferencias y una prueba de transferencia. Se guarda localmente y se comparte entre idiomas.
Abrir cuaderno / exportar / borrar →El alcance de revisión matemática se registra por lección. No certifica reproducción empírica del artículo; anota posibles errores. Alcance de revisión
Fuentes primarias y lecturas
Fuentes comprobadas el 16 de noviembre de 2026. Funciones según documentación oficial; recomendaciones editoriales, sin benchmark uniforme. El experimento usa OCR sintético.
- S1 · Tesseract documentation — neural OCRhttps://tesseract-ocr.github.io/tessdoc/ · 2026-11-16
- S2 · Graves et al., CTC — ICML 2006https://www.cs.toronto.edu/~graves/icml_2006.pdf · 2026-11-16
- S3 · Differentiable Binarization — AAAI 2020 / arXiv v2https://arxiv.org/abs/1911.08947v2 · 2026-11-16
- S4 · LayoutLMv3 — official implementation, 2022https://github.com/microsoft/unilm/tree/master/layoutlmv3 · 2026-11-16
- S5 · Donut — OCR-free document understanding, ECCV 2022https://github.com/clovaai/donut · 2026-11-16
- S6 · PaddleOCR 3.0 Technical Report — 2025https://arxiv.org/abs/2507.05595 · 2026-11-16
- S7 · PaddleOCR — official repositoryhttps://github.com/PaddlePaddle/PaddleOCR · 2026-11-16
- S8 · PaddleOCR.js — official browser deploymenthttps://github.com/PaddlePaddle/PaddleOCR/blob/main/docs/version3.x/inference_deployment/cross_platform/browser.en.md · 2026-11-16
- S9 · Tesseract.js — README and PDF limitationhttps://github.com/naptha/tesseract.js · 2026-11-16
- S10 · RapidOCR — runtime toolkithttps://github.com/RapidAI/RapidOCR · 2026-11-16
- S11 · Docling — conversion and separate model licenseshttps://github.com/docling-project/docling · 2026-11-16
- S12 · MinerU — official document parserhttps://github.com/opendatalab/MinerU · 2026-11-16
- S13 · Marker — modes, hybrid processing and licensinghttps://github.com/datalab-to/marker · 2026-11-16
- S14 · Surya — OCR and layouthttps://github.com/datalab-to/surya · 2026-11-16
- S15 · olmOCR — PDF linearization toolkithttps://github.com/allenai/olmocr · 2026-11-16
- S16 · DeepSeek-OCR — optical compression research, 2025https://arxiv.org/abs/2510.18234 · 2026-11-16
- S17 · DeepSeek-OCR 2 — Visual Causal Flow, 2026https://arxiv.org/abs/2601.20552 · 2026-11-16
- S18 · Reducto — product architecture overviewhttps://reducto.ai/ · 2026-11-16
- S19 · Extend — parsing and extraction platformhttps://docs.extend.ai/ · 2026-11-16
- S20 · Extend — extraction depends on parse evidencehttps://docs.extend.ai/extraction/overview · 2026-11-16
- S21 · LandingAI — ADE second generationhttps://landing.ai/blog/introducing-agentic-document-extraction-gen2 · 2026-11-16
- S22 · LlamaIndex — LlamaParse platformhttps://developers.llamaindex.ai/llamaparse/ · 2026-11-16
- S23 · Nanonets — document processing APIhttps://docs.nanonets.com/v4/reference/overview · 2026-11-16
- S24 · Mindee — extraction capabilitieshttps://docs.mindee.com/getting-started/key-features · 2026-11-16
- S25 · Instabase — validation rules and reviewhttps://docs.instabase.com/automate/validating-documents · 2026-11-16
- S26 · Unstructured — open-source document ETLhttps://github.com/Unstructured-IO/unstructured · 2026-11-16
- S27 · Mistral — OCR processorhttps://docs.mistral.ai/studio/document-processing/basic_ocr · 2026-11-16
- S28 · Amazon Textract — table structurehttps://docs.aws.amazon.com/textract/latest/dg/how-it-works-tables.html · 2026-11-16
- S29 · Google Document AI — OCRhttps://docs.cloud.google.com/document-ai/docs/enterprise-document-ocr · 2026-11-16
- S30 · OmniDocBench — benchmark and evaluation codehttps://github.com/opendatalab/OmniDocBench · 2026-11-16
- S31 · Rossum — automation criteriahttps://knowledge-base.rossum.ai/docs/guide-to-automation-process-in-rossum · 2026-11-16
- S32 · Datalab — document intelligence APIhttps://www.datalab.to/ · 2026-11-16
- S33 · Mozilla PDF.js — parsing and renderinghttps://mozilla.github.io/pdf.js/ · 2026-11-16
- S34 · Marker — model weight licensehttps://github.com/datalab-to/marker/blob/master/MODEL_LICENSE · 2026-11-16
- S35 · Google Document AI — layout parserhttps://docs.cloud.google.com/document-ai/docs/layout-parse-chunk · 2026-11-16