OCR 与 AI 文档识别全景:原理、工程、框架与创业公司
从像素到可验证的业务记录:系统讲清神经网络 OCR、版面与表格、VLM、证据校验、成本,以及开源框架和文档 AI 公司如何选。
来源与版本详情
本文目录
1. 从一张发票开始:到底要交付什么
假设用户上传一份三页 PDF:第一页是可选中文字的发票,第二页是手机拍摄的盖章补充说明,第三页是跨页明细。用户希望得到可编辑 Word、可核对 Excel,以及能够进入财务系统的字段。“把图片变成文字”只完成了其中一部分。本文面向开发者与产品负责人,解释从像素、文字、版面到业务记录的全过程。读完后,你应能选出合理的技术组合,解释错误出现在哪一层,并运行证据校验实验。
OCR 是 Optical Character Recognition,光学字符识别;文档解析恢复段落、标题、表格与阅读顺序;信息抽取把内容映射为发票号、金额等字段;IDP(智能文档处理)进一步组织分类、校验、复核和业务写入。PDF 是容器,文件扩展名不能决定是否需要 OCR。一页里也可能同时存在可用文字层与扫描图片。
| 层级 | 输入与输出 | 典型失败 |
|---|---|---|
| 文字识别 | 像素 → 字符、坐标、识别分数 | 0/O、1/I、漏行 |
| 文档解析 | 区域与文字 → 段落、单元格、关系 | 双栏串行、表头错配 |
| 字段抽取 | 文档证据 + schema → 结构化字段 | 把付款期限当发票日期 |
| 业务处理 | 已校验字段 → 可追踪记录与动作 | 重复入账、错误付款 |
本文的框架建议属于选型判断,厂商功能依据截至 2026-11-16 核对的官方资料;不声称对所有产品做过同口径性能测试。这里的“全部讲清楚”限定为印刷文档、常见手写与结构化提取,不覆盖所有古文字、医学影像或司法鉴真任务。
2. 先读文件,再决定是否看图
数字生成 PDF 往往保存文字对象、字体编码与位置。优先提取这些对象,可以避免重新识别已经存在的文字,但提取顺序可能是绘制顺序;复制出来的字符串也可能因为字体映射而乱码。扫描 PDF 主要保存页面图像,旧 OCR 则可能藏在不可见的文字层中。有文字层不等于文字层可信。需要检查可见页面与提取内容是否一致、是否缺字、坐标是否合理。
入站阶段先限制文件大小、页数和解码后的像素,识别加密、损坏与混合文档,再按页路由。对数字页使用原生提取与版面恢复,对扫描页进行渲染与识别。PDF.js 的角色是浏览器端 PDF 加载、渲染与文字对象访问;它本身不是 OCR 模型。[S33]渲染器、解码器也应隔离运行,因为上传文件属于不可信输入。
渲染分辨率需要按字高和任务选择。A4 页面以 300 DPI 约为 2480×3508,RGBA 像素本身约占 33.2 MiB;十页同时驻留就超过 330 MiB,尚未计算模型、画布副本和张量。大文件能上传,不代表浏览器应一次解码全部页面。应使用逐页队列、释放画布和可恢复的页级状态。提高分辨率能保住小字,也会增加内存和推理成本;被相机抹掉的细节无法靠放大可靠恢复。
3. 经典 OCR 流水线如何读出文字
常见流水线是方向判断、去倾斜或透视矫正、文字检测、区域裁剪、文字识别及后处理。预处理不是越多越好:二值化可能删掉淡色小数点,去噪可能损害印章与细笔画。保留原图,并用实际错误率判断某项变换是否值得启用。
检测解决“字在哪里”,识别解决“写了什么”。分割式检测器预测文字像素区域,再转换为矩形或多边形。DB(可微二值化)把阈值学习纳入训练,是理解现代文字检测的重要基础。[S3] 裁剪后的行图像可表示为 H×W×3 张量;视觉编码器产生长度为 T、维度为 d 的特征序列,识别头输出 T×(|V|+1) 的字符与 blank 分数。这是代表性 CTC 架构,不能概括所有 OCR 模型。
CTC 用来处理图像时间步与真实字符数不一致的问题。它对所有能够折叠成目标文本的路径求概率和;折叠先合并连续重复标签,再删掉 blank。例如 h,h,blank,i 得到 hi;l,blank,l 得到 ll。训练不需要逐字给出每个像素位置,但仍需要行图像与正确文本配对。贪心解码只是取每步最大标签,并不保证得到总概率最大的字符串。[S2]
其中 x 是行图像,y 是目标字符序列,π 是含 blank 的路径,B 是折叠映射,T 是视觉时间步数,p_t 是第 t 步的标签概率。损失是目标序列概率的负对数。 原创两步算例:词表只有 A 与 blank,第一步概率为 (0.6,0.4),第二步为 (0.5,0.5)。AA、A blank、blank A 都折叠成 A,概率和为 0.3+0.3+0.2=0.8;两个 blank 的概率为 0.2。
Tesseract 的现代版本已有 LSTM 神经网络识别引擎,因此“传统 OCR 没有 AI”是不准确的。[S1] 新一代系统的区别更多在视觉表征、文档结构、生成式解码和验证方式,而不是简单的 AI/非 AI 二分。
4. 版面、阅读顺序与表格才是第二道难关
文字都识别正确,结果仍可能不可用。两栏论文要先读完左栏再读右栏;页眉不应插进句子;表格中的 80.00 必须关联到税额行,而不是隔壁的数量列。坐标提供空间位置,关系决定业务含义。版面模型标注标题、段落、图片、表格等区域;阅读顺序模型决定序列;表格结构恢复则预测行列、合并单元格和表头关联。
有线表格可以结合线段与交点,无线表格更依赖文字对齐与视觉结构。跨页合并还要核对列定义、重复表头、续表标志和单位,不能只因列数相同就拼接。Markdown 表格适合简单矩形;复杂 rowspan/colspan 更适合 HTML 或显式单元格图。输出 XLSX 时应保留数字类型、日期和币种,而不仅是把每个单元格写成字符串。
需要一个中间文档表示:page_id、block_id、区域类型、原始文字、坐标系、阅读顺序、表格单元格与来源版本。它可以派生为 Markdown、搜索索引、Word 或 Excel。生成可编辑文件与像素级还原原版,是不同产品目标。流式 Word 更利于编辑,绝对定位文本框更接近原图,却可能难以继续排版。
5. AI 辅助 OCR:四种用法与各自边界
第一种是 OCR 后处理:把识别文本、候选字与局部截图交给语言模型,修复断行或提出字符更正。对一般散文,语言先验有帮助;对金额、序列号、人名,罕见字符串可能正是正确答案。更流畅不等于更忠实。必须分别保存 raw_text、normalized_value、proposed_correction 与证据,禁止悄悄覆盖原始值。
第二种是带版面的理解模型。LayoutLMv3 等方法联合利用文字、位置和图像,适合字段标注、文档分类等任务;它们不意味着可以跳过输入 OCR。[S4] 第三种是端到端图像到序列,例如 Donut 以图像生成结构化输出,省去独立 OCR 组件,但仍可能漏字、产生幻觉,并受分辨率与训练分布影响。[S5]
第四种是混合或多遍处理:便宜路径先覆盖普通页面,专用模型或 VLM(视觉语言模型)重读复杂区域,再进行字段抽取与规则验证。多遍可以提高机会,也会增加等待与成本。两个模型读出同一结果,可能只是共享相同偏差;不能把一致性当独立证明。Agentic 应体现为有界的重读、工具选择与验证,而不是无限重试的营销标签。
6. VLM 为什么能读文档,也为什么会编造
VLM 将整页或裁剪区域编码为视觉 token,再由解码器结合任务指令生成文本、Markdown 或 JSON。动态分辨率与分块策略在保留小字和控制视觉 token 数之间取舍。通用模型兼顾图像理解和问答,专用文档模型更偏向文字、公式、布局和表格。PaddleOCR 区分文字识别、结构化解析与文档 VLM 系列;这些组件的执行成本和输出契约不同。[S6][S7]
DeepSeek-OCR 及后续 OCR 2 探索视觉编码与文本恢复/压缩,说明“通过视觉表达更多内容”是研究方向。[S16][S17] 但视觉 token 少不自动证明端到端更便宜:还要计入渲染、编码、输出解码、重读和错误复核。压缩过度尤其可能损害小字、长数字和不常见符号。
如果任务是忠实转录,提示词应禁止补全看不清的信息,允许 null 或 uncertain,并要求来源定位。如果任务是总结或推断,应单独存放推断结果。结构化输出只约束形状,不能证明值来自文档。模型生成符合 JSON Schema 的 1080.00,仍可能看错了原图。
7. 抽取字段要有证据、类型与校验
发票 total 不是一个裸字符串。一个可审核字段至少要带原始文字、标准化值、币种、页码、区域、来源块、处理版本和复核状态。坐标要说明是像素还是 0–1 归一化、原点位置,以及是否经过旋转。变换后必须能映射回原页,否则高亮会指到错误位置。
| 字段 | 示例 | 为什么需要 |
|---|---|---|
| raw / value | 1O80.00 / null | 保留 O 与 0 的歧义 |
| evidence_id / page | g / 1 | 回到原始来源 |
| bbox / coordinate_system | [0.6,0.8,0.9,0.84] / normalized_xyxy | 支持人工定位 |
| model_version / schema_version | 固定版本标识 | 重跑与回滚可解释 |
| status / reasons | review / ambiguous_digit | 明确阻塞原因 |
金额解析必须明确地区规则。1,234 与 1.234 在不同环境中可能意义不同,不能删掉所有标点再猜。使用十进制定点运算;检查小计、税、折扣与总额关系,并允许真实业务中的舍入规则。算术一致只是必要检查,不是真实性证明。伪造文档也能账目相平;银行账户变更还需要独立验证和业务授权。
一个重要限制是:如果上游解析漏掉了值,仅改抽取 schema 不能把它找回来;应先查原页与解析结果,再决定重新识别还是调整字段定义。[S20]
8. 从模型到可运行产品:参考架构
浏览器侧负责选择文件、预览、质量提示、本地轻量识别及明确的云端升级入口。服务器侧负责鉴权、租户隔离、计费资格、页级任务、队列、模型路由、证据存储、校验与导出。免费路径能否保持零按页推理费用,取决于服务端是否真正阻止它调用付费模型。只在界面隐藏按钮并不足够。
每页记录 queued、processing、needs_review、completed 或 failed;整份文档保存期望页数与完成页集合。重试键应绑定租户、文件内容、页码与处理配置,重新识别某一页产生新版本,而非重复追加旧结果。异步任务超时后先查询供应商任务状态,避免重复计费。用户取消需要停止待处理页,并诚实报告已经发生的云端调用。
云端升级必须告知用户哪些页面或区域会离开设备。局部裁剪也可能包含个人信息;“不保存原文件”仍需要定义临时缓存、日志、供应商保留与删除时点。引用与证据可以按需要短期保留或由用户持有,不能一边彻底删除一边承诺永久可追溯。外部文档中的指令属于数据,不能使提取 Agent 获得邮箱、网络或财务写入权限。
9. 哪些框架值得优先评测
没有跨所有语言、硬件、版面和任务都最好的单一框架。下表是候选短名单与验证重点;这里的“优先”是工程判断,不是统一 benchmark 排名。框架、模型权重、运行时和 SaaS API 也不是同一种交付物。
| 候选 | 值得评测的任务 | 关键取舍 |
|---|---|---|
| PaddleOCR:PP-OCR / PP-StructureV3 / VL | 多语言文字、结构化文档、复杂区域 | 各路径分别测成本与质量 [S6][S7] |
| PaddleOCR.js | 浏览器本地文字检测与识别 | 不等于整套服务端结构化解析 [S8] |
| Tesseract / Tesseract.js | 清晰印刷、离线基线、浏览器 WASM | JS 包不直接支持 PDF,需先渲染 [S1][S9] |
| RapidOCR | CPU/ONNX 等运行时下部署文字 OCR | 是推理工具链,非业务工作流 [S10] |
| Docling | 多格式文件到统一文档表示 | 代码 MIT;模型另查许可 [S11] |
| MinerU | 论文、公式与复杂 PDF 解析 | 核对所选版本、后端与权重许可 [S12] |
| Marker + Surya | Markdown/JSON、布局与混合处理 | 代码 Apache-2.0;权重另有条件 [S13][S14] |
| olmOCR | 大规模 PDF 文本化与语料处理 | 评测目标与财务字段准确率不同 [S15] |
| Unstructured | 文件分区、连接器与 RAG 数据管道 | 需要另外定义字段与业务验证 [S26] |
| Donut / LayoutLMv3 / DeepSeek-OCR | 研究、微调与特定数据集实验 | 不是直接替代全部生产组件 [S4][S5][S16] |
PaddleOCR.js 官方文档给出了浏览器 SDK,但模型资产、运行时、Worker 与浏览器兼容仍需验证。[S8] 不能把 Python 模型能跑,等同于 iPhone 浏览器能流畅跑。Marker 当前文档区分代码许可和带商业条件的权重许可;旧 fork 的许可摘要可能已经过时。[S34] 选型时保存 commit、模型卡、权重版本和依赖清单,而不是只记录项目名称。
10. 创业公司在卖什么:按价值链理解
市场包括初创团队、已有规模的成长公司和研究型平台;下列不是对独立股权状态、收入或市场份额的排序。产品能力来自官方公开资料,最后一列是本文提出的采购验证问题,不能当成已证实的厂商缺陷。
| 公司 / 产品 | 已公开的产品重心 | 应追问或验证什么 |
|---|---|---|
| Reducto | OCR 与 VLM 多遍文档处理 [S18] | 复杂页增益能否覆盖额外延迟与成本? |
| Extend | 解析、抽取、分类、拆分与工作流 [S19] | 上游漏字段时怎样定位并重跑? |
| Datalab | 文档智能 API,关联 Marker/Surya 生态 [S32][S13] | 自托管与 API 质量、运维和许可怎样取舍? |
| LandingAI ADE | 文档解析与细粒度来源定位 [S21] | 引用能否准确覆盖金额与单元格? |
| LlamaIndex / LlamaParse | Parse、Extract、Classify、Split、Index [S22] | 输出如何接入现有 RAG 与版本管理? |
| Nanonets | 文档提取及审批/复核工作流 API [S23] | 能否缩短人工处理和导入周期? |
| Mindee | 可配置字段、坐标与置信能力 [S24] | 字段是否匹配你的类型与复核要求? |
| Instabase | 企业文档应用、校验与人工审查 [S25] | 复杂组织流程与部署要求能否满足? |
| Unstructured | 文档 ETL 与生成式 AI 数据准备 [S26] | 更新、删除和重建索引是否完整? |
| Rossum | 交易文档自动化与阈值/规则控制 [S31] | 复核与自动放行是否适配业务风险? |
Mistral 的 Document AI 是值得比较的专用服务,不能只视为通用聊天模型。[S27] AWS Textract 提供单元格与表头关系等能力,Google Document AI 有 OCR 和布局处理路径,也应纳入现有云栈的对照候选。[S28][S29][S35] 它们不是本文“初创公司”列表中的同类身份。公开案例和供应商自报排名只能支持采购线索,不能代替你的验收集。
11. 护城河与应用:客户为什么付费
便宜的字符识别不断普及,商业价值会转向难文档覆盖、证据质量、复核效率和业务集成。我们的分析是:API 层竞争接入速度与处理稳定性,工作流平台竞争异常闭环与组织落地,垂直产品竞争行业 schema、客户渠道与任务完成率。某家公司是否真正拥有这些优势,需要用客户留存、实际部署和交付数据验证,不能从产品页反推。
发票和应付账款关心供应商、金额、税与重复单据;银行流水关心借贷方向、跨页交易、余额连续性和 CSV/XLSX 类型;保险材料关心混合文档拆分、缺件与证据;知识库关心阅读顺序、标题关系和更新删除;无障碍阅读关心顺序、语言和图像说明。同一份 Markdown 对 RAG 够用,对财务入账却可能远远不够。
合同中的勾选框、删除线、修订和脚注可能改变法律语义;OCR 不应默默丢掉这些视觉信号。签名检测说明存在类似签名的区域,不等于鉴定签名真实性。医疗或高影响决策场景还需要对应专业流程。产品承诺应落在可验证结果,例如“导出可核对交易记录”,而不是泛泛宣称“读懂一切”。
12. 质量与成本必须用业务分母计算
CER(字符错误率)为替换、删除、插入次数之和除以参考字符数;可以超过 100%。中文通常比按空格分词的 WER 更适合先看字符指标,但必须明确 Unicode、标点、空格与大小写归一化。1080.00 被识别成 1O80.00,只有一个字符错,金额字段却整个不可用。低 CER 不代表高字段正确率。
S、D、I 分别为替换、删除、插入次数,N_ref 是参考字符数。成本公式中 N 为输入文档数,r 为云端升级比例,h 为人工复核比例,c_b、c_a、c_h 分别为基础、升级、复核单价,F 为固定费用,N_valid 为最终验收通过数。
表格要测结构与单元格内容,阅读顺序要测排序,字段要测准确率、缺失率、引用正确性及金额/日期类型。还要报告无需人工的自动通过比例,以及其中错误比例。识别 score 不是已校准的字段正确概率;用保留集按语言、扫描质量和文档类型检查校准,并允许拒答。OmniDocBench 提供文档解析评测工具,但总分不能替代特定业务验收。[S30]
原创假设算例:每月 10000 份单页文档,本地/基础处理均摊 $0.01/份,15% 升级云端 $0.08/份,5% 人工复核 $2/份,固定运维 $380。总计 $100+$120+$1000+$380=$1600;8000 份最终验收通过,单位成本 $0.20/通过文档。升级与复核可以重叠,分别计费;拒绝、重试和失败仍进入成本分子。推理单价可能只占总成本的一小部分。这些不是任何厂商报价。
13. 给 PageOCR 一类产品的具体选型路线
建议把 Basic 定义为本地文字识别与可检索输出:原生 PDF 优先提取,扫描页用 PaddleOCR.js 与 Tesseract.js 在真实设备上做候选比较,逐页工作、可取消、可重试。免费用户不得自动落入付费云路径。本地仍有模型下载、静态资源与设备计算成本,只是没有供应商按页推理账单。
Pro 定义为结构化文档与编辑能力:优先比较 PP-StructureV3、Docling、MinerU、Marker 等对你自己的多栏/表格数据的表现;选择两个有互补性的候选即可,不必同时维护所有框架。Plus 再提供受控 VLM 重读、字段抽取和验证,云端或自托管按真实使用量核算。模型服务需要独立的算力与队列设计,不能因为网页托管在边缘平台就假设模型也适合在同一运行时执行。
银行流水转换可以成为垂直入口:逐交易保存原页证据,区分余额、借方和贷方,验证期初余额加净变动等于期末余额,导出日期和金额类型,给异常行复核界面。它的优势应是少改错、好核对、导出后能用。收敛到一个格式族验证收益,再扩展银行与语言;无需先训练一个基础 OCR 模型。
14. 最小实现、负例与选型验收
下面提供 Python 3.11+ 标准库实验,输入是人工构造的 OCR 结果,不运行图像识别、不访问网络、不代表任何模型的识别性能。它实现 NFC 字符错误率、字段证据绑定、归一化坐标检查、Decimal 金额校验和账户变更阻塞。clean 只进入 validated_candidate,仍没有付款权限。
另外实际运行了 Tesseract 5.5.0(英文语言包)读取下面的原创清晰印刷样张,得到四行金额与编号正确的文本。空行差异保留。这是单张合成图片的真实引擎冒烟测试,不证明扫描、手写、多语言或真实发票准确率。
ocr-invoice-smoke.png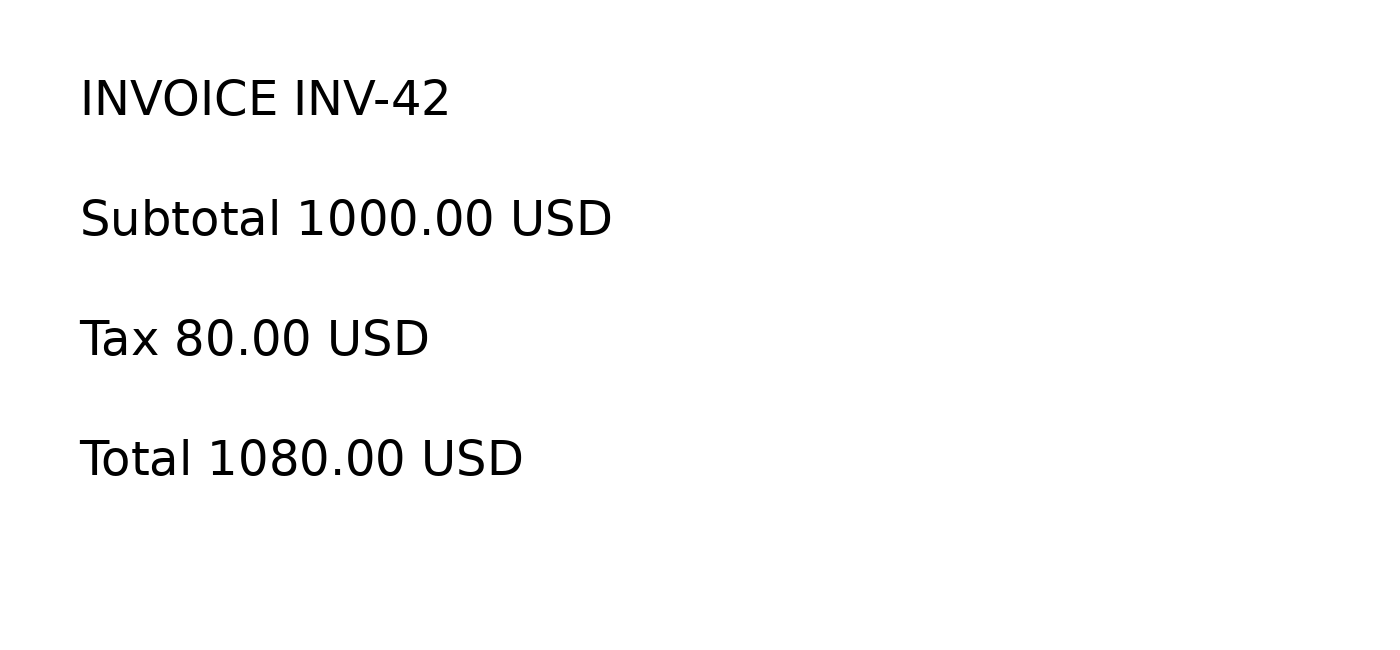
tesseract ocr-invoice-smoke.png stdout -l eng --psm 6INVOICE INV-42
Subtotal 1000.00 USD
Tax 80.00 USD
Total 1080.00 USD本地校验实验 · Python 3.11+
ocr-evidence-gate.pypython3 ocr-evidence-gate.py预期输出
checks=11 clean=validated_candidate ambiguous=review cer=0.142857
synthetic_cost=1600.00 cost_per_validated_document=0.20
Python · ocr-evidence-gate.py
"""Python 3.11+, standard library. Synthetic OCR output, no image inference/API.
The gate checks provenance and arithmetic, not document authenticity.
"""
from decimal import Decimal, InvalidOperation
from copy import deepcopy
import unicodedata

def distance(a, b):
    row = list(range(len(b) + 1))
    for i, x in enumerate(a, 1):
        nxt = [i]
        for j, y in enumerate(b, 1):
            nxt.append(min(nxt[-1] + 1, row[j] + 1, row[j-1] + (x != y)))
        row = nxt
    return row[-1]

def cer(reference, prediction):
    # NFC Unicode code points; whitespace and case remain significant.
    a, b = (unicodedata.normalize('NFC', x) for x in (reference, prediction))
    if not a:
        raise ValueError('CER requires a nonempty reference')
    return distance(a, b) / len(a)

def validate(record, evidence):
    reasons = []
    values = {}
    for name in ('subtotal', 'tax', 'total'):
        field = record.get(name, {})
        source = evidence.get(field.get('evidence_id'))
        if not source or field.get('raw') != source.get('text'):
            reasons.append(name + ':missing_or_changed_evidence')
            continue
        bbox = source.get('bbox', [])
        if (source.get('page', 0) < 1 or len(bbox) != 4
            or not all(isinstance(x, (int, float)) and 0 <= x <= 1 for x in bbox)
            or not (bbox[0] < bbox[2] and bbox[1] < bbox[3])):
            reasons.append(name + ':invalid_source_region')
        # Fixed fixture convention: dot decimal, USD, no grouping separators.
        try:
            value = Decimal(field['raw'])
            if not value.is_finite() or value < 0 or value.as_tuple().exponent < -2:
                raise InvalidOperation
            values[name] = value
        except (InvalidOperation, ValueError, TypeError):
            reasons.append(name + ':unresolved_numeric_text')
    if record.get('currency') != 'USD':
        reasons.append('currency:unsupported')
    if record.get('account_changed'):
        reasons.append('account_change:independent_verification_required')
    if len(values) == 3 and values['subtotal'] + values['tax'] != values['total']:
        reasons.append('amounts:inconsistent')
    return ('review' if reasons else 'validated_candidate'), reasons

E = {k: {'text': v, 'page': 1, 'bbox': [0.6, y, 0.9, y + .04]}
     for k, v, y in [('s', '1000.00', .6), ('t', '80.00', .7), ('g', '1080.00', .8)]}
R = {'currency': 'USD', 'account_changed': False,
     **{n: {'raw': E[k]['text'], 'evidence_id': k}
        for n, k in [('subtotal', 's'), ('tax', 't'), ('total', 'g')]}}

def main():
    assert validate(R, E)[0] == 'validated_candidate'
    wrong = deepcopy(R); wrong['total']['raw'] = '1090.00'
    assert validate(wrong, E)[0] == 'review'  # invented correction has no evidence
    ambiguous = deepcopy(R); ambiguous['total']['raw'] = '1O80.00'
    ambiguous_e = deepcopy(E); ambiguous_e['g']['text'] = '1O80.00'
    assert validate(ambiguous, ambiguous_e)[0] == 'review'  # never guess O -> 0
    bad_sum_e = deepcopy(E); bad_sum_e['g']['text'] = '1090.00'
    bad_sum = deepcopy(R); bad_sum['total']['raw'] = '1090.00'
    assert validate(bad_sum, bad_sum_e)[0] == 'review'  # evidence exists, sum fails
    missing = deepcopy(R); missing['total']['evidence_id'] = 'not-found'
    assert validate(missing, E)[0] == 'review'
    changed = deepcopy(R); changed['account_changed'] = True
    assert validate(changed, E)[0] == 'review'
    bad_box = deepcopy(E); bad_box['g']['bbox'] = [.9, .8, .6, .7]
    assert validate(R, bad_box)[0] == 'review'
    nonfinite = deepcopy(R); nonfinite['total']['raw'] = 'NaN'
    nonfinite_e = deepcopy(E); nonfinite_e['g']['text'] = 'NaN'
    assert validate(nonfinite, nonfinite_e)[0] == 'review'
    assert cer('1080.00', '1O80.00') == 1 / 7
    assert cer('café', 'cafe\u0301') == 0
    print('checks=11 clean=validated_candidate ambiguous=review cer=0.142857')
    print('synthetic_cost=1600.00 cost_per_validated_document=0.20')
    assert Decimal(10000) * Decimal('.01') + Decimal(10000) * Decimal('.15') * Decimal('.08') + Decimal(10000) * Decimal('.05') * Decimal('2') + Decimal('380') == Decimal('1600')
    # A real deployment also needs authentication, anti-tamper checks, taxes/rounding
    # rules, independent payment authority and immutable source versioning.
if __name__ == '__main__':
    main()
真实 OCR 接入可以先用 Docling 的 DocumentConverter 转换本地 PDF,再映射到统一证据格式;浏览器 SDK 则处理已渲染页面。下面两段是依据官方文档的接入起点,本轮未安装模型或调用付费 API;生产应固定依赖与模型版本,先用不含隐私的测试文档验证。[S8][S11]
依据官方文档改写的接入例子 · 本轮未执行
from docling.document_converter import DocumentConverter

# Install docling in an isolated environment; pin the tested version.
converted = DocumentConverter().convert("sample.pdf")
markdown = converted.document.export_to_markdown()
# Adapt structured document items and provenance separately for field review.
import { PaddleOCR } from "@paddleocr/paddleocr-js";
// Pass a rendered page image (Blob), not raw PDF bytes.
const engine = await PaddleOCR.create({
lang: "ch", ocrVersion: "PP-OCRv5",
ortOptions: { backend: "wasm" }
});
try {
const [page] = await engine.predict(pageImageBlob);
console.log(page.items);
} finally {
engine.dispose();
}验收集按供应商/模板、语言、拍照设备与时间切分,避免同一模板泄漏到训练和测试。比较原生提取、普通 OCR、结构化解析、VLM 和混合路由,固定原件、质量标准与预算;记录冷启动、下载体积、峰值内存、p95 延迟、错误放行率和成本。先用覆盖关键故障的数百页试验,再依据风险与样本量扩大评估;没有通用的“200 页就足够”结论。
负例必须包括空白页、低对比小数点、旋转、双栏、跨页表格、混合语言、手写覆盖、错误文字层、重复上传、单页失败、伪造来源、账号变更与恶意文档指令。练习:解释为什么 99% 字符准确率不能证明金额可靠;设计只重跑失败页的状态机;比较“全量 VLM”与“困难区域升级”的相同预算;用保留数据选择复核阈值并报告自动通过率与错误率。先证明在你的文件上可靠,再决定哪个框架特别好。
预测、检验与证据记录
展开答案前先预测一个结果;练习后记录差异和迁移测试。记录仅存本地,在不同语言版本间共用。
打开记录/导出/清除 →数学复核范围逐篇记录,不代表完成论文实证复现;可在笔记中记录疑似错误。 复核范围
原始资料与延伸阅读
资料核对:2026 年 11 月 16 日。产品功能依据厂商公开文档,框架建议属于编辑判断,未做统一厂商性能测试。可执行实验使用合成 OCR 输出。
- S1 · Tesseract documentation — neural OCRhttps://tesseract-ocr.github.io/tessdoc/ · 2026-11-16
- S2 · Graves et al., CTC — ICML 2006https://www.cs.toronto.edu/~graves/icml_2006.pdf · 2026-11-16
- S3 · Differentiable Binarization — AAAI 2020 / arXiv v2https://arxiv.org/abs/1911.08947v2 · 2026-11-16
- S4 · LayoutLMv3 — official implementation, 2022https://github.com/microsoft/unilm/tree/master/layoutlmv3 · 2026-11-16
- S5 · Donut — OCR-free document understanding, ECCV 2022https://github.com/clovaai/donut · 2026-11-16
- S6 · PaddleOCR 3.0 Technical Report — 2025https://arxiv.org/abs/2507.05595 · 2026-11-16
- S7 · PaddleOCR — official repositoryhttps://github.com/PaddlePaddle/PaddleOCR · 2026-11-16
- S8 · PaddleOCR.js — official browser deploymenthttps://github.com/PaddlePaddle/PaddleOCR/blob/main/docs/version3.x/inference_deployment/cross_platform/browser.en.md · 2026-11-16
- S9 · Tesseract.js — README and PDF limitationhttps://github.com/naptha/tesseract.js · 2026-11-16
- S10 · RapidOCR — runtime toolkithttps://github.com/RapidAI/RapidOCR · 2026-11-16
- S11 · Docling — conversion and separate model licenseshttps://github.com/docling-project/docling · 2026-11-16
- S12 · MinerU — official document parserhttps://github.com/opendatalab/MinerU · 2026-11-16
- S13 · Marker — modes, hybrid processing and licensinghttps://github.com/datalab-to/marker · 2026-11-16
- S14 · Surya — OCR and layouthttps://github.com/datalab-to/surya · 2026-11-16
- S15 · olmOCR — PDF linearization toolkithttps://github.com/allenai/olmocr · 2026-11-16
- S16 · DeepSeek-OCR — optical compression research, 2025https://arxiv.org/abs/2510.18234 · 2026-11-16
- S17 · DeepSeek-OCR 2 — Visual Causal Flow, 2026https://arxiv.org/abs/2601.20552 · 2026-11-16
- S18 · Reducto — product architecture overviewhttps://reducto.ai/ · 2026-11-16
- S19 · Extend — parsing and extraction platformhttps://docs.extend.ai/ · 2026-11-16
- S20 · Extend — extraction depends on parse evidencehttps://docs.extend.ai/extraction/overview · 2026-11-16
- S21 · LandingAI — ADE second generationhttps://landing.ai/blog/introducing-agentic-document-extraction-gen2 · 2026-11-16
- S22 · LlamaIndex — LlamaParse platformhttps://developers.llamaindex.ai/llamaparse/ · 2026-11-16
- S23 · Nanonets — document processing APIhttps://docs.nanonets.com/v4/reference/overview · 2026-11-16
- S24 · Mindee — extraction capabilitieshttps://docs.mindee.com/getting-started/key-features · 2026-11-16
- S25 · Instabase — validation rules and reviewhttps://docs.instabase.com/automate/validating-documents · 2026-11-16
- S26 · Unstructured — open-source document ETLhttps://github.com/Unstructured-IO/unstructured · 2026-11-16
- S27 · Mistral — OCR processorhttps://docs.mistral.ai/studio/document-processing/basic_ocr · 2026-11-16
- S28 · Amazon Textract — table structurehttps://docs.aws.amazon.com/textract/latest/dg/how-it-works-tables.html · 2026-11-16
- S29 · Google Document AI — OCRhttps://docs.cloud.google.com/document-ai/docs/enterprise-document-ocr · 2026-11-16
- S30 · OmniDocBench — benchmark and evaluation codehttps://github.com/opendatalab/OmniDocBench · 2026-11-16
- S31 · Rossum — automation criteriahttps://knowledge-base.rossum.ai/docs/guide-to-automation-process-in-rossum · 2026-11-16
- S32 · Datalab — document intelligence APIhttps://www.datalab.to/ · 2026-11-16
- S33 · Mozilla PDF.js — parsing and renderinghttps://mozilla.github.io/pdf.js/ · 2026-11-16
- S34 · Marker — model weight licensehttps://github.com/datalab-to/marker/blob/master/MODEL_LICENSE · 2026-11-16
- S35 · Google Document AI — layout parserhttps://docs.cloud.google.com/document-ai/docs/layout-parse-chunk · 2026-11-16