OCR와 AI 문서 이해: 원리·프레임워크·기업 지형
픽셀에서 검증 가능한 업무 기록까지: 신경망 OCR, 레이아웃·표, VLM, 근거와 비용, 공개 프레임워크와 문서 AI 기업을 체계적으로 살펴본다.
출처 및 버전 정보
이 글의 목차
1. 청구서에서 시작하는 시스템의 목표
세 페이지 PDF에 디지털 청구서, 촬영한 날인 보충 문서, 다음 장으로 이어지는 명세표가 있다고 가정하자. 사용자는 편집 가능한 Word, 대조 가능한 Excel, 회계 시스템에 넣을 필드를 원한다. 문자를 읽는 것만으로 이 작업은 끝나지 않는다. 이 글은 개발자와 제품 담당자가 입력부터 근거 있는 기록까지 이해하고 구성 요소를 선택하며 로컬 검증 예제를 실행하도록 돕는다.
OCR은 광학 문자 인식이다. 문서 파싱은 문단·제목·표·읽기 순서를 복원하고, 정보 추출은 근거를 스키마 필드에 연결한다. IDP는 분류·검증·사람의 검토·업무 연계까지 포함한다. PDF는 컨테이너이므로 확장자만으로 OCR 필요 여부를 알 수 없다. 한 페이지에 텍스트와 스캔 영역이 섞일 수도 있다.
| 계층 | 입력 → 출력 | 대표 오류 |
|---|---|---|
| 인식 | 픽셀 → 문자·위치·점수 | 0/O 혼동, 줄 누락 |
| 파싱 | 영역과 문자 → 블록·셀·관계 | 두 단의 내용 혼합 |
| 추출 | 근거와 스키마 → 타입 있는 필드 | 만기일을 발행일로 오인 |
| 업무 | 검증 기록 → 통제된 동작 | 중복 등록, 잘못된 지급 |
공식 자료 확인일은 2026년 11월 16일이다. 추천은 공학적 판단이며 전체 제품의 동일 조건 벤치마크가 아니다. 인쇄 문서, 일반적인 필기와 구조화 추출을 다루며 모든 고문자나 진위 판별을 포괄하지 않는다.
2. 시각 모델보다 파일을 먼저 검사한다
디지털 PDF에는 텍스트 객체, 폰트 매핑과 좌표가 들어 있을 수 있다. 그러나 그리기 순서는 읽기 순서와 다르고 매핑이 손상되면 문자가 깨진다. 스캔에는 주로 이미지가 있지만 예전 OCR의 보이지 않는 텍스트층이 남기도 한다. 텍스트층의 존재는 정확성의 증거가 아니다. 화면과 추출 내용의 일치, 누락, 좌표를 확인한다.
입력 바이트·페이지·디코딩 픽셀을 제한하고 암호화·손상을 처리한 뒤 페이지별로 경로를 선택한다. 유효한 텍스트는 직접 추출하고 스캔은 렌더링 후 인식한다. PDF.js는 브라우저 PDF 표시와 텍스트 객체 접근을 제공하며 OCR 모델은 아니다.[S33] 업로드는 신뢰할 수 없으므로 디코더를 격리한다.
A4 300 DPI는 약 2480×3508픽셀이며 RGBA만 약 33.2 MiB다. 열 장을 동시에 유지하면 모델과 복사본을 빼도 330 MiB가 넘는다. 업로드 한도와 동시 디코딩 한도는 다르다. 페이지 큐, 버퍼 해제, 복구 가능한 진행 상태가 필요하다. 해상도를 높이면 작은 글자를 보존하지만 이미 사라진 촬영 정보를 확실히 복원하지는 못한다.
3. OCR 파이프라인은 어떻게 문자를 읽는가
대표 과정은 방향·원근 보정, 텍스트 검출, 행 자르기, 시퀀스 인식, 후처리다. 이진화는 소수점을, 노이즈 제거는 가는 획을 지울 수 있다. 원본을 보존하고 변환별 효과를 측정한다.
검출은 위치를 찾고 인식은 내용을 읽는다. DB는 분할 기반 검출에서 임계값 학습을 훈련에 통합하는 방법이다.[S3] 대표적인 CTC 인식기는 H×W×3 행 이미지를 T×d 특징으로 바꾸고 T×(|V|+1)의 문자·blank 점수를 출력한다. 모든 모델이 이 구조를 쓰는 것은 아니다.
CTC는 정답 문자열로 축약되는 경로의 확률을 더한다. 연속 반복을 합친 뒤 blank를 지우므로 h,h,blank,i는 hi, l,blank,l은 ll이다. 문자별 위치 정렬은 없어도 이미지와 올바른 전사의 쌍은 필요하다. 단계별 최대값을 고르는 탐욕 복호화는 최적 문자열을 보장하지 않는다.[S2]
x는 행 이미지, y는 정답 시퀀스, π는 blank 포함 경로, B는 축약, T는 시각 단계 수, p_t는 해당 단계 라벨 확률이다. 손실은 정답 확률의 음의 로그다. 자체 두 단계 예: A/blank 확률이 (0.6,0.4), (0.5,0.5)이면 AA·A blank·blank A는 A가 되어 0.3+0.3+0.2=0.8이다. 두 blank의 확률은 0.2다.
현대 Tesseract에도 LSTM 신경망 인식기가 있다.[S1] 변화의 핵심은 AI 유무보다 표현, 구조 모델링, 생성과 검증이다.
4. 레이아웃·읽기 순서·표는 별도 과제다
문자가 모두 맞아도 두 단을 섞거나 80.00을 다른 행에 연결하면 사용할 수 없다. 좌표는 위치를 나타내고 관계는 의미를 정한다. 레이아웃 분석은 영역을 분류하고, 읽기 순서는 블록을 연결하며, 표 인식은 행·열·병합 셀·헤더 관계를 복원한다.
선이 있는 표는 교차점을 활용하고, 선 없는 표는 정렬과 시각 구조에 더 의존한다. 페이지 간 표 연결은 열의 의미, 단위, 반복 헤더와 연속 표시를 확인해야 한다. 열 개수가 같다는 이유만으로 합치면 안 된다. 단순 표는 Markdown, 복잡한 병합은 HTML이나 셀 그래프가 적합하다. XLSX에는 숫자와 날짜 타입을 보존한다.
중간 표현에 페이지·블록 ID, 종류, 원문, 좌표계, 순서, 셀, 원본 버전을 저장한다. 여기서 Word·Excel·검색 자료를 만든다. 편집 가능성과 픽셀 수준 재현은 다른 목표다. 고정 상자는 시각적으로 비슷해도 문서 편집과 재배치를 어렵게 할 수 있다.
5. AI 보조 OCR의 네 가지 형태
첫째는 인식문·대체 후보·부분 이미지로 수정안을 제시하는 후처리다. 언어 지식은 산문에 도움이 되지만 낯선 이름이나 번호가 정답일 수 있다. 유창함은 충실함이 아니다. 원문, 정규화 값과 수정안을 분리한다.
둘째는 문자·좌표·이미지를 결합하는 모델이다. LayoutLMv3는 분류와 필드 이해의 예이며 OCR 입력을 무조건 없애지는 않는다.[S4] 셋째는 Donut처럼 이미지에서 구조화 시퀀스를 생성하는 방식이다. 독립 OCR 모듈을 없애도 누락·환각·분포 변화 위험은 남는다.[S5]
넷째는 혼합 처리다. 일반 페이지는 저렴한 경로로, 어려운 영역은 전문 모델이나 VLM으로 다시 읽고 추출·검증한다. 추가 단계에는 비용과 지연이 있다. 모델들이 같은 편향을 공유할 수 있으므로 합의만으로 증명하지 못한다. Agentic 처리에는 재독해 횟수와 종료 규칙이 있어야 한다.
6. VLM의 문서 이해와 생성 오류
시각 언어 모델은 전체 페이지나 잘라낸 영역을 시각 토큰으로 인코딩하고 지시에 따라 텍스트·Markdown·JSON을 생성한다. 타일링과 동적 해상도는 작은 글자와 토큰 예산을 절충한다. 범용 모델은 다양한 시각 과제, 문서 모델은 문자·수식·표·구조에 집중한다. PaddleOCR는 문자 인식, 구조 파싱, 문서 VLM 경로를 구분한다.[S6][S7]
DeepSeek-OCR와 OCR 2는 시각 표현 및 텍스트 복원·압축을 연구한다.[S16][S17] 시각 토큰 감소만으로 전체 비용 절감을 주장할 수 없다. 렌더링, 인코딩, 출력 생성, 재시도와 검토를 포함해야 한다. 과도한 압축은 긴 식별자와 드문 기호를 손상시킬 수 있다.
전사 작업에는 읽지 못한 부분을 null이나 uncertain으로 남기고 임의 완성을 금지한다. 해석은 별도로 저장한다. JSON Schema는 형태를 제한하며 사실성을 보장하지 않는다.
7. 필드에는 근거·타입·규칙이 필요하다
금액에는 원문, 타입 있는 값, 통화, 페이지, 영역, 블록, 처리 버전과 검토 상태가 필요하다. 좌표 단위·원점·회전, 원본으로 되돌리는 변환을 명시한다.
| 필드 | 예 | 목적 |
|---|---|---|
| raw / value | 1O80.00 / null | O와 0의 모호성 유지 |
| evidence_id / page | g / 1 | 출처로 이동 |
| bbox / coordinate_system | [0.6,0.8,0.9,0.84] / normalized_xyxy | 검토 강조 표시 |
| model_version / schema_version | 고정 식별자 | 재현과 롤백 |
| status / reasons | review / ambiguous_digit | 차단 이유 |
1,234와 1.234의 의미는 지역에 따라 다르다. 구두점을 지워 추측하지 말고 Decimal 및 세금·할인·반올림 규칙을 사용한다. 합계 일치는 진위 증명이 아니다. 가짜 문서도 합계는 맞을 수 있다. 계좌 변경은 독립 확인과 권한 검사가 필요하다.
상위 파싱이 값을 누락했다면 추출 스키마 변경만으로 복구할 수 없다. 원본과 파싱 결과를 먼저 보고 재인식 또는 스키마 수정을 선택한다.[S20]
8. 실제 제품을 위한 참조 아키텍처
브라우저는 선택·미리보기·품질 안내·로컬 인식·명시적 클라우드 전환을 담당한다. 서버는 인증·테넌트 격리·유료 자격·페이지 작업·큐·라우팅·근거·검증·내보내기를 담당한다. 무료 경로의 유료 추론 금지는 서버에서 강제해야 한다.
페이지별 queued, processing, needs_review, completed, failed와 예상 페이지 집합을 저장한다. 재시도 키는 테넌트·내용·페이지·설정에 연결한다. 재인식은 새 버전을 만들고, 시간 초과 때는 비동기 제공자 상태를 조회한 뒤 재전송한다. 취소는 대기 작업을 중단하고 이미 발생한 비용을 보고한다.
어느 페이지나 영역이 장치를 떠나는지 설명한다. 캐시·로그·공급자 보관·삭제 시점을 정의한다. 근거를 모두 지우면서 영구 추적을 약속할 수 없다. 문서 속 지시는 데이터이며 네트워크·이메일·지급 권한을 부여하지 않는다.
9. 우선 평가할 프레임워크
모든 언어·하드웨어·레이아웃에 통하는 단일 최고는 없다. 아래는 시험 후보이며 성능 순위가 아니다. 프레임워크·가중치·런타임·API는 서로 다른 구성 요소다.
| 후보 | 평가 대상 | 판단할 점 |
|---|---|---|
| PaddleOCR: PP-OCR / PP-StructureV3 / VL | 다국어 문자·구조·어려운 영역 | 경로별 품질과 비용 [S6][S7] |
| PaddleOCR.js | 브라우저 문자 검출·인식 | 전체 서버 파싱과 다름 [S8] |
| Tesseract / Tesseract.js | 선명한 인쇄·WASM 기준선 | JS는 PDF 선행 렌더링 필요 [S1][S9] |
| RapidOCR | CPU/ONNX 등 OCR 배포 | 추론 도구이며 업무 흐름 아님 [S10] |
| Docling | 다양한 형식의 통합 표현 | 코드 MIT, 모델 별도 확인 [S11] |
| MinerU | 논문·수식·복잡 PDF | 버전·백엔드·가중치 조건 [S12] |
| Marker + Surya | Markdown/JSON·혼합 처리 | 코드 Apache-2.0, 가중치 조건 별도 [S13][S14] |
| olmOCR | PDF 텍스트화·코퍼스 | 회계 필드와 평가 목표 다름 [S15] |
| Unstructured | 문서 분할·RAG 수집 | 필드·업무 검증 추가 [S26] |
| Donut / LayoutLMv3 / DeepSeek-OCR | 연구·특정 작업 미세조정 | 전체 제품 대체 아님 [S4][S5][S16] |
PaddleOCR.js 공식 문서가 있어도 모델 자산·Worker·장치 호환성은 검증해야 한다.[S8] Python 실행은 iPhone 브라우저 성능의 증거가 아니다. Marker는 코드와 상업 조건이 있는 가중치를 구분한다. 오래된 fork의 조건은 달라졌을 수 있다.[S34] commit·모델 카드·의존성을 고정한다.
10. 문서 AI 회사들은 무엇을 제공하는가
초기 기업부터 성장 기업까지 포함하며 독립 지분 상태·매출·점유율 순위가 아니다. 공식 기능과 이 글의 구매 검증 질문을 구분한다.
| 회사 / 제품 | 공개 제품 초점 | 검증 질문 |
|---|---|---|
| Reducto | 여러 단계의 OCR·VLM [S18] | 어려운 페이지 개선 대비 비용·지연 |
| Extend | 파싱·추출·분류·분리·흐름 [S19] | 상위 누락 진단과 재처리 |
| Datalab | API와 Marker/Surya 생태계 [S32][S13] | API와 자체 운영의 절충 |
| LandingAI ADE | 세밀한 출처 위치 연결 [S21] | 금액·셀의 인용 정확성 |
| LlamaIndex / LlamaParse | Parse·Extract·Classify·Split·Index [S22] | RAG·버전 체계 통합 |
| Nanonets | 추출·승인·검토 API [S23] | 실제 수작업·시간 절감 |
| Mindee | 구성 필드·좌표·신뢰도 [S24] | 타입·검토 통제 적합성 |
| Instabase | 기업 문서 앱·검증 [S25] | 조직 흐름과 배포 요구 |
| Unstructured | 문서 ETL·AI 데이터 준비 [S26] | 갱신·삭제·재색인 |
| Rossum | 거래 문서 규칙·자동화 [S31] | 위험에 맞는 자동 통과 기준 |
Mistral Document AI는 전문 서비스 후보이며 Textract는 표 관계, Google Document AI는 OCR·레이아웃 경로를 제공한다.[S27][S28][S29][S35] 모두 OCR 스타트업은 아니다. 공개 사례와 업체 순위는 자체 인수 기준을 대신하지 못한다.
11. 적용 분야와 상업적 가치
기본 인식이 쉬워지면 가치는 어려운 문서, 근거, 검토 효율과 업무 통합으로 이동한다. 이 글의 분석으로는 API가 도입·안정성, 플랫폼이 예외 처리·조직 배포, 수직 제품이 도메인 스키마·유통·성과를 경쟁한다. 제품 소개만으로 유지율이나 방어력을 입증할 수 없다.
청구서는 공급자·세금·중복, 은행 명세서는 차변·대변·잔액 연속성, 보험은 문서 묶음 분리·누락, 지식 기반은 계층·순서·삭제, 접근성은 읽기 품질을 중시한다. 검색에 충분한 Markdown도 회계 등록에는 부족할 수 있다.
체크박스·취소선·수정 이력·각주는 의미를 바꾼다. 서명 검출은 인증이 아니다. 고영향 업무에는 전문 검토가 필요하다. 모든 것을 이해한다는 약속보다 대조 가능한 거래와 검토 가능한 필드를 제공해야 한다.
12. 올바른 분모로 품질과 비용을 잰다
CER은 대체·삭제·삽입 수를 정답 문자 수로 나누며 100%를 넘을 수 있다. Unicode·공백·구두점·대소문자 규칙을 고정한다. 1080.00→1O80.00은 한 글자 오류지만 금액은 쓸 수 없다. 낮은 CER은 필드 신뢰성을 보장하지 않는다.
S/D/I는 대체·삭제·삽입, N_ref는 정답 문자 수다. N은 입력 건수, r은 클라우드 비율, h는 검토 비율, c_b/c_a/c_h는 단가, F는 고정비, N_valid는 검증 통과 수다.
표 구조·셀 내용·순서·필드 누락·출처·타입을 측정하고 자동 통과율과 그 안의 오류율을 함께 보고한다. OCR 점수를 필드 정답 확률로 간주하지 말고 언어·품질·유형별 보류 데이터로 보정한다. OmniDocBench는 파싱 평가 도구지만 도메인 검증을 대체하지 않는다.[S30]
합성 월간 예: 10000건, 기본 $0.01, 15% 클라우드 $0.08, 5% 검토 $2, 고정 $380. 합계 $100+$120+$1000+$380=$1600이며 검증 통과 8000건이면 건당 $0.20이다. 클라우드와 검토가 겹치면 둘 다 비용이고 실패도 분자에 남는다. 추론 단가만으로 총비용을 판단하면 안 된다. 업체 가격이 아니다.
13. PageOCR 유형 제품의 선택 경로
Basic은 유효 텍스트층을 직접 읽고 스캔에서는 PaddleOCR.js와 Tesseract.js를 실기기로 비교한다. 페이지 큐·취소·부분 재처리를 지원하고 무료 사용자의 묵시적 유료 추론을 차단한다. 모델 다운로드·호스팅·장치 계산 비용은 남는다.
Pro는 PP-StructureV3·Docling·MinerU·Marker를 자체 표·레이아웃 데이터로 비교하고 소수의 보완 후보만 유지한다. Plus는 제어된 VLM 재독해·추출·검증을 추가한다. 웹 UI의 엣지 호스팅은 모델이 같은 실행 환경에 적합하다는 증거가 아니다.
은행 명세서 전환은 거래별 근거, 차변/대변·잔액 구분, 기초잔액+순변동=기말잔액, 타입 있는 출력을 제공한다. 가치는 적은 수정, 쉬운 대조, 쓸 수 있는 내보내기다. 하나의 형식군에서 입증한 뒤 확장하며 처음부터 기반 OCR 모델을 훈련할 필요는 없다.
14. 최소 구현과 선택 검증
Python 3.11+ 표준 라이브러리 예제는 합성 OCR 출력으로 동작하고 이미지 추론·API는 실행하지 않는다. NFC CER·근거 연결·좌표·Decimal·계좌 변경 차단을 구현한다. 정상 기록은 validated_candidate이며 지급 권한이 아니다.
Tesseract 5.5.0과 영어 데이터로 다음 자체 합성 인쇄 이미지를 실제 인식했다. 네 줄의 번호·금액이 정확했고 빈 줄을 보존했다. 한 장의 선명한 합성 이미지 smoke test이며 실제 스캔·필기·다국어 청구서 정확성을 증명하지 않는다.
ocr-invoice-smoke.png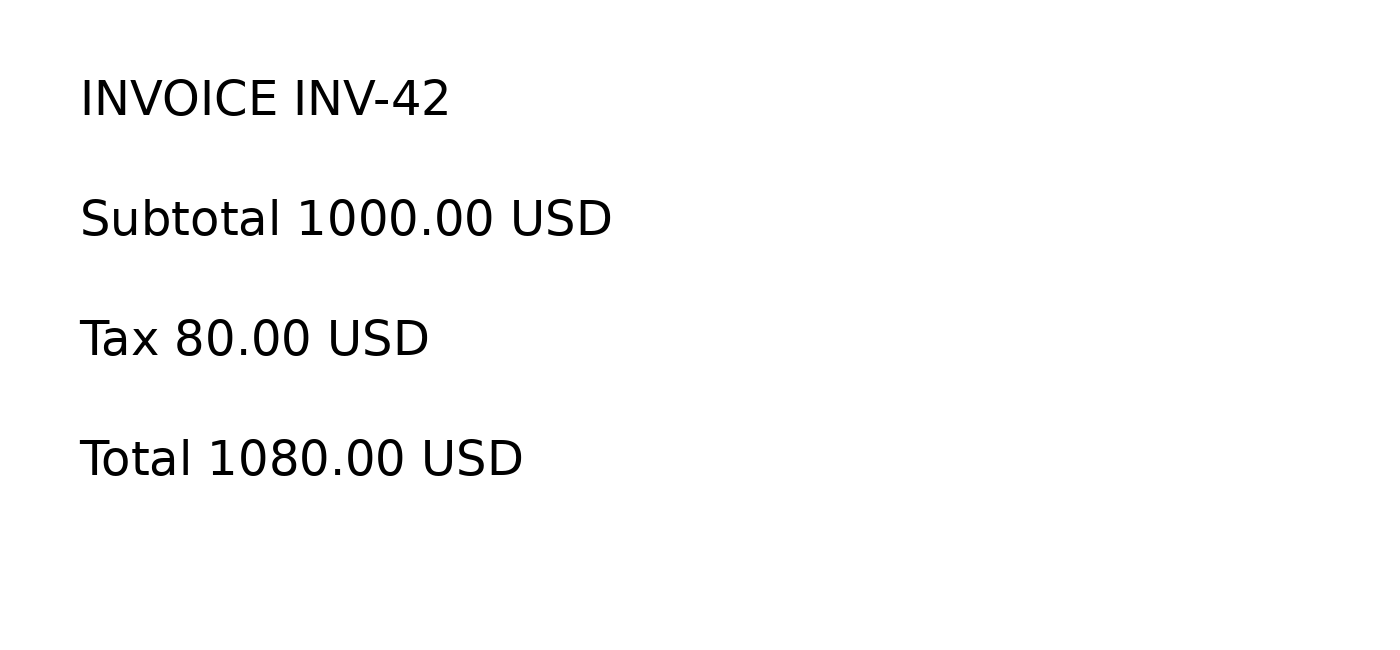
tesseract ocr-invoice-smoke.png stdout -l eng --psm 6INVOICE INV-42
Subtotal 1000.00 USD
Tax 80.00 USD
Total 1080.00 USD로컬 검증 · Python 3.11+
ocr-evidence-gate.pypython3 ocr-evidence-gate.py예상 출력
checks=11 clean=validated_candidate ambiguous=review cer=0.142857
synthetic_cost=1600.00 cost_per_validated_document=0.20
Python · ocr-evidence-gate.py
"""Python 3.11+, standard library. Synthetic OCR output, no image inference/API.
The gate checks provenance and arithmetic, not document authenticity.
"""
from decimal import Decimal, InvalidOperation
from copy import deepcopy
import unicodedata

def distance(a, b):
    row = list(range(len(b) + 1))
    for i, x in enumerate(a, 1):
        nxt = [i]
        for j, y in enumerate(b, 1):
            nxt.append(min(nxt[-1] + 1, row[j] + 1, row[j-1] + (x != y)))
        row = nxt
    return row[-1]

def cer(reference, prediction):
    # NFC Unicode code points; whitespace and case remain significant.
    a, b = (unicodedata.normalize('NFC', x) for x in (reference, prediction))
    if not a:
        raise ValueError('CER requires a nonempty reference')
    return distance(a, b) / len(a)

def validate(record, evidence):
    reasons = []
    values = {}
    for name in ('subtotal', 'tax', 'total'):
        field = record.get(name, {})
        source = evidence.get(field.get('evidence_id'))
        if not source or field.get('raw') != source.get('text'):
            reasons.append(name + ':missing_or_changed_evidence')
            continue
        bbox = source.get('bbox', [])
        if (source.get('page', 0) < 1 or len(bbox) != 4
            or not all(isinstance(x, (int, float)) and 0 <= x <= 1 for x in bbox)
            or not (bbox[0] < bbox[2] and bbox[1] < bbox[3])):
            reasons.append(name + ':invalid_source_region')
        # Fixed fixture convention: dot decimal, USD, no grouping separators.
        try:
            value = Decimal(field['raw'])
            if not value.is_finite() or value < 0 or value.as_tuple().exponent < -2:
                raise InvalidOperation
            values[name] = value
        except (InvalidOperation, ValueError, TypeError):
            reasons.append(name + ':unresolved_numeric_text')
    if record.get('currency') != 'USD':
        reasons.append('currency:unsupported')
    if record.get('account_changed'):
        reasons.append('account_change:independent_verification_required')
    if len(values) == 3 and values['subtotal'] + values['tax'] != values['total']:
        reasons.append('amounts:inconsistent')
    return ('review' if reasons else 'validated_candidate'), reasons

E = {k: {'text': v, 'page': 1, 'bbox': [0.6, y, 0.9, y + .04]}
     for k, v, y in [('s', '1000.00', .6), ('t', '80.00', .7), ('g', '1080.00', .8)]}
R = {'currency': 'USD', 'account_changed': False,
     **{n: {'raw': E[k]['text'], 'evidence_id': k}
        for n, k in [('subtotal', 's'), ('tax', 't'), ('total', 'g')]}}

def main():
    assert validate(R, E)[0] == 'validated_candidate'
    wrong = deepcopy(R); wrong['total']['raw'] = '1090.00'
    assert validate(wrong, E)[0] == 'review'  # invented correction has no evidence
    ambiguous = deepcopy(R); ambiguous['total']['raw'] = '1O80.00'
    ambiguous_e = deepcopy(E); ambiguous_e['g']['text'] = '1O80.00'
    assert validate(ambiguous, ambiguous_e)[0] == 'review'  # never guess O -> 0
    bad_sum_e = deepcopy(E); bad_sum_e['g']['text'] = '1090.00'
    bad_sum = deepcopy(R); bad_sum['total']['raw'] = '1090.00'
    assert validate(bad_sum, bad_sum_e)[0] == 'review'  # evidence exists, sum fails
    missing = deepcopy(R); missing['total']['evidence_id'] = 'not-found'
    assert validate(missing, E)[0] == 'review'
    changed = deepcopy(R); changed['account_changed'] = True
    assert validate(changed, E)[0] == 'review'
    bad_box = deepcopy(E); bad_box['g']['bbox'] = [.9, .8, .6, .7]
    assert validate(R, bad_box)[0] == 'review'
    nonfinite = deepcopy(R); nonfinite['total']['raw'] = 'NaN'
    nonfinite_e = deepcopy(E); nonfinite_e['g']['text'] = 'NaN'
    assert validate(nonfinite, nonfinite_e)[0] == 'review'
    assert cer('1080.00', '1O80.00') == 1 / 7
    assert cer('café', 'cafe\u0301') == 0
    print('checks=11 clean=validated_candidate ambiguous=review cer=0.142857')
    print('synthetic_cost=1600.00 cost_per_validated_document=0.20')
    assert Decimal(10000) * Decimal('.01') + Decimal(10000) * Decimal('.15') * Decimal('.08') + Decimal(10000) * Decimal('.05') * Decimal('2') + Decimal('380') == Decimal('1600')
    # A real deployment also needs authentication, anti-tamper checks, taxes/rounding
    # rules, independent payment authority and immutable source versioning.
if __name__ == '__main__':
    main()
실제 파싱은 Docling DocumentConverter에서 시작해 근거 스키마로 변환할 수 있고, 브라우저 SDK는 렌더링 이미지를 처리한다. 다음 예제는 공식 문서 기반 시작점이며 이번 검토에서 가중치 다운로드나 유료 API를 실행하지 않았다. 운영 전 버전을 고정한다.[S8][S11]
공식 문서 기반 연결 예 · 이번 검토에서 미실행
from docling.document_converter import DocumentConverter

# Install docling in an isolated environment; pin the tested version.
converted = DocumentConverter().convert("sample.pdf")
markdown = converted.document.export_to_markdown()
# Adapt structured document items and provenance separately for field review.
import { PaddleOCR } from "@paddleocr/paddleocr-js";
// Pass a rendered page image (Blob), not raw PDF bytes.
const engine = await PaddleOCR.create({
lang: "ch", ocrVersion: "PP-OCRv5",
ortOptions: { backend: "wasm" }
});
try {
const [page] = await engine.predict(pageImageBlob);
console.log(page.items);
} finally {
engine.dispose();
}공급자/템플릿·언어·장치·시간별 평가 분할로 누출을 줄인다. 동일 원본·예산·기준에서 직접 추출·OCR·파싱·VLM·혼합을 비교하고 다운로드·콜드 스타트·최대 메모리·p95·잘못된 통과·비용을 기록한다. 수백 페이지로 핵심 오류를 찾은 뒤 위험에 맞춰 확장하며 보편적 필요 페이지 수를 주장하지 않는다.
빈 페이지·희미한 소수점·회전·다단·이어진 표·혼합 언어·필기 덮임·잘못된 텍스트층·중복·부분 실패·가짜 근거·계좌 변경·악성 지시를 포함한다. 연습: 99% 문자 정확도로 금액을 보장할 수 없는 이유, 페이지별 재시도 상태, 동일 예산의 전체 VLM 대 선택 전환, 보류 데이터 기반 임계값과 통과/오류율을 설명한다. 자신의 문서에서 신뢰성을 증명한 뒤 좋은 프레임워크를 고른다.
예측, 검증, 근거 기록
답을 보기 전에 결과를 예측하세요. 연습 후 차이와 전이 테스트를 기록합니다. 로컬에 저장되며 언어판 간 공유됩니다.
학습 기록 열기 / 내보내기 / 지우기 →수학 검토 범위는 강의별로 기록합니다. 논문의 실증 재현 인증은 아닙니다. 의심되는 오류를 노트에 남겨 주세요. 검토 범위
일차 자료와 추가 학습
자료 확인: 2026년 11월 16일. 기능은 공식 문서 기준이며 추천은 편집 판단이다. 통일된 업체 벤치마크는 수행하지 않았고 실험 입력은 합성 OCR 결과다.
- S1 · Tesseract documentation — neural OCRhttps://tesseract-ocr.github.io/tessdoc/ · 2026-11-16
- S2 · Graves et al., CTC — ICML 2006https://www.cs.toronto.edu/~graves/icml_2006.pdf · 2026-11-16
- S3 · Differentiable Binarization — AAAI 2020 / arXiv v2https://arxiv.org/abs/1911.08947v2 · 2026-11-16
- S4 · LayoutLMv3 — official implementation, 2022https://github.com/microsoft/unilm/tree/master/layoutlmv3 · 2026-11-16
- S5 · Donut — OCR-free document understanding, ECCV 2022https://github.com/clovaai/donut · 2026-11-16
- S6 · PaddleOCR 3.0 Technical Report — 2025https://arxiv.org/abs/2507.05595 · 2026-11-16
- S7 · PaddleOCR — official repositoryhttps://github.com/PaddlePaddle/PaddleOCR · 2026-11-16
- S8 · PaddleOCR.js — official browser deploymenthttps://github.com/PaddlePaddle/PaddleOCR/blob/main/docs/version3.x/inference_deployment/cross_platform/browser.en.md · 2026-11-16
- S9 · Tesseract.js — README and PDF limitationhttps://github.com/naptha/tesseract.js · 2026-11-16
- S10 · RapidOCR — runtime toolkithttps://github.com/RapidAI/RapidOCR · 2026-11-16
- S11 · Docling — conversion and separate model licenseshttps://github.com/docling-project/docling · 2026-11-16
- S12 · MinerU — official document parserhttps://github.com/opendatalab/MinerU · 2026-11-16
- S13 · Marker — modes, hybrid processing and licensinghttps://github.com/datalab-to/marker · 2026-11-16
- S14 · Surya — OCR and layouthttps://github.com/datalab-to/surya · 2026-11-16
- S15 · olmOCR — PDF linearization toolkithttps://github.com/allenai/olmocr · 2026-11-16
- S16 · DeepSeek-OCR — optical compression research, 2025https://arxiv.org/abs/2510.18234 · 2026-11-16
- S17 · DeepSeek-OCR 2 — Visual Causal Flow, 2026https://arxiv.org/abs/2601.20552 · 2026-11-16
- S18 · Reducto — product architecture overviewhttps://reducto.ai/ · 2026-11-16
- S19 · Extend — parsing and extraction platformhttps://docs.extend.ai/ · 2026-11-16
- S20 · Extend — extraction depends on parse evidencehttps://docs.extend.ai/extraction/overview · 2026-11-16
- S21 · LandingAI — ADE second generationhttps://landing.ai/blog/introducing-agentic-document-extraction-gen2 · 2026-11-16
- S22 · LlamaIndex — LlamaParse platformhttps://developers.llamaindex.ai/llamaparse/ · 2026-11-16
- S23 · Nanonets — document processing APIhttps://docs.nanonets.com/v4/reference/overview · 2026-11-16
- S24 · Mindee — extraction capabilitieshttps://docs.mindee.com/getting-started/key-features · 2026-11-16
- S25 · Instabase — validation rules and reviewhttps://docs.instabase.com/automate/validating-documents · 2026-11-16
- S26 · Unstructured — open-source document ETLhttps://github.com/Unstructured-IO/unstructured · 2026-11-16
- S27 · Mistral — OCR processorhttps://docs.mistral.ai/studio/document-processing/basic_ocr · 2026-11-16
- S28 · Amazon Textract — table structurehttps://docs.aws.amazon.com/textract/latest/dg/how-it-works-tables.html · 2026-11-16
- S29 · Google Document AI — OCRhttps://docs.cloud.google.com/document-ai/docs/enterprise-document-ocr · 2026-11-16
- S30 · OmniDocBench — benchmark and evaluation codehttps://github.com/opendatalab/OmniDocBench · 2026-11-16
- S31 · Rossum — automation criteriahttps://knowledge-base.rossum.ai/docs/guide-to-automation-process-in-rossum · 2026-11-16
- S32 · Datalab — document intelligence APIhttps://www.datalab.to/ · 2026-11-16
- S33 · Mozilla PDF.js — parsing and renderinghttps://mozilla.github.io/pdf.js/ · 2026-11-16
- S34 · Marker — model weight licensehttps://github.com/datalab-to/marker/blob/master/MODEL_LICENSE · 2026-11-16
- S35 · Google Document AI — layout parserhttps://docs.cloud.google.com/document-ai/docs/layout-parse-chunk · 2026-11-16