OCRとAI文書理解の全体像:原理、実装、フレームワークと企業
画素から検証可能な業務記録へ。ニューラルOCR、レイアウト、表、VLM、証拠と費用、公開フレームワーク、文書AI企業を体系的に比較する。
出典とバージョン
この記事の目次
1. 請求書から考える、システムの成果物
3ページのPDFに、デジタル請求書、撮影した押印済み追補、次ページに続く明細表が含まれるとします。利用者が欲しいのは編集可能なWord、照合できるExcel、会計システムへ渡せる項目です。画像から文字を読むだけでは、この仕事は終わりません。本稿は開発者と製品担当者向けに、入力から根拠付きデータまでを説明し、最後にローカル検証コードを示します。
OCRは文字認識、文書解析は段落・見出し・表・読順の復元、情報抽出は証拠をスキーマ項目へ対応付ける処理です。IDPは分類、検証、人手確認、連携まで含みます。PDFは容器であり、拡張子だけでOCRの必要性は決まりません。同じページにテキストとスキャン画像が混在する場合もあります。
| 層 | 入力 → 出力 | 主な失敗 |
|---|---|---|
| 認識 | 画素 → 文字・位置・スコア | 0/Oの混同、行の欠落 |
| 解析 | 領域と文字 → ブロック・セル・関係 | 二段組みの混線 |
| 抽出 | 証拠とスキーマ → 型付き項目 | 支払期限と発行日の混同 |
| 業務処理 | 検証済み記録 → 制御された操作 | 重複登録、誤送金 |
公式資料の確認日は2026年11月16日です。推奨は設計判断であり、全製品の統一比較実験ではありません。印刷文書、一般的な手書き、構造化抽出を対象とし、あらゆる古文書や真贋判定は扱いません。
2. 視覚モデルの前にファイルを調べる
デジタル生成PDFには文字オブジェクト、フォント対応表、位置が含まれます。ただし描画順は読順と異なり、文字対応の破損で文字化けすることもあります。スキャンは主に画像ですが、古いOCRの不可視テキストが残る場合があります。文字層があることは正しさの証明になりません。表示画像との一致、欠落、座標を確認します。
入力でバイト数、ページ数、展開後の画素数を制限し、暗号化や破損を処理してページ単位で経路を選びます。使える文字層は直接抽出し、スキャンは描画して認識します。PDF.jsはブラウザーのPDF表示と文字オブジェクト取得を担い、OCRモデルではありません。[S33]不審なファイルに備えてデコーダーを隔離します。
A4を300 DPIで描画すると約2480×3508画素、RGBAだけで約33.2 MiBです。10ページ同時保持ならモデルやコピーを除いて330 MiB超になります。アップロード上限と同時展開上限は別です。ページキュー、バッファ解放、復旧可能な進捗を設計します。高解像度は小文字を守りますが、撮影で失われた情報を拡大だけで確実に戻すことはできません。
3. OCRの認識過程
代表的な流れは方向・透視補正、文字検出、行の切り出し、系列認識、後処理です。二値化で小数点、ノイズ除去で細線が消えることもあります。原画像を残し、変換ごとに効果を測ります。
検出は「どこ」、認識は「何と書いてあるか」です。DBは領域分割の閾値学習を訓練へ組み込む方法です。[S3] CTC型の例ではH×W×3の行画像からT×d特徴を生成し、T×(|V|+1)の文字・blankスコアを出力します。他方式にこの形をそのまま当てはめてはいけません。
CTCは正解文字列へ畳み込める経路の確率を合計します。連続重複をまとめてからblankを除去するため、h,h,blank,iはhi、l,blank,lはllです。文字ごとの位置合わせは不要でも、画像と正しい転記の対は必要です。各時点の最大値を選ぶ貪欲復号は最良文字列を保証しません。[S2]
xは行画像、yは正解系列、πはblankを含む経路、Bは畳み込み、Tは視覚ステップ数、p_tは各時点のラベル確率です。損失は正解確率の負の対数です。 独自の2段階例:A/blankの確率を(0.6,0.4)、(0.5,0.5)とすると、AA、A blank、blank AはAになり、確率は0.3+0.3+0.2=0.8です。blank二つは0.2です。
現在のTesseractにもLSTMニューラル認識器があります。[S1] 新旧の差は単なるAIの有無ではなく、表現、構造、生成と検証にあります。
4. レイアウト、読順、表の復元
全ての文字が正しくても、二段組みを混ぜたり80.00を別の行へ結び付けたりすれば使えません。座標は場所を、関係は意味を表します。領域分類、ブロックの読順、表の行列・結合セル・見出し関係をそれぞれ復元します。
罫線表は交点を利用でき、罫線なし表は文字配置への依存が強くなります。ページをまたぐ表は列の意味、単位、繰り返し見出し、続表表示を確認します。単に列数が同じだけでは結合できません。複雑なセル結合はMarkdownよりHTMLやセルグラフが適し、Excelでは金額や日付の型も保持します。
中間表現にページ・ブロックID、種類、原文、座標系、読順、セル、出典版を残します。そこからWord、Excel、検索用データを生成します。編集しやすい再構成と原版の画素単位再現は別の目標です。固定テキストボックスは見た目を再現しても再編集を難しくします。
5. AI補助OCRの四つの形
第一はOCR後の訂正提案です。転記、候補字、部分画像を使います。言語知識は文章に有効でも、珍しい人名や番号を普通の語へ変える危険があります。自然さと忠実さは別です。原文、正規化値、訂正案を分離します。
第二は文字・位置・画像を結合する理解モデルです。LayoutLMv3は分類や項目認識の代表例で、OCR入力を必ず不要にするものではありません。[S4] 第三はDonutのような画像から構造化系列への生成です。独立OCR部品を省けても欠落、幻覚、分布変化への弱さは残ります。[S5]
第四は混成経路です。通常ページを軽量処理し、難しい領域だけ専門モデルやVLMで再読し、抽出と検証へ進みます。追加処理には費用と遅延があり、同じ偏りを持つモデルの一致は独立証明になりません。Agenticという名称より、再読回数と停止条件が重要です。
6. VLMが読める理由と作り足す理由
視覚言語モデルはページや切り出し画像を視覚トークンへ変換し、指示に従って文字、Markdown、JSONを生成します。分割や動的解像度は小文字とトークン予算を調整します。汎用モデルは多様な視覚課題、文書特化モデルは文字・数式・構造に重点を置きます。PaddleOCRにも文字認識、構造解析、文書VLMの異なる系列があります。[S6][S7]
DeepSeek-OCRとOCR 2は視覚表現と文字復元・圧縮を研究します。[S16][S17] 視覚トークン削減だけでは総費用削減を証明できません。描画、符号化、出力生成、再試行、確認まで計上します。強い圧縮は長い番号や稀な記号を損なう可能性があります。
忠実な転記では不明値をnullやuncertainにし、読めない内容を補完させません。解釈は別欄に置きます。JSON Schemaが保証するのは形であり、内容の真実性ではありません。
7. 項目には根拠、型、検証を付ける
金額に原文、型付き値、通貨、ページ、領域、ブロック、処理版、確認状態を付けます。座標の単位、原点、回転と原ページへの逆変換を明示します。
| 項目 | 例 | 目的 |
|---|---|---|
| raw / value | 1O80.00 / null | Oと0の曖昧さを維持 |
| evidence_id / page | g / 1 | 元資料へ戻る |
| bbox / coordinate_system | [0.6,0.8,0.9,0.84] / normalized_xyxy | 確認用ハイライト |
| model_version / schema_version | 固定識別子 | 再現とロールバック |
| status / reasons | review / ambiguous_digit | 保留理由 |
1,234と1.234は地域で意味が異なります。記号を除いて推測せず、Decimalと税・割引・丸め規則を使います。合計一致は真正性の証明ではありません。偽造書類でも数値は一致します。口座変更には独立確認と業務権限が必要です。
上流解析で値を落とした場合、抽出スキーマだけでは回復できません。原ページと解析結果を先に調べ、再認識か定義変更かを決めます。[S20]
8. 実製品の参照構成
ブラウザーはファイル選択、表示、品質案内、軽量OCR、明示的クラウド移行を担当します。サーバーは認証、テナント分離、有料資格、ページジョブ、キュー、モデル、証拠、検証、出力を管理します。無料経路の有料推論禁止はサーバーで強制します。
ページごとにqueued、processing、needs_review、completed、failedを保存し、期待ページ集合も記録します。再試行キーはテナント、内容、ページ、設定へ結び付けます。再認識は新版とし、タイムアウトでは非同期ジョブを照会してから再送します。キャンセルは未実行分を止め、発生済みの費用は報告します。
端末外へ送るページや切り出し範囲、キャッシュ、ログ、委託先保持、削除時点を説明します。証拠を全削除しながら永久追跡を約束できません。文書中の指示はデータであり、メール、ネット、送金の権限を与えません。
9. 優先して比較するフレームワーク
全言語・全機器・全レイアウトの共通最良はありません。以下は試験候補であり、統一順位ではありません。フレームワーク、重み、ランタイム、APIを区別します。
| 候補 | 比較する用途 | 判断点 |
|---|---|---|
| PaddleOCR:PP-OCR / PP-StructureV3 / VL | 多言語文字、構造、難領域 | 経路別の品質と費用 [S6][S7] |
| PaddleOCR.js | ブラウザー文字認識 | サーバー全解析機能とは別 [S8] |
| Tesseract / Tesseract.js | 鮮明な印刷、WASM基準 | JS版はPDFを先に描画 [S1][S9] |
| RapidOCR | CPU/ONNX等でのOCR運用 | 推論基盤であり業務処理ではない [S10] |
| Docling | 多形式の統一表現 | コードMIT、モデル別確認 [S11] |
| MinerU | 論文、数式、複雑PDF | 版・後段・重み条件を確認 [S12] |
| Marker + Surya | Markdown/JSON、混成処理 | コードApache-2.0、重み条件別 [S13][S14] |
| olmOCR | PDFのテキスト化・コーパス | 会計項目とは評価目標が違う [S15] |
| Unstructured | 分割とRAGデータ投入 | 項目・業務検証を追加 [S26] |
| Donut / LayoutLMv3 / DeepSeek-OCR | 研究、特定課題の調整 | 全製品機能を代替しない [S4][S5][S16] |
PaddleOCR.jsには公式文書がありますが、資産配信、Worker、実機互換性は別途試験します。[S8] Pythonで動くことはiPhoneの性能保証ではありません。Markerはコードと商用条件付き重みを区別し、古いforkの条件は古い可能性があります。[S34] commit、モデルカード、依存を固定します。
10. 文書AI企業は何を提供するか
初期企業から成長企業まで含み、資本関係、売上、シェアの順位ではありません。公開機能と、本文独自の調達確認事項を区別します。
| 企業・製品 | 公開された重点 | 確認事項 |
|---|---|---|
| Reducto | OCRとVLMの複数回処理 [S18] | 難ページの改善と追加費用 |
| Extend | 解析、抽出、分類、分割、フロー [S19] | 上流欠落の診断と再実行 |
| Datalab | 文書APIとMarker/Surya [S32][S13] | APIと自社運用の比較 |
| LandingAI ADE | 細粒度の出典位置 [S21] | 金額・セルの引用精度 |
| LlamaIndex / LlamaParse | Parse、Extract、Classify、Split、Index [S22] | RAG・版管理との接続 |
| Nanonets | 抽出と承認・確認API [S23] | 手作業と所要時間の削減 |
| Mindee | 設定可能項目、座標、信頼度 [S24] | 型と確認制御の適合 |
| Instabase | 企業文書アプリと検証 [S25] | 組織フローと配備要件 |
| Unstructured | 文書ETLとAIデータ準備 [S26] | 更新・削除・索引再構築 |
| Rossum | 取引文書の規則と自動化 [S31] | リスクに合う放行閾値 |
Mistral Document AIは専用サービスとして比較できます。Textractには表の関係、Google Document AIにはOCRとレイアウト経路があります。[S27][S28][S29][S35] 全てをOCRスタートアップと呼ぶのは不正確です。公開導入例と自社ランキングは、自分の受入データの代わりになりません。
11. 用途と顧客価値
基本認識が普及すると、価値は難資料、証拠、確認効率、業務接続へ移ります。本文の分析では、APIは導入と安定性、基盤は例外処理と組織導入、専門製品は業界スキーマと販路・成果で競います。製品ページだけで継続率や優位性は証明できません。
請求書は税・取引先・重複、銀行明細は貸借方向・残高連続性、保険は資料分割と不足、知識基盤は階層・読順・削除、アクセシビリティは読みやすさを重視します。検索に十分なMarkdownでも会計登録には不十分です。
チェック欄、取消線、変更履歴、脚注は意味を変えます。署名検出は署名認証ではありません。高影響用途には専門的確認が必要です。「何でも理解」ではなく、照合可能な取引や確認可能な項目を成果にします。
12. 品質と費用の分母
CERは置換・削除・挿入数を正解文字数で割り、100%を超えることもあります。Unicode、空白、句読点、大文字小文字の扱いを固定します。1080.00→1O80.00は1文字誤りでも金額は利用不能です。低CERと項目信頼性は同じではありません。
S/D/Iは置換・削除・挿入、N_refは正解文字数です。Nは入力件数、rはクラウド割合、hは人手割合、c_b/c_a/c_hは各単価、Fは固定費、N_validは検証通過件数です。
表構造、セル内容、読順、項目欠落、引用、型を測り、自動放行率とその中の誤り率を併記します。OCRスコアを項目正解確率と見なさず、言語・品質・種類別の保留データで校正します。OmniDocBenchは解析評価に役立ちますが業務試験を置き換えません。[S30]
仮定算例:月10000件、基礎$0.01/件、15%をクラウド$0.08、5%を人手$2、固定$380。合計$100+$120+$1000+$380=$1600、検証通過8000件なら$0.20/件です。クラウドと人手は重複し得て両方課金され、失敗も費用に残ります。推論単価だけでは総費用を表せません。実際の料金ではありません。
13. PageOCR型製品への具体案
Basicは有効な文字層を直接抽出し、スキャンはPaddleOCR.jsとTesseract.jsを実機比較します。ページキュー、キャンセル、部分再実行を用意し、無料利用者を黙って有料推論へ送らないことを強制します。配信・モデル取得・端末計算費用は残ります。
ProはPP-StructureV3、Docling、MinerU、Markerを自社表・レイアウトで比較し、少数の補完候補を維持します。Plusは制御されたVLM再読、抽出、検証を追加します。Webをエッジ配信しても、モデルが同じ実行環境に適するとは限りません。
銀行明細なら取引ごとの原資料、貸借と残高、期首+純変動=期末、型付き出力を揃えます。価値は訂正の少なさ、照合の容易さ、使える出力です。一つの形式群で成果を確かめてから拡張でき、基盤OCRモデルを最初から訓練する必要はありません。
14. 最小実装と選定試験
Python 3.11+標準ライブラリ実験は合成OCR出力を使い、画像推論やAPIを実行しません。NFC CER、証拠結合、座標、Decimal、口座変更の保留を実装します。正常記録はvalidated_candidateであり、支払権限ではありません。
別途Tesseract 5.5.0と英語データを用い、次の独自の鮮明な印刷画像を実際に認識しました。4行の番号・金額が正しく、空行も保持しています。1枚の合成画像での実エンジン確認であり、実際のスキャン・手書き・多言語精度の証明ではありません。
ocr-invoice-smoke.png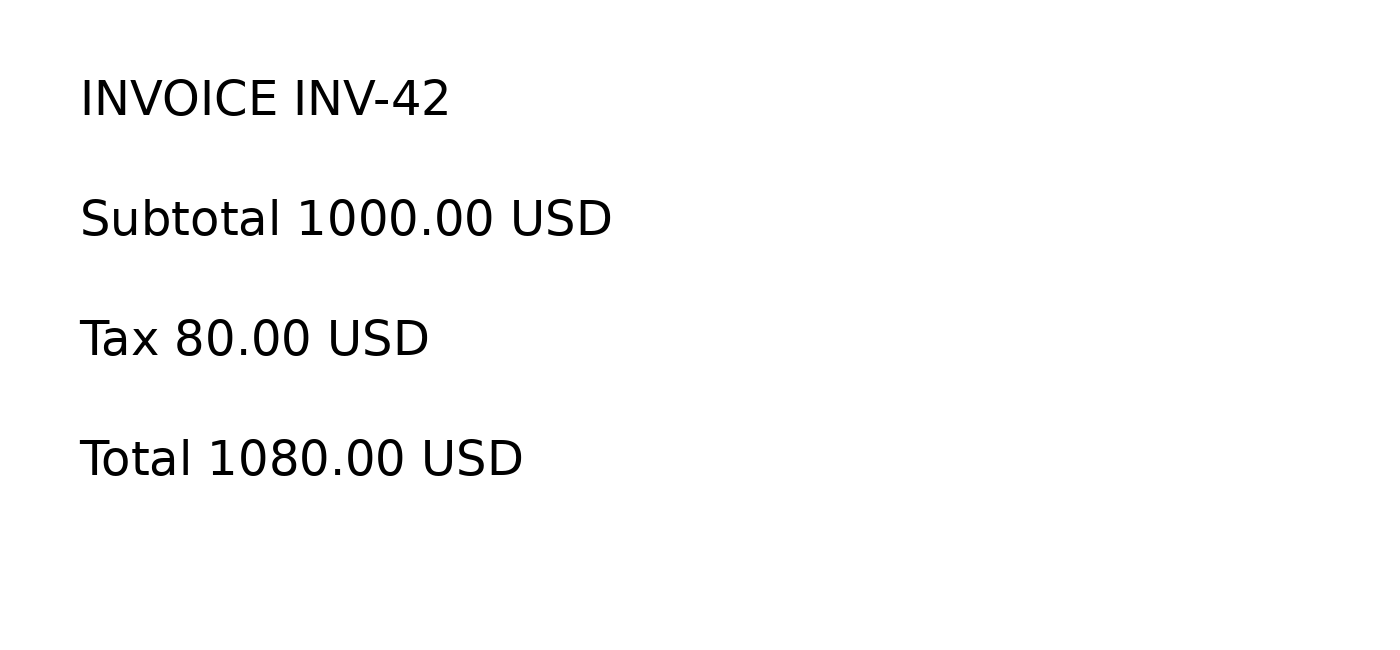
tesseract ocr-invoice-smoke.png stdout -l eng --psm 6INVOICE INV-42
Subtotal 1000.00 USD
Tax 80.00 USD
Total 1080.00 USDローカル検証 · Python 3.11+
ocr-evidence-gate.pypython3 ocr-evidence-gate.py期待出力
checks=11 clean=validated_candidate ambiguous=review cer=0.142857
synthetic_cost=1600.00 cost_per_validated_document=0.20
Python · ocr-evidence-gate.py
"""Python 3.11+, standard library. Synthetic OCR output, no image inference/API.
The gate checks provenance and arithmetic, not document authenticity.
"""
from decimal import Decimal, InvalidOperation
from copy import deepcopy
import unicodedata

def distance(a, b):
    row = list(range(len(b) + 1))
    for i, x in enumerate(a, 1):
        nxt = [i]
        for j, y in enumerate(b, 1):
            nxt.append(min(nxt[-1] + 1, row[j] + 1, row[j-1] + (x != y)))
        row = nxt
    return row[-1]

def cer(reference, prediction):
    # NFC Unicode code points; whitespace and case remain significant.
    a, b = (unicodedata.normalize('NFC', x) for x in (reference, prediction))
    if not a:
        raise ValueError('CER requires a nonempty reference')
    return distance(a, b) / len(a)

def validate(record, evidence):
    reasons = []
    values = {}
    for name in ('subtotal', 'tax', 'total'):
        field = record.get(name, {})
        source = evidence.get(field.get('evidence_id'))
        if not source or field.get('raw') != source.get('text'):
            reasons.append(name + ':missing_or_changed_evidence')
            continue
        bbox = source.get('bbox', [])
        if (source.get('page', 0) < 1 or len(bbox) != 4
            or not all(isinstance(x, (int, float)) and 0 <= x <= 1 for x in bbox)
            or not (bbox[0] < bbox[2] and bbox[1] < bbox[3])):
            reasons.append(name + ':invalid_source_region')
        # Fixed fixture convention: dot decimal, USD, no grouping separators.
        try:
            value = Decimal(field['raw'])
            if not value.is_finite() or value < 0 or value.as_tuple().exponent < -2:
                raise InvalidOperation
            values[name] = value
        except (InvalidOperation, ValueError, TypeError):
            reasons.append(name + ':unresolved_numeric_text')
    if record.get('currency') != 'USD':
        reasons.append('currency:unsupported')
    if record.get('account_changed'):
        reasons.append('account_change:independent_verification_required')
    if len(values) == 3 and values['subtotal'] + values['tax'] != values['total']:
        reasons.append('amounts:inconsistent')
    return ('review' if reasons else 'validated_candidate'), reasons

E = {k: {'text': v, 'page': 1, 'bbox': [0.6, y, 0.9, y + .04]}
     for k, v, y in [('s', '1000.00', .6), ('t', '80.00', .7), ('g', '1080.00', .8)]}
R = {'currency': 'USD', 'account_changed': False,
     **{n: {'raw': E[k]['text'], 'evidence_id': k}
        for n, k in [('subtotal', 's'), ('tax', 't'), ('total', 'g')]}}

def main():
    assert validate(R, E)[0] == 'validated_candidate'
    wrong = deepcopy(R); wrong['total']['raw'] = '1090.00'
    assert validate(wrong, E)[0] == 'review'  # invented correction has no evidence
    ambiguous = deepcopy(R); ambiguous['total']['raw'] = '1O80.00'
    ambiguous_e = deepcopy(E); ambiguous_e['g']['text'] = '1O80.00'
    assert validate(ambiguous, ambiguous_e)[0] == 'review'  # never guess O -> 0
    bad_sum_e = deepcopy(E); bad_sum_e['g']['text'] = '1090.00'
    bad_sum = deepcopy(R); bad_sum['total']['raw'] = '1090.00'
    assert validate(bad_sum, bad_sum_e)[0] == 'review'  # evidence exists, sum fails
    missing = deepcopy(R); missing['total']['evidence_id'] = 'not-found'
    assert validate(missing, E)[0] == 'review'
    changed = deepcopy(R); changed['account_changed'] = True
    assert validate(changed, E)[0] == 'review'
    bad_box = deepcopy(E); bad_box['g']['bbox'] = [.9, .8, .6, .7]
    assert validate(R, bad_box)[0] == 'review'
    nonfinite = deepcopy(R); nonfinite['total']['raw'] = 'NaN'
    nonfinite_e = deepcopy(E); nonfinite_e['g']['text'] = 'NaN'
    assert validate(nonfinite, nonfinite_e)[0] == 'review'
    assert cer('1080.00', '1O80.00') == 1 / 7
    assert cer('café', 'cafe\u0301') == 0
    print('checks=11 clean=validated_candidate ambiguous=review cer=0.142857')
    print('synthetic_cost=1600.00 cost_per_validated_document=0.20')
    assert Decimal(10000) * Decimal('.01') + Decimal(10000) * Decimal('.15') * Decimal('.08') + Decimal(10000) * Decimal('.05') * Decimal('2') + Decimal('380') == Decimal('1600')
    # A real deployment also needs authentication, anti-tamper checks, taxes/rounding
    # rules, independent payment authority and immutable source versioning.
if __name__ == '__main__':
    main()
実資料ではDoclingのDocumentConverterでPDFを変換し、証拠形式へ適応できます。ブラウザーSDKは描画済み画像を扱います。以下は公式文書に基づく導入例で、本確認ではモデル取得や有料APIを実行していません。配備前に版を固定します。[S8][S11]
公式文書を基にした接続例 · 本確認では未実行
from docling.document_converter import DocumentConverter

# Install docling in an isolated environment; pin the tested version.
converted = DocumentConverter().convert("sample.pdf")
markdown = converted.document.export_to_markdown()
# Adapt structured document items and provenance separately for field review.
import { PaddleOCR } from "@paddleocr/paddleocr-js";
// Pass a rendered page image (Blob), not raw PDF bytes.
const engine = await PaddleOCR.create({
lang: "ch", ocrVersion: "PP-OCRv5",
ortOptions: { backend: "wasm" }
});
try {
const [page] = await engine.predict(pageImageBlob);
console.log(page.items);
} finally {
engine.dispose();
}評価を取引先・テンプレート、言語、端末、時期で分け、同じ原本・予算で直接抽出、OCR、構造解析、VLM、混成を比較します。取得量、初回起動、最大メモリ、p95、誤放行と費用を記録します。数百ページで重要故障を網羅してからリスクに応じて拡張し、万能の必要枚数は主張しません。
空白、淡い小数点、回転、二段組み、跨頁表、多言語、手書き重なり、誤文字層、重複、部分故障、偽証拠、口座変更、悪意ある指示を含めます。演習:99%文字精度で金額を保証できない理由、ページ単位再試行、同予算で全量VLMと選択再読の比較、保留データによる閾値と放行率・誤り率を説明してください。自分の資料で信頼性を確かめてから最良候補を決めます。
予測・検証・根拠の記録
解答を開く前に結果を予測し、演習後に差異と応用テストを記録します。端末内に保存し、言語版間で共有します。
記録を開く/書き出す/消去する →数学的確認の範囲は授業ごとに記録されています。論文の実証再現の証明ではありません。疑問点はメモに記録してください。 確認範囲
一次資料と関連学習
資料確認:2026年11月16日。製品機能は公式文書、推奨は編集上の判断です。統一ベンダー比較は未実施。実験入力は合成OCR出力です。
- S1 · Tesseract documentation — neural OCRhttps://tesseract-ocr.github.io/tessdoc/ · 2026-11-16
- S2 · Graves et al., CTC — ICML 2006https://www.cs.toronto.edu/~graves/icml_2006.pdf · 2026-11-16
- S3 · Differentiable Binarization — AAAI 2020 / arXiv v2https://arxiv.org/abs/1911.08947v2 · 2026-11-16
- S4 · LayoutLMv3 — official implementation, 2022https://github.com/microsoft/unilm/tree/master/layoutlmv3 · 2026-11-16
- S5 · Donut — OCR-free document understanding, ECCV 2022https://github.com/clovaai/donut · 2026-11-16
- S6 · PaddleOCR 3.0 Technical Report — 2025https://arxiv.org/abs/2507.05595 · 2026-11-16
- S7 · PaddleOCR — official repositoryhttps://github.com/PaddlePaddle/PaddleOCR · 2026-11-16
- S8 · PaddleOCR.js — official browser deploymenthttps://github.com/PaddlePaddle/PaddleOCR/blob/main/docs/version3.x/inference_deployment/cross_platform/browser.en.md · 2026-11-16
- S9 · Tesseract.js — README and PDF limitationhttps://github.com/naptha/tesseract.js · 2026-11-16
- S10 · RapidOCR — runtime toolkithttps://github.com/RapidAI/RapidOCR · 2026-11-16
- S11 · Docling — conversion and separate model licenseshttps://github.com/docling-project/docling · 2026-11-16
- S12 · MinerU — official document parserhttps://github.com/opendatalab/MinerU · 2026-11-16
- S13 · Marker — modes, hybrid processing and licensinghttps://github.com/datalab-to/marker · 2026-11-16
- S14 · Surya — OCR and layouthttps://github.com/datalab-to/surya · 2026-11-16
- S15 · olmOCR — PDF linearization toolkithttps://github.com/allenai/olmocr · 2026-11-16
- S16 · DeepSeek-OCR — optical compression research, 2025https://arxiv.org/abs/2510.18234 · 2026-11-16
- S17 · DeepSeek-OCR 2 — Visual Causal Flow, 2026https://arxiv.org/abs/2601.20552 · 2026-11-16
- S18 · Reducto — product architecture overviewhttps://reducto.ai/ · 2026-11-16
- S19 · Extend — parsing and extraction platformhttps://docs.extend.ai/ · 2026-11-16
- S20 · Extend — extraction depends on parse evidencehttps://docs.extend.ai/extraction/overview · 2026-11-16
- S21 · LandingAI — ADE second generationhttps://landing.ai/blog/introducing-agentic-document-extraction-gen2 · 2026-11-16
- S22 · LlamaIndex — LlamaParse platformhttps://developers.llamaindex.ai/llamaparse/ · 2026-11-16
- S23 · Nanonets — document processing APIhttps://docs.nanonets.com/v4/reference/overview · 2026-11-16
- S24 · Mindee — extraction capabilitieshttps://docs.mindee.com/getting-started/key-features · 2026-11-16
- S25 · Instabase — validation rules and reviewhttps://docs.instabase.com/automate/validating-documents · 2026-11-16
- S26 · Unstructured — open-source document ETLhttps://github.com/Unstructured-IO/unstructured · 2026-11-16
- S27 · Mistral — OCR processorhttps://docs.mistral.ai/studio/document-processing/basic_ocr · 2026-11-16
- S28 · Amazon Textract — table structurehttps://docs.aws.amazon.com/textract/latest/dg/how-it-works-tables.html · 2026-11-16
- S29 · Google Document AI — OCRhttps://docs.cloud.google.com/document-ai/docs/enterprise-document-ocr · 2026-11-16
- S30 · OmniDocBench — benchmark and evaluation codehttps://github.com/opendatalab/OmniDocBench · 2026-11-16
- S31 · Rossum — automation criteriahttps://knowledge-base.rossum.ai/docs/guide-to-automation-process-in-rossum · 2026-11-16
- S32 · Datalab — document intelligence APIhttps://www.datalab.to/ · 2026-11-16
- S33 · Mozilla PDF.js — parsing and renderinghttps://mozilla.github.io/pdf.js/ · 2026-11-16
- S34 · Marker — model weight licensehttps://github.com/datalab-to/marker/blob/master/MODEL_LICENSE · 2026-11-16
- S35 · Google Document AI — layout parserhttps://docs.cloud.google.com/document-ai/docs/layout-parse-chunk · 2026-11-16